AI没有记忆:理解Token成本与上下文管理的核心逻辑

AI没有记忆,每步都重发全部上下文,成本约等于步数乘以信息包大小。
文章用一个生动的"复印机"比喻揭示了大语言模型的工作真相:AI并不具备记忆,你在对话中感受到的"记得",其实是工具在每次交互时把从对话开始到当前的全部内容重新发送给模型。这一机制决定了成本的本质——成本 ≈ 步数 × 信息包大小,而非来自某一条消息。在Agent模式下,读文件、运行命令等每一步都会重新复制不断膨胀的信息包,一个请求可能触发上百步,累计输入可达千万级Token。更严重的是,信息包越大,模型越难识别关键指令,精确度随之下降;工具虽会通过压缩机制腾出空间,但摘要必然丢失细节。文章建议通过Cursor的上下文计量表(或Claude Code的/context命令)监控占用,超过50%即应采取行动,所有良好使用习惯归根结底都是在减少步数、缩小信息包或降低单步成本。
很多人在使用AI对话工具时,会产生一种错觉:它似乎记得十分钟前说过的话。但真相是,AI根本没有记忆。你感受到的"记忆",其实是工具在每一次交互时,把从对话开始到现在的全部内容重新发送了一遍。理解这一点,是理解Token成本、上下文窗口以及一切AI使用技巧的基础。
AI的"失忆症"与复印机模型
把AI想象成一位才华横溢但患有完全失忆症的顾问。每问一个问题,他都会忘掉之前的一切。为了让他正确回答,你不得不把整份案卷重新交给他——包括你的指令、已经读过的文件、以及他之前给出的每一条回复。
这就像一台复印机:第一个问题,复印10页;第十个问题,文件变成100页,你复印全部100页;第三十个问题,300页,依然整份复印。成本不是来自第一条消息,而是来自这个不断膨胀、并被反复复制的信息包。
Token(词元) 是大语言模型处理文本的基本单位,也是计费的基本单位。一个Token大致对应英文的一个单词或词根、中文的1~2个汉字,具体切分方式由模型的分词器决定。模型本身并不理解字符,它把输入文本切分为Token序列后,转换为向量进行计算,输出时再逐个Token生成。因此所说的"信息包大小",实际就是发送给模型的Token总数(输入Token)。
上下文窗口(Context Window) 是模型单次能接收的最大Token数量,不同模型的窗口上限各异,常见为几十万Token。它是一个硬性上限:一旦对话或Agent的信息包接近该上限,工具就必须截断或摘要历史内容才能继续,这正是后文"压缩"机制出现的根本原因。理解上下文窗口,才能明白为什么"复印机"里的文件不可能无限增厚。
Agent模式放大问题:步数越多,成本越高
在Agent模式下,这个问题会被急剧放大。AI会向自己提问:读一个文件是一步,运行一条命令是另一步,重新读取结果又是一步。每一步都会把完整的信息包再次送进复印机,再加上它刚刚读到的内容。你发出的一个请求,可能触发20步、50步,甚至超过100步的复制。
据Cursor论坛上的一个真实案例,一位开发者只发了一条消息,要求在整个项目中升级React。Agent执行了155步,每一步都在重发一个越来越大的信息包,最终单步达到18万Token,累计输入超过1100万Token——而这一切只源于一条消息。
因此,整个课程只有一个核心公式:成本 ≈ 步数 × 信息包大小。
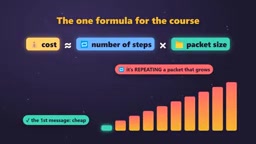
所有好的使用习惯,本质上都在做三件事之一:减少步数、缩小信息包、或降低单步成本。
信息包越大,AI反而越不精确
成本之外,还有一个同样重要的问题:信息包越厚,Agent的精确度越低。AI速度变快时,它很难从海量内容中识别出真正关键的部分。对话开头的一条指令,可能被淹没在数百页内容之下。
当信息包过大时,工具会自动摘要以腾出空间,这就是压缩(compaction)。它很实用,但摘要必然会丢失细节。所以,轻量的信息包不仅更省钱,还能带来更好的结果。
压缩(compaction) 具体是如何工作的?当输入Token接近上下文窗口上限时,工具会调用模型本身对较早的对话历史生成一段摘要,用这段摘要替换原始内容,从而释放空间给新的交互。这个过程通常对用户透明,但有两层代价:一是摘要由模型生成,可能遗漏或扭曲关键约束(如某个具体版本号、某条特殊要求);二是摘要本身也需要消耗一次模型调用,计入成本。
值得注意的是,压缩往往发生在信息包已经很大的时候,而大信息包本身就已经降低了模型的精确度——也就是说,压缩是"补救"而非"优化"。主动控制信息包大小(如及时开启新会话、清理无关文件),比依赖自动压缩更可靠。
如何查看你的上下文占用
好消息是,这个信息包是可见的。在Cursor中,输入框旁边有一个小圆环,那就是上下文计量表。点击它,你可以清楚看到是什么填满了它:基础指令、规则、可用工具、连接器以及对话内容。你会发现,只发了一条消息,信息包可能已经很满了——有些内容在你开始工作之前就已经被填入了。
在Claude Code中,对应命令是/context;在anti-gravity中,则位于设置里。
Cursor团队推荐的一条简单规则是:占用超过50%就该采取行动。超过这个阈值,每一步都更贵,AI也更不准确。课程中有一个例子:Leah查看自己的计量表,发现占用已达85%,而信息包里还留着周一的bug,尽管她已经花了一小时处理文档。她每条消息都在为这个包付费,而它正在让她的文档回答变得模糊。
Agent(智能体)模式 与普通对话的关键区别在于:模型可以自主调用工具(读文件、执行命令、搜索、编辑代码等),并根据工具返回的结果决定下一步行动,形成"思考—行动—观察"的循环。每一轮循环(即"一步")都需要把完整的对话历史连同新的工具结果一起重新发送给模型。
这意味着Agent的步数并非由用户直接控制,而是由任务复杂度、工具反馈质量和模型的规划能力共同决定。一个模糊的指令可能让Agent反复试错,导致步数暴涨;而清晰的指令、明确的文件范围和可验证的目标,则能显著压缩步数。这正是后文"减少步数"这一优化方向的具体抓手。
核心结论
AI没有记忆;整个信息包在每一步都会被重新发送;成本等于步数乘以信息包大小;而计量表告诉你当前所处的状态。掌握这三个认知,你就能在日常使用中做出更聪明的选择——更少的步骤、更小的信息包、更高的准确性。
相关推荐
《谢谢你的爱》英文版走红B站:经典情歌的跨文化演绎
B站热传的《谢谢你的爱》英文版《I'll give you all my love》,通过重新填词诠释“给予全部的爱”的主题。本文分析其歌词情感表达、跨文化改编策略以及与中文原版的情感逻辑差异,探讨经典华语歌曲英文改编的传播价值。
Claude Code vs Cursor vs GitHub Copilot:三大AI编程工具怎么选
用「放权程度」一个维度讲清 Claude Code、Cursor 与 GitHub Copilot 的区别:Copilot 嵌入现有编辑器做补全,Cursor 是以AI为核心的完整编辑器并支持多文件批量修改,Claude Code 在终端里端到端执行任务。附选择建议。
动态漫解说爆款背后:家庭财务与情感冲突的叙事拆解
从B站动态漫《CC-动态漫》的一集家庭财务冲突剧情出发,拆解动态漫如何用高密度对话和情绪钩子抓住观众,并分析AI辅助脚本生成在叙事连贯性上的短板与人工把关的价值。