AI能力悖论:为何更强的模型反而带来更高的系统风险
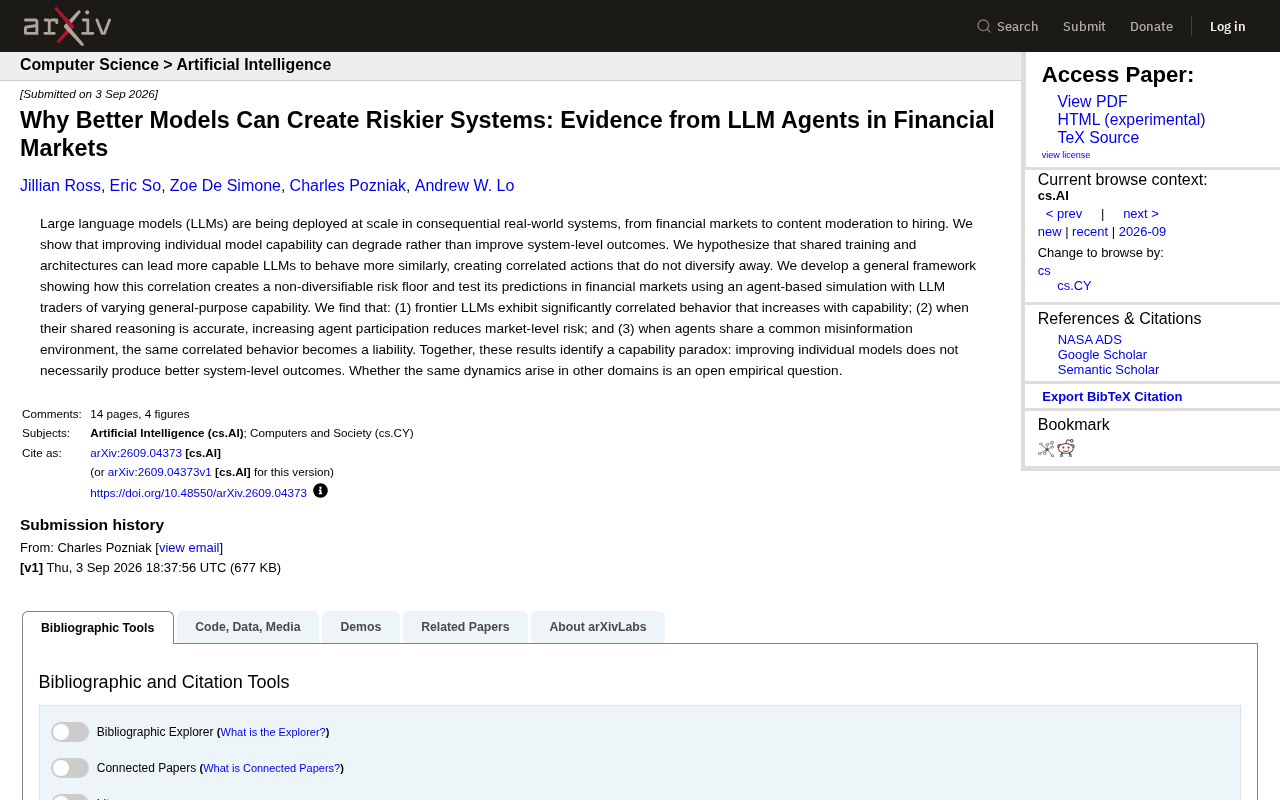
更强的AI模型因行为趋同而产生不可分散的系统性风险,挑战"性能越强越安全"的传统假设。
来自arXiv的研究论文揭示了AI规模化应用中的"能力悖论":更强大的LLM因共享训练数据和相似架构,会表现出更高的行为一致性,从而在系统层面制造出无法通过多样化部署消除的风险底线。研究通过金融市场智能体仿真实验发现,前沿模型在准确信息环境下可降低市场风险,但在共同错误信息环境中会集体误判、成倍放大错误。这一发现要求AI从业者将评估视角从"单个模型性能"转向"多模型并行部署时的系统行为",并在系统设计中主动引入架构多样性、断路器机制等风险管理手段。
LLM大规模应用正在制造一种新型风险
大语言模型(LLM)正在金融市场、内容审核、招聘筛选等关键领域大规模落地。人们通常认为,提升单个模型的能力自然会带来系统整体表现的改善。然而,arXiv上发布的研究论文《Why Better Models Can Create Riskier Systems》直接挑战了这一假设,提出了一个反直觉的发现:更强大的AI模型可能导致系统层面的风险上升,而非下降。
这项由多位学者合作完成的研究,通过金融市场的智能体模拟实验,揭示了AI系统在规模化应用中面临的"能力悖论"(Capability Paradox)。研究团队的核心假设是:共享的训练数据和相似的架构,会导致能力更强的LLM之间表现出更高的行为一致性,进而产生无法通过多样化策略消除的系统性风险。
相关性风险的三重关键证据
研究团队搭建了一个由不同能力等级LLM交易智能体组成的金融市场仿真系统,实验产出了三组核心发现。
前沿模型的行为呈现高度趋同
实验数据表明,frontier级别的LLM展现出显著的行为相关性,而且这种相关性随模型能力的提升而增强。换句话说,当多个先进AI系统同时运行时,它们极有可能做出高度一致的决策。放在金融市场的语境下,这种"集体行动"足以引发极端的市场波动。
准确推理条件下的风险分散效应
当LLM智能体共享的推理逻辑本身是准确的,增加智能体的参与度实际上能够降低市场整体风险。这与传统金融理论中的多样化原理一致——当所有参与者都基于正确的信息做出决策时,市场会更加稳定和高效。
错误信息环境下的系统性崩溃
但当智能体处于共同的错误信息环境中,局面完全反转。原本有利的相关行为变成了系统性负债。所有智能体基于相同的错误前提做出相似决策,错误被成倍放大而非自我纠正,形成"集体误判"的危险连锁反应。
不可分散风险:能力悖论的理论根基
研究提出了一个通用理论框架,解释相关性如何制造出"不可分散风险底线"(non-diversifiable risk floor)。
传统风险管理理论的核心逻辑是:增加独立决策主体的数量就能有效分散风险。但当这些决策主体之间高度相关时,这套机制从根本上失效了。
驱动这一现象的关键机制包括:
- 共享训练数据导致模型学习到相似的特征表示
- 相似的架构设计使模型产生趋同的推理路径
- 在极端场景下,所有模型同时犯下相同错误的概率大幅上升
这种现象在金融领域尤其值得警惕。2008年金融危机的部分成因,正是各大金融机构使用了相似的风险评估模型,集体低估了次贷风险。AI时代的"模型同质化"有可能重演类似的系统性危机。
对AI安全应用的深远启示
评估标准必须超越单一模型性能
这项研究最核心的启示在于:衡量AI系统的安全性,不能只盯着单个模型的能力指标。我们需要建立全新的评估框架,重点考察以下维度:
- 多模型并行部署时的行为相关程度
- 系统面对共同错误信息时的抗干扰能力
- 压力场景下多个模型的集体表现
在系统设计中主动引入多样性
为了缓解能力悖论带来的风险,AI系统的设计思路需要做出调整,主动构建多样性:
- 采用不同架构和训练方法的模型进行组合部署
- 设计激励机制,引导智能体采取差异化策略
- 建立"断路器"机制,用于检测并阻断集体误判行为
这是一个跨领域的普遍性问题
论文特别指出,同样的动态机制是否会在内容推荐、医疗诊断、自动驾驶等其他领域复现,是一个亟待验证的开放性实证问题。随着AI在关键基础设施中的渗透程度不断加深,这个问题的答案将直接影响我们推进AI应用的安全策略。
未来研究的四个关键方向
这项研究为AI安全研究打开了一个新的维度。后续工作可能沿以下路径展开:
- 真实场景验证:在实际业务环境中检验能力悖论是否成立
- 对抗性多样性设计:探索在保持模型性能的前提下增加行为多样性的方法
- 监管框架建设:为高风险领域的AI部署制定相关性管理规范
- 实时监测工具:开发能够持续追踪AI系统行为相关性的监控工具
从"模型有多好"到"系统有多稳"
这项研究揭示了AI规模化应用中一个极易被忽视的风险维度。在追求更强大AI模型的过程中,我们必须对"能力提升"可能带来的意外后果保持警觉。真正安全的AI系统,不仅需要单个模型的卓越性能,更需要系统层面的风险管理机制和多样性设计。
对于AI从业者来说,这意味着评估视角需要发生根本转变:从"我的模型有多好"转向"我的模型与其他模型一起部署时会发生什么"。只有完成这个思维转换,我们才能在充分利用AI效率优势的同时,有效规避潜在的系统性风险。
相关推荐
Firebase 8月更新:AI Logic 安全升级与 CLI Agent 模式详解
Firebase 8月版本更新详解:AI Logic 默认开启 App Check 安全防护、新增 Gemini 模型与 TTS,Firebase CLI 支持 AI Agent 非交互模式,Firestore 安全规则可视化管理,以及 Extensions 与 Firebase ML 的弃用迁移路径。
无需写代码:用Microsoft Foundry门户搭建你的第一个AI智能体
无需编写代码,使用Microsoft Foundry门户从零搭建生产就绪的AI智能体:部署模型、构建agent、接入MCP工具、检查traces追踪并运行评估的完整可视化流程。
微软四大IQ详解:为AI智能体提供上下文的接地能力
微软 Build 推出的 Foundry IQ、Fabric IQ、Work IQ、Web IQ 四大能力究竟是什么?本文解析这四种接地能力如何分别为 AI 智能体提供知识、业务数据、办公应用与实时网络的上下文支持。