AI爬虫视角:robots.txt、状态码与无JS渲染审计指南

用一套小脚本审计三类 AI 爬虫拦截点,让内容被 ChatGPT 等真正读到。
文章指出,许多站点在 Google 排名良好,却不出现在 ChatGPT 或 Perplexity 的回答中,原因通常不是内容质量,而是 AI 爬虫与页面之间的技术链路被阻断。作者提出一套小型审计脚本,覆盖三类最常见拦截点:robots.txt 逐 AI user agent 的禁用规则、CDN/WAF 在 robots.txt 之前就实施的拦截、以及离开 JavaScript 就不存在的内容。文章强调按训练、搜索索引、用户触发三类 agent 差异化配置的必要性,指出本机伪造 user agent 测试存在 IP 验证盲区,需结合 CDN 与源站日志交叉确认,并给出以"原始/渲染词数比"量化 JS 依赖、通过 SSR 或构建期预渲染修复的路径。最后明确边界:通过可达性检查仅代表爬虫能读到页面,是否被引用仍取决于结构、schema 与信任信号。
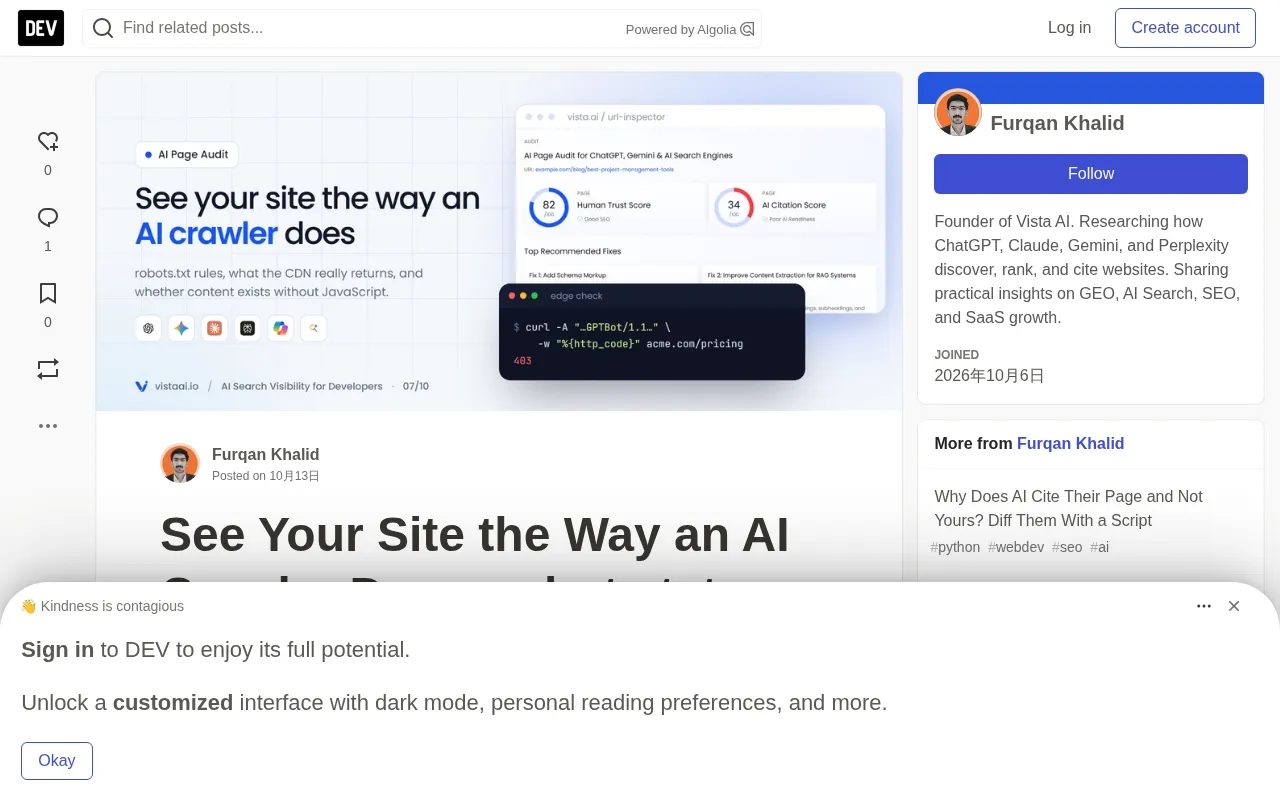
很多站点在 Google 排名不错,却从不出现在 ChatGPT 或 Perplexity 的回答里。问题往往不在内容质量,而在 AI 爬虫与页面之间的技术链路——某处"说了不",或者只返回了一个空壳。
Google 花二十年学会了容忍混乱的站点,并且会执行 JavaScript;多数 AI 爬虫没那么宽容。这篇文章给出一套小型审计脚本,覆盖三类最常见的拦截点:robots.txt 禁用了 AI user agent、CDN/WAF 在 robots.txt 之前就拦截、以及内容离开 JavaScript 就不存在。
检查一:逐 AI user agent 核对 robots.txt
Python 标准库可以按 user agent 评估 robots.txt 规则。把训练类、搜索索引类、用户触发类 agent 分开处理,是整套审计的基础。
from urllib.robotparser import RobotFileParser
from urllib.parse import urljoin, urlparse

AI_AGENTS = [
    # training
    "GPTBot", "ClaudeBot", "CCBot", "Google-Extended", "Applebot-Extended",
    # search indexing
    "OAI-SearchBot", "Claude-SearchBot", "PerplexityBot",
    # user-triggered fetches
    "ChatGPT-User", "Claude-User", "Perplexity-User",
]
有两个坑需要留意。RobotFileParser 遵循的是早期 robots.txt 约定,并未实现 RFC 9309 的全部细节,比如 Allow 与 Disallow 之间的最长匹配优先规则,遇到边界情况需要用 Google 开源的 robotstxt 库复核。另外,部分厂商文档指出用户触发的 agent 未必像爬虫那样遵循 robots.txt,因为请求由真人发起——这类策略要以各厂商 bot 文档的当前说明为准。
按用途而非按情绪做决定
训练、搜索、用户触发三类 agent 分开,实际价值在于可以做差异化配置:屏蔽训练,同时放行用于实时问答的抓取。
**RFC 9309:robots.txt 的现行规范**

RFC 9309 由 IETF 于 2022 年发布,是 robots.txt 协议的第一个正式标准,取代了此前仅有事实约定、无正式规范的状态。它明确了若干长期存在争议的细节:user agent 匹配采用子串匹配且区分大小写;多条规则冲突时以最长匹配路径优先,长度相同时 Allow 优先于 Disallow;按字节而非字符比较路径;以及爬虫在无法获取 robots.txt(如 5xx)时应采取的保守策略。Python 标准库的 `RobotFileParser` 诞生于这一规范之前,实现的是较宽松的早期语义,因此在处理通配符 `*`、`$` 结尾符和 Allow/Disallow 冲突时可能与 Google、Bing 等主流实现产生分歧。排查 AI 爬虫可达性时,如果边界规则是你的关键配置,建议用 Google 开源的 `robotstxt` 库或直接调用厂商的 robots.txt 测试工具交叉验证。

**AI 爬虫 user agent 的三类划分**

区分训练、搜索索引、用户触发三类 agent,是制定内容策略的前提。训练类(GPTBot、ClaudeBot、CCBot、Google-Extended、Applebot-Extended)用于构建或更新大模型语料,抓取行为通常与用户请求无关。搜索索引类(OAI-SearchBot、Claude-SearchBot、PerplexityBot)为 AI 搜索产品建立索引,其抓取结果直接决定你能否出现在 AI 答案的检索候选集中。用户触发类(ChatGPT-User、Claude-User、Perplexity-User)由真人提问实时发起,抓取是单次、按需的。三者对业务的含义截然不同:屏蔽训练通常无损于流量,而屏蔽搜索索引类 agent 等于主动退出 AI 答案的竞争,屏蔽用户触发类则可能让用户在你的页面上得到"无法访问"的失败体验。
# robots.txt
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: OAI-SearchBot
User-agent: Claude-SearchBot
User-agent: PerplexityBot
Allow: /
这里有一个容易被混淆的条目:Google-Extended 控制的是 Google 能否将你的内容用于 Gemini 模型训练与 grounding,它并不影响 Google Search 或 AI Overviews,后者使用的是常规 Googlebot。把这两件事等同起来,会做出错误的内容策略。
检查二:边缘节点到底返回了什么
robots.txt 只是建议性文件。真正决定返回什么的是 CDN 或 WAF,而不少 bot 防护产品现在默认就会拦截或质询 AI 爬虫。
做法是带上各家的 user agent 去请求页面,观察状态码和响应体大小。判断的关键是与浏览器那一行做对比:如果 browser 拿到 200 和 80 KB,而 GPTBot 拿到 403,或者只得到 6 KB 的质询页,说明边缘在拦它。
这个测试有一个必须说明的局限:脚本从你自己的 IP 发送伪造的 user agent。一些 CDN 通过 IP 验证 bot,可能拦掉你的假 GPTBot 却放行真的;反过来,一份 allowlist 也可能让你的测试通过却仍然挡住真实爬虫。因此本地出现的"拦截"只是强提示,需要结合两处证据确认——CDN 的 bot 或防火墙事件日志(按这些 user agent 过滤),以及源站访问日志中带真实 IP 验证的命中记录与状态码。
CDN/WAF 的 bot 防护与 AI 爬虫
Cloudflare、Akamai、Fastly、AWS WAF 等边缘产品近几年普遍引入了 bot 管理模块,通过 TLS 指纹(JA3/JA4)、HTTP/2 帧特征、请求头顺序、IP 信誉和行为模式综合判定来访者身份。默认配置下,许多产品会把已知 AI 爬虫列入"已识别 bot"类别并施加质询(返回 403、429 或一段 JS 挑战页),而非直接放行。这带来一个隐蔽后果:网站管理员可能在 robots.txt 中明确 Allow 了某个 agent,却不知道边缘层正在把它挡在门外。排查时应按 user agent 分别请求目标 URL,记录状态码、Content-Length 与响应体特征;若某 agent 拿到的是远小于正常页面的 HTML,大概率是被塞了质询页。最终确认需要结合 CDN 的 bot 事件日志与源站日志,因为边缘拦截往往不会在源站留下痕迹。
检查三:没有 JavaScript 时内容还在吗
这是现代前端上最常见、也最安静的失败。如果主体内容是客户端拉取并渲染的,不执行 JS 的爬虫看到的只是一个 <div id="root"></div> 加一堆 bundle。
做法是对比原始 HTML 与浏览器渲染结果。must_contain 应当填入几段你确知存在于主体内容中的句子:价格、产品描述、页面核心问题的答案。如果这些内容在原始 HTML 里缺失,那么不渲染 JS 的 AI 抓取器就看不到它们。
再加一层 Playwright 渲染对比后,可以用一个比例来量化:内容页的"原始/渲染词数比"明显低于约 0.8,意味着相当一部分内容依赖 JavaScript。
修复路径
针对不同技术栈,处理方式不同:
- Next.js / Nuxt / SvelteKit / Astro:确保内容页走 SSR 或静态生成,而不是在
useEffect/onMounted里做纯客户端拉取。在 Next.js App Router 中,Server Components 默认在服务端渲染;最常见的错误恰恰是标注了"use client"的页面在挂载后才去取内容。 - 没有 SSR 方案的 SPA:在构建期对内容路由做预渲染。
- 标签页、手风琴、"阅读更多":把文本留在 DOM 里,用 CSS 隐藏,而不是点击时才加载。
SSR、SSG 与预渲染的区别
服务端渲染(SSR)指每次请求时由服务器实时生成 HTML,内容随请求变化,适合个性化或高频更新的页面。静态生成(SSG)在构建期就已生成 HTML,部署后由 CDN 直接分发,速度最快但内容更新需重新构建。预渲染(prerendering)通常指在构建期对无 SSR 能力的 SPA 路由跑一次无头浏览器,把渲染结果固化为静态 HTML 文件。三者的共同点是:AI 爬虫拿到的初始响应体中就已包含完整文本,无需执行 JavaScript。与之相对的是客户端渲染(CSR),内容由浏览器执行 bundle 后填充,不执行 JS 的爬虫只能看到空壳。对 AI 抓取而言,SSR、SSG、预渲染等效,均可满足可达性;是否为动态、是否用框架,只是实现成本差异。
把三项检查组合起来
把 robots.txt、边缘状态、原始 HTML 三项检查合并成一条命令,便于批量跑:
python ai_audit.py https://example.com/pricing "per seat per month" "Starter plan"
运行范围建议是你收入贡献最高的前 20 个页面,而不是首页。定价、文档、对比和集成页是 AI 答案最常引用的地方,同时也是最容易被做成客户端渲染路由的页面。
通过检查 ≠ 会被引用
需要明确这套审计的边界:通过这三项检查,只说明 AI 爬虫能够读到你的页面,并不说明它们会使用它。是否被引用取决于结构、schema、信任信号,以及页面是否说了值得被引用的话。前者是可达性,后者是可用性,两者需要分开评估。
如果只想要本周就能落地的简版动作:核对 robots.txt、检查 CDN 的 bot 设置、对最重要的五个页面做 view-source。
相关推荐

Anthropic Fable 5.2实测:一句话生成3A游戏与Excel克隆
Anthropic Fable 5.2实测:三行提示词生成可玩《战争机器》克隆、完整Excel和DaVinci Resolve克隆,解析基准测试、Ultra Code模式、token成本与定价策略,评估它是否值得替代Opus 5.5。

赛博寻书:BT社区如何「劫走」塞林格遗作
塞林格未发表的《The Ocean Full of Bowling Balls》仅存于大学图书馆且禁止复制。一个私密BT tracker悬赏六TB上传积分,社区从背诵接力到eBay买书扫描,最终成功让文本流出,却因传播过快被管理员删种。本文复盘这场赛博寻书行动及其讽刺结局。

弹劾防长赫格塞斯?五角大楼战争与中期选举风暴
五角大楼气氛紧张,伊朗战事持续八个月仍无退出方案。评论分析赫格塞斯弹劾动议的真实动机:不是罢免,而是留下政治记录,并剖析战争如何通过油价与生活成本影响中期选举选情。