AI爬虫正在摧毁知识共享:开放网络的隐忧
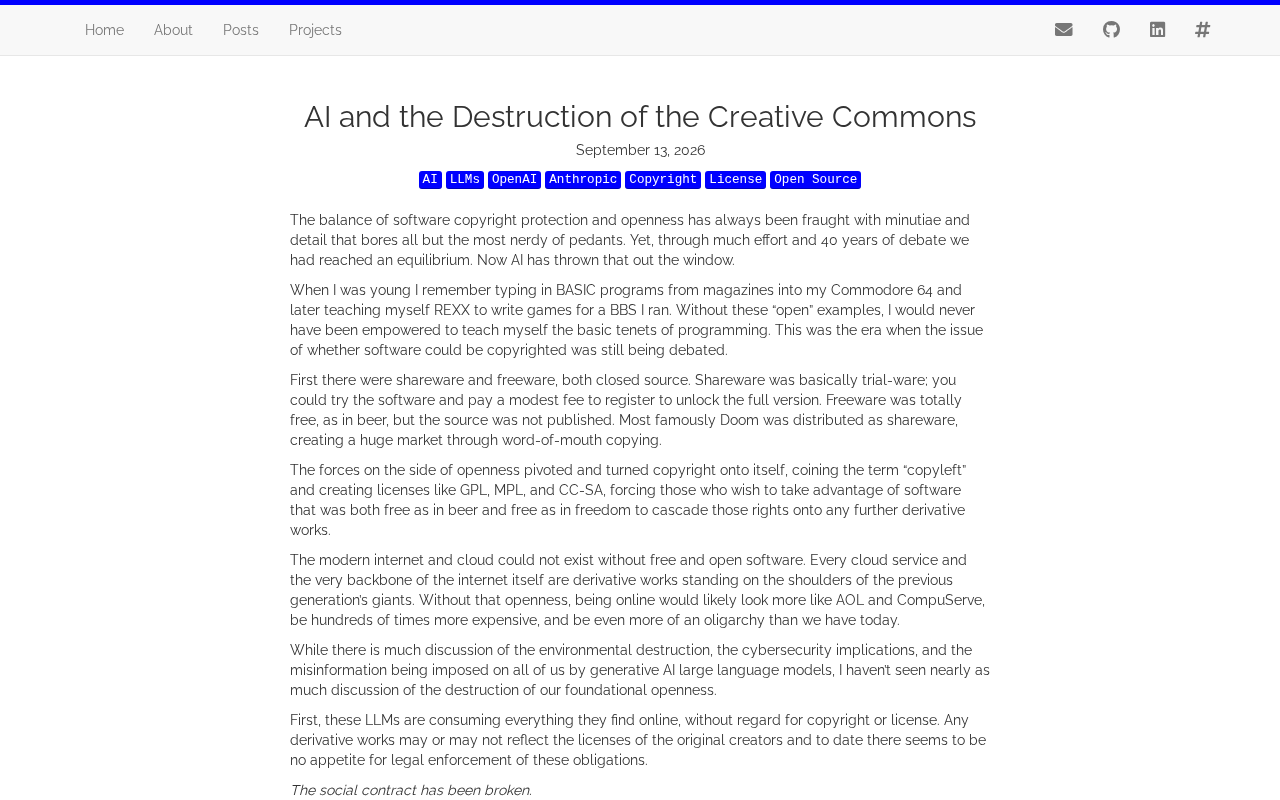
生成式AI大规模抓取开放内容,正在瓦解支撑知识共享生态数十年的流量互惠契约。
互联网的开放知识生态长期依赖一种隐性契约:创作者免费分享内容,换取流量与声誉回报。生成式AI的兴起正在系统性地破坏这一契约——用户直接从AI获取整合答案,原始创作者的内容被吸收进模型权重却得不到任何回流价值。这在经济学上构成数字版"公地悲剧":每家AI公司都有动力最大化抓取免费数据,却无人有动力维护产生这些数据的生态。知识共享许可证在AI训练场景下几乎无法执行,相关法律争议悬而未决。长期来看,这可能导致有价值的内容退入付费墙、公共网络被AI生成内容充斥,并引发"模型崩溃"风险。出路在于重新设计可持续的激励机制——授权分成、精细内容控制与新许可证框架——否则技术进步将以摧毁孕育它的知识土壤为代价。
当AI吞噬开放知识时发生了什么
互联网自诞生以来,一直依赖一种脆弱而慷慨的契约:创作者免费分享内容,换取流量、声誉或社区归属感。维基百科、开源代码库、技术博客、论坛问答——这些构成了所谓的"知识共享"(Creative Commons)生态。然而,随着大型语言模型对训练数据的贪婪需求日益增长,这套支撑了数十年的互惠机制正在遭遇前所未有的冲击。
这篇在Hacker News上引发讨论的文章,触及了一个技术社区长期担忧却难以解决的核心问题:当AI公司大规模抓取、消化并重新包装公开内容时,原始创作者获得了什么?答案往往是——什么也没有,甚至更糟。
互惠契约的崩塌
开放网络的运转建立在一个隐含的交换之上。你写一篇教程,搜索引擎收录它,读者通过搜索找到你,你获得访问量、广告收入或潜在客户。这套逻辑让无数个人和小团队愿意持续贡献高质量内容。
问题在于,生成式AI打破了这条价值链。当用户直接向ChatGPT或类似工具提问,得到的答案可能整合自成百上千个网页,却不再引导用户访问任何原始来源。创作者付出的劳动被吸收进模型权重,转化为AI公司的产品价值,而流量、署名和收入的回流几乎消失。
对于依赖广告或订阅生存的内容站点,这意味着生存基础的动摇。当写作不再带来回报,理性的创作者会选择停止分享,或将内容锁进付费墙和封闭平台。
"公地悲剧"的现代变体
经济学中的"公地悲剧"描述了这样一种困境:当一项资源对所有人开放且无人承担维护成本时,个体的理性行为会导致集体资源的枯竭。AI对开放内容的抓取正是这一悲剧的数字化重演。
每家AI公司都有动力尽可能多地抓取免费数据来训练模型,但没有一家有动力去维护产生这些数据的生态系统。当创作者因为得不到回报而撤退,公共知识池会逐渐萎缩、僵化,最终受损的是包括AI公司在内的所有参与者——毕竟模型也需要持续的新鲜内容来保持时效性。
这种矛盾在技术社区尤为尖锐。开源软件、Stack Overflow问答、技术文档本是协作精神的产物,如今却成了商业模型的免费燃料。一些平台已经开始反击:通过修改robots.txt、部署反爬虫机制,或直接向AI公司收取数据授权费。
「公地悲剧」(Tragedy of the Commons)由生态学家加勒特·哈丁于1968年在《科学》杂志发表的同名论文中系统阐述。他以中世纪英国的公共牧场为例:每个牧民都有动力多放一头牛以获益,但承担的损耗由全体分担,理性个体的叠加最终导致草场过度放牧、资源耗尽。经济学家后来将这一模型推广到所有"非排他性、竞争性"资源的困境。值得注意的是,诺贝尔经济学奖得主埃莉诺·奥斯特罗姆的研究表明,公地悲剧并非必然结局——当社区能够自我组织、制定规则并相互监督时,公共资源可以得到可持续管理。这一发现对AI内容生态同样具有启示意义:技术社区能否形成类似的自治规范,是决定开放网络命运的关键变量之一。
许可证与法律的灰色地带
知识共享许可证(Creative Commons License)本意是促进内容的自由流通,但这些许可证在设计时从未预料到会被用于训练营利性AI模型。署名要求(BY)、非商业限制(NC)等条款在AI训练场景下变得难以执行——当一段文本被切碎、向量化并融入数十亿参数时,如何追溯原始署名?
这带来一个尴尬的局面:那些出于善意采用宽松许可证的创作者,可能正是最容易被无偿利用的群体。而法律体系目前对"AI训练是否构成合理使用"这一根本问题尚无定论,多起诉讼仍在进行中,结果将深刻影响整个内容生态的未来走向。
美国版权法中的「合理使用」(Fair Use)原则是当前AI训练争议的核心法律支点。该原则允许在特定条件下未经授权使用受版权保护的作品,法院通常考量四项因素:使用目的(是否商业性)、作品性质、使用比例,以及对原作市场价值的影响。AI公司普遍援引"变革性使用"(transformative use)主张——即训练过程将原始内容转化为了全新的统计模式,而非直接复制。批评者则反驳,这一论点若成立将使版权保护形同虚设。目前,盖蒂图片社诉Stability AI、美国作家协会诉OpenAI等多起诉讼仍在推进中,其判决结果将成为全球AI训练数据使用的重要先例。
我们可能失去什么
如果这一趋势持续,最坏的结果不是AI变得更强大,而是开放网络本身的退化。当越来越多有价值的内容被锁进封闭花园,公共互联网可能沦为低质量、AI生成内容的回音室——模型抓取AI生成的内容来训练下一代模型,形成所谓的"模型崩溃"(model collapse)风险。
更深层的损失是文化性的。知识共享代表了一种理想主义:知识应当自由流动,站在巨人的肩膀上人人可为。如果这种精神因为缺乏可持续的激励而消亡,我们失去的将不只是几个网站,而是一种协作创造的文明范式。
「模型崩溃」(Model Collapse)是2023年以来机器学习研究者提出并验证的一种退化现象。当语言模型的训练数据中混入大量AI生成内容时,模型在迭代训练中会逐渐"遗忘"真实世界数据的长尾分布,输出日益趋向单调、同质化,极端情况下会产生无意义的重复文本。牛津大学等机构的研究以数学方式证明,这种退化在多代训练迭代后不可逆。这意味着,如果公共互联网被AI生成内容淹没,下一代模型的训练集将不可避免地受到污染,形成一个自我强化的质量下降螺旋——越来越强大的生成能力,配上越来越贫乏的知识底座。
可能的出路
社区讨论中提出了几种方向。一是建立AI公司与内容平台之间的授权与分成机制,让价值回流到创作者手中;二是发展技术手段,让创作者能够更精细地控制内容是否可被用于AI训练;三是推动新的许可证框架,明确界定AI训练的权利与义务。
没有任何单一方案能解决所有问题。但可以确定的是,如果技术进步的代价是摧毁孕育这一进步的知识土壤,那将是一笔糟糕的交易。开放网络的未来,取决于我们能否为数字时代的"知识共享"重新设计一套可持续的激励机制。
相关推荐
WorkBuddy智能体实战:从AI问答到自动办公的跨越
WorkBuddy是腾讯推出的AI智能体桌面工作台,能读取本地文件、操作办公软件、执行多步骤任务并定时自动运行。本文详解其核心功能、与传统AI工具的本质区别及适用场景。
Anthropic研究:LLM让形式化软件验证规模化成为可能
Anthropic Frontier Red Team研究显示,LLM已能在上百个真实开源库的RISC-V汇编级别批量生成形式化证明,覆盖123个OSS-Fuzz库、239个入口点,合计约1.8亿行Rocq证明,并在过程中发现数百量级Bug。文章解析其规格生成、证明流水线、信任边界与成本下降路径。
提示词工程入门:从写提示词到构建AI协作能力
从提示词的四大作用到提示词工程的六步流程,系统梳理AI提示词工程的核心概念、商业价值与三层局限性,帮助初学者建立对提示词工程的完整认知框架。