AI群体协商的智慧:多样性模型讨论如何超越单体判断
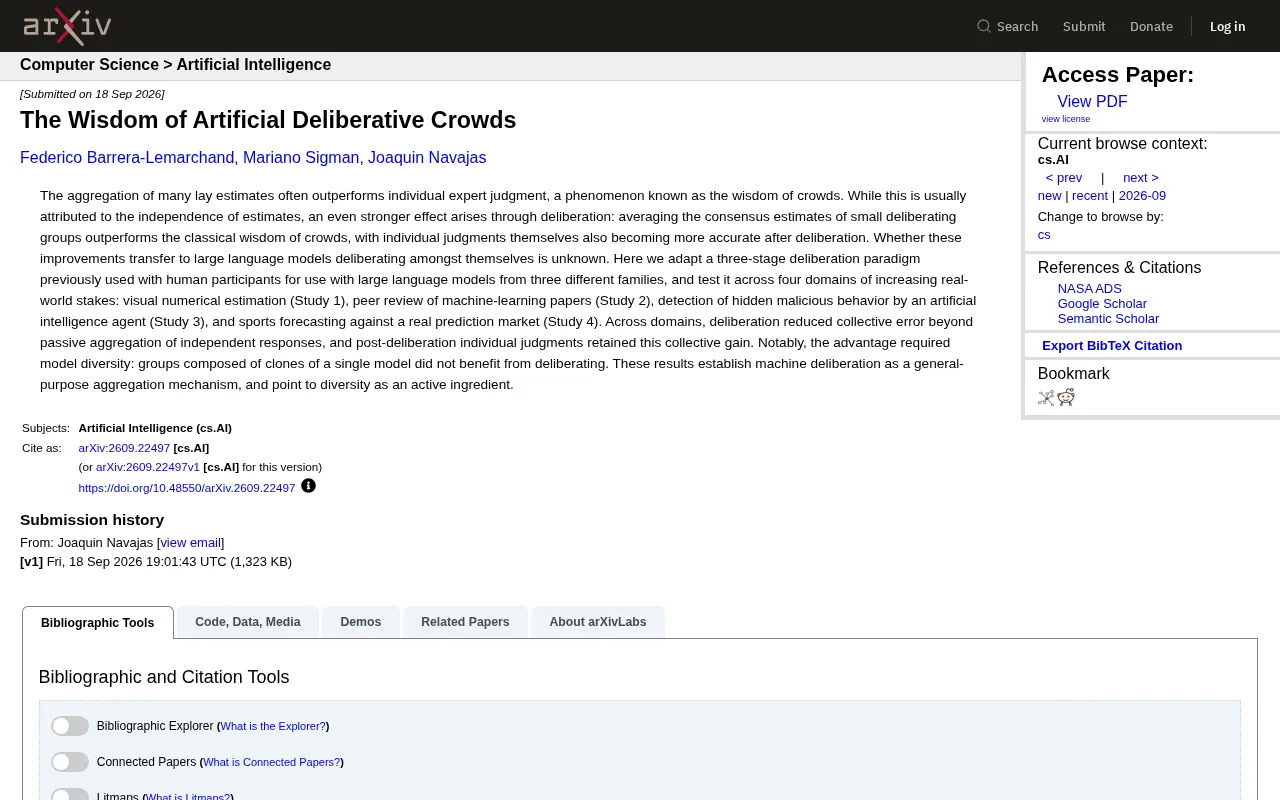
研究证明LLM多样性协商能超越被动汇总,但克隆模型讨论无效,多样性是核心活性成分。
这项发表于arXiv的研究将人类"协商群体智慧"范式迁移至大语言模型,在视觉估计、论文评审、AI恶意行为检测、体育预测四个风险递增场景中系统验证了协商效应。核心结论是:让来自不同模型家族的LLM先讨论、再给出判断,其集体准确度超越对独立答案的被动平均,且个体判断质量也随之提升。研究同时发现,协商增益完全依赖于模型多样性——由单一模型克隆构成的群体无法从讨论中获益,因为成员共享相同偏差,讨论只会形成回声室。该结论为多智能体系统设计提供了直接的工程启示:应刻意引入异质模型,而非部署同质副本。
从"群体智慧"到"协商智慧"
把许多普通人的估计取平均,往往比单个专家的判断更准确——这就是经典的"群体智慧"(wisdom of crowds)现象。传统解释将其归功于估计之间的独立性:每个人的误差随机分布,取平均后正负相消。
但心理学研究还揭示了一个更强的效应:如果让小群体先进行讨论(deliberation),再取各组共识估计的平均,其准确度会超越经典的群体智慧。更有意思的是,经过讨论之后,参与者个人的判断本身也变得更准确了。这意味着协商不只是"汇总",而是真正改善了认知质量。
这项发表于 arXiv 的新研究(arXiv:2609.22497)提出了一个关键问题:当把讨论的主体从人类换成大语言模型(LLM)时,这种协商带来的增益还能否成立?
群体智慧(Wisdom of Crowds)这一概念由统计学家弗朗西斯·高尔顿在1907年的研究中首次系统描述,他发现集市上近800名参与者猜测一头公牛体重的中位数,与实际体重误差不足1%。詹姆斯·苏罗维基在2004年的同名著作中将其推广普及,指出群体智慧奏效需要满足四个条件:意见多样性、判断独立性、判断去中心化、以及存在有效的汇总机制。其中独立性最为关键——一旦人们互相影响形成"信息瀑布"(information cascade),群体误差便不再相消,反而会同向累积。协商范式(deliberative paradigm)正是在此基础上的反直觉发现:适度的讨论并非破坏独立性、降低准确度,而是能通过筛选和传播高质量信息来净化判断,从而在特定条件下超越经典群体智慧。
三阶段协商范式如何迁移到大模型
研究者借用了此前用于人类实验的三阶段协商范式,并将其改造后应用于来自三个不同家族的大语言模型。所谓三阶段,通常指:模型先独立给出初始判断,随后在群体中进行讨论交换意见,最后再各自给出修正后的判断。
这样的设计能够同时测量两件事:一是各组"共识估计"的集体准确度,二是讨论之后单个模型判断的变化。前者衡量协商作为汇总机制的效果,后者衡量协商是否真正改善了个体认知。
采用来自不同家族的模型是这项研究的重要前提,也为后文关于"多样性"的核心结论埋下了伏笔。
四个逐级升高风险的测试场景
为了验证协商效应的普适性,研究在四个现实意义递增的领域展开测试:
视觉数值估计(Study 1)
最基础的场景,类似经典"猜罐子里有多少颗糖"的数值估计任务,用于检验协商在低风险、可量化任务上的表现。
机器学习论文的同行评审(Study 2)
将协商机制用于评估学术论文质量,这是一个主观性更强、更贴近专家判断的任务。
检测AI智能体的隐藏恶意行为(Study 3)
这一场景直接触及AI安全议题:让模型群体协商判断某个人工智能智能体是否存在隐藏的恶意行为。随着自主智能体的普及,这类监督任务的重要性正在快速上升。
对阵真实预测市场的体育预测(Study 4)
最高风险的现实检验——让协商群体与真实的预测市场(prediction market)竞争。预测市场通常被视为聚合信息的强基准,能击败它意味着协商机制具备实战价值。
预测市场(prediction market)是一种以金融交易机制来聚合分散信息的工具,参与者通过买卖与事件结果挂钩的合约来表达概率判断,价格最终反映市场对该事件发生可能性的集体估计。由于参与者有真实金钱激励,预测市场被认为能有效抑制随意猜测和认知偏差,在政治选举、经济指标预测等领域的表现长期优于民调和专家共识。Iowa Electronic Markets和Metaculus等平台的历史记录已证实其较强的预测效力。正因如此,预测市场通常被当作信息聚合领域的"黄金基准"——能够在与之竞争的测试中取得可比甚至更优的表现,意味着被测机制具备相当的实用价值。
核心发现:协商确实带来集体增益
研究结果在四个领域中保持一致:协商降低了集体误差,其效果超过了对独立回答的被动汇总。换句话说,让模型"讨论一下"比单纯把它们各自的答案取平均更有效。
同样值得关注的是,协商后的个体判断保留了这份集体增益——单个模型在经历群体讨论后,自身的判断质量也提升了。这与人类实验中观察到的现象高度吻合,说明协商的价值不仅在于最终汇总,也在于讨论过程对每个参与者的"教育"作用。
多样性是关键:克隆模型无法从讨论中获益
这项研究最重要的洞见在于:协商的优势依赖于模型的多样性。当群体由同一个模型的多个克隆组成时,讨论并不能带来任何好处。
这一发现有深刻的实践意义。它说明协商增益并非来自"多说几遍"或简单的计算叠加,而是源于不同模型之间视角、知识分布和错误模式的差异。当所有参与者共享完全相同的偏见时,讨论只会强化既有观点,而不会纠正它。多样性因此被认定为协商机制中真正起作用的"活性成分"。
这一发现在统计层面对应的是"误差相关性"问题:群体智慧的数学基础要求各个体的误差彼此独立,而来自同一模型的克隆副本共享几乎完全相同的权重、训练数据和归纳偏差,其误差高度相关,无论讨论多少轮都无法通过平均消除系统性偏差。研究者将不同模型家族(如GPT系列、Claude系列、Gemini等)视为实现"认知多样性"的操作化手段,类似于人类实验中确保参与者来自不同背景与专业领域。这也解释了为何仅靠增加同一模型的调用次数(即提高温度参数进行多次采样)通常无法等价替代真正的多模型协商——前者引入的是随机性波动,后者引入的是结构性差异。
对多智能体系统设计的启示
这项工作将机器协商确立为一种通用的汇总机制,为当下火热的多智能体(multi-agent)系统设计提供了实证依据。
对于工程实践而言,结论清晰而直接:如果想通过多个AI协作来提升决策质量,不应简单地部署同一模型的多个副本,而应刻意引入来自不同家族、不同训练背景的异质模型。同质化的"AI委员会"可能只是浪费算力的回声室。
从AI安全角度看,Study 3 中检测恶意行为的场景尤其耐人寻味——多样化模型的协商监督,或许能成为对齐与监督工具箱中的一种可行手段。当然,这些结论仍需在更多任务和更大规模上进一步验证,但"多样性优于数量"的原则,很可能成为未来多智能体系统的一条重要设计准则。
相关推荐
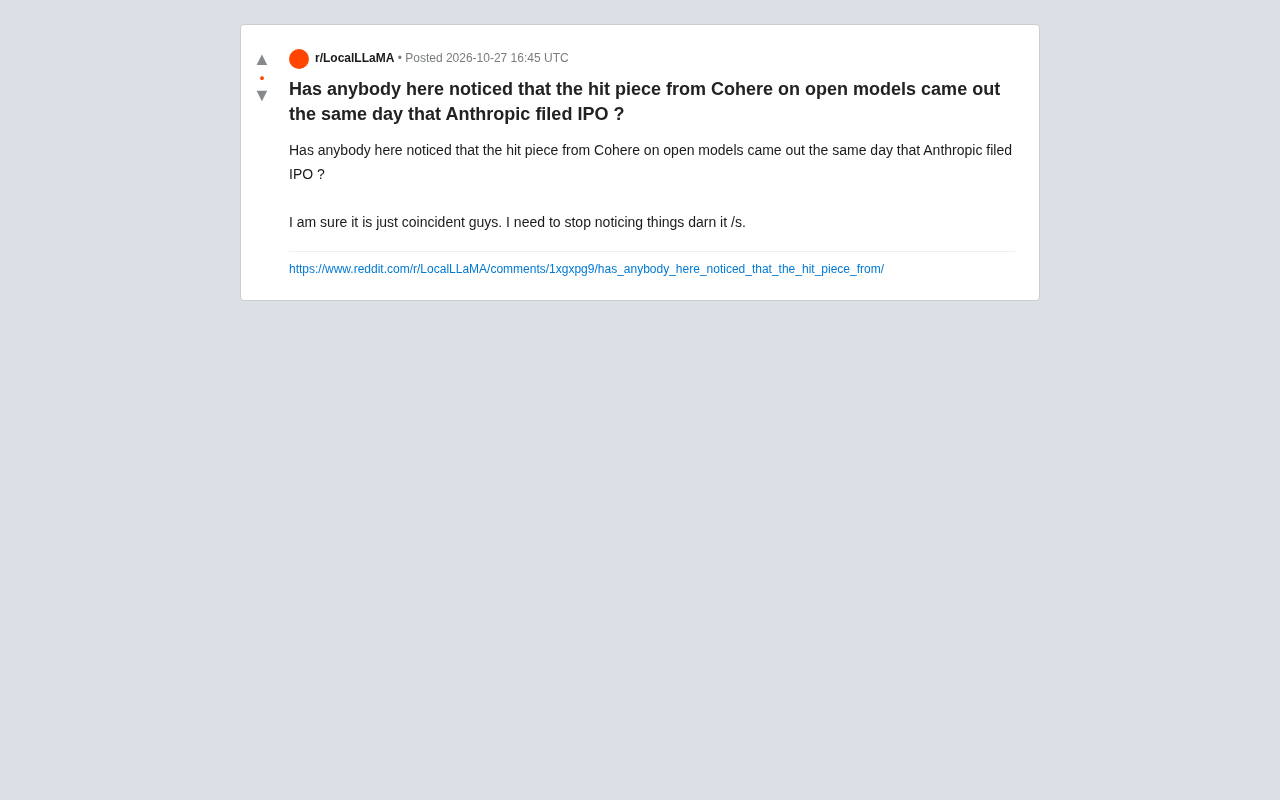
Cohere质疑开源模型与Anthropic IPO同日:巧合还是策略?
Reddit用户发现Cohere批评开源模型的文章与Anthropic提交IPO在同一天发布,引发社区对闭源厂商公共言论商业动机的讨论。本文分析这一时间巧合背后的开源与闭源之争,以及社区反应揭示的信任问题。
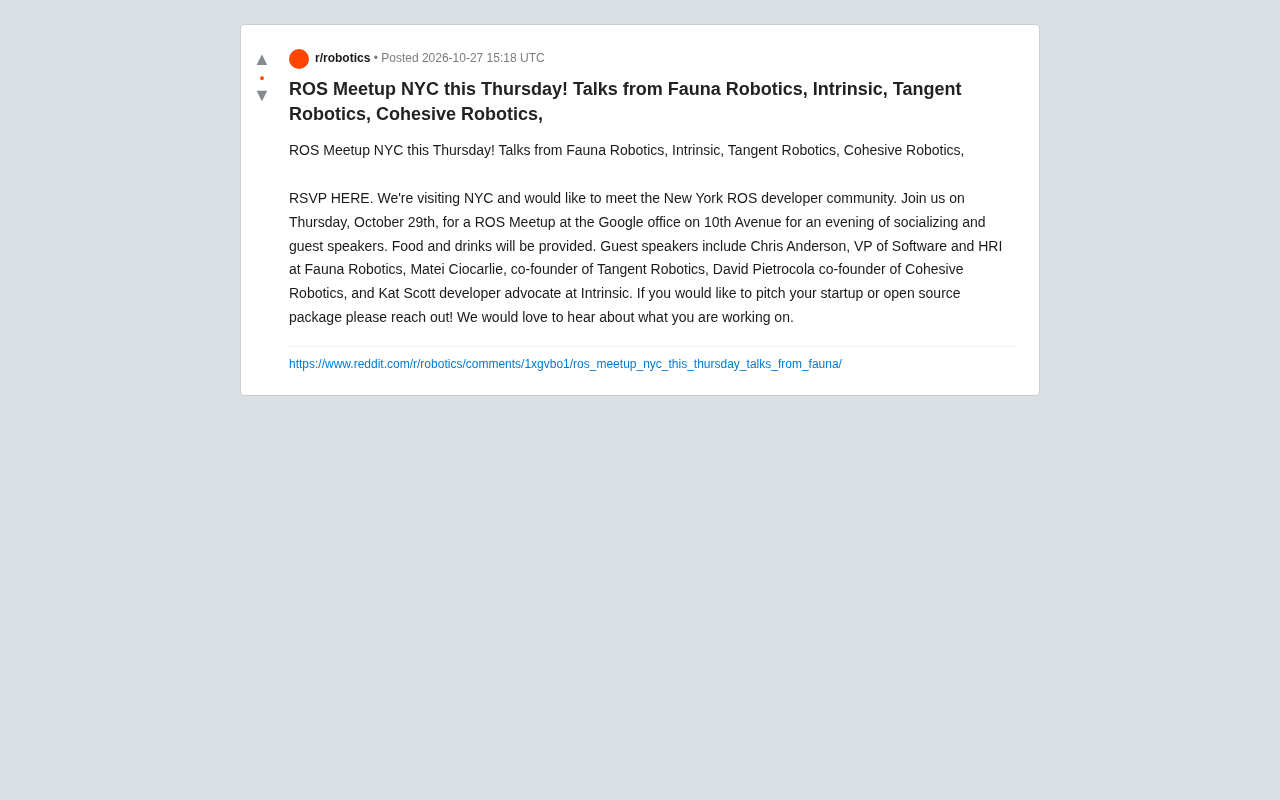
纽约ROS开发者聚会:四家机器人公司演讲
纽约ROS开发者聚会将于周四在谷歌办公室举行,Fauna Robotics、Intrinsic、Tangent Robotics、Cohesive Robotics等公司代表将发表演讲,活动免费并提供餐饮,开放报名与演讲征集。
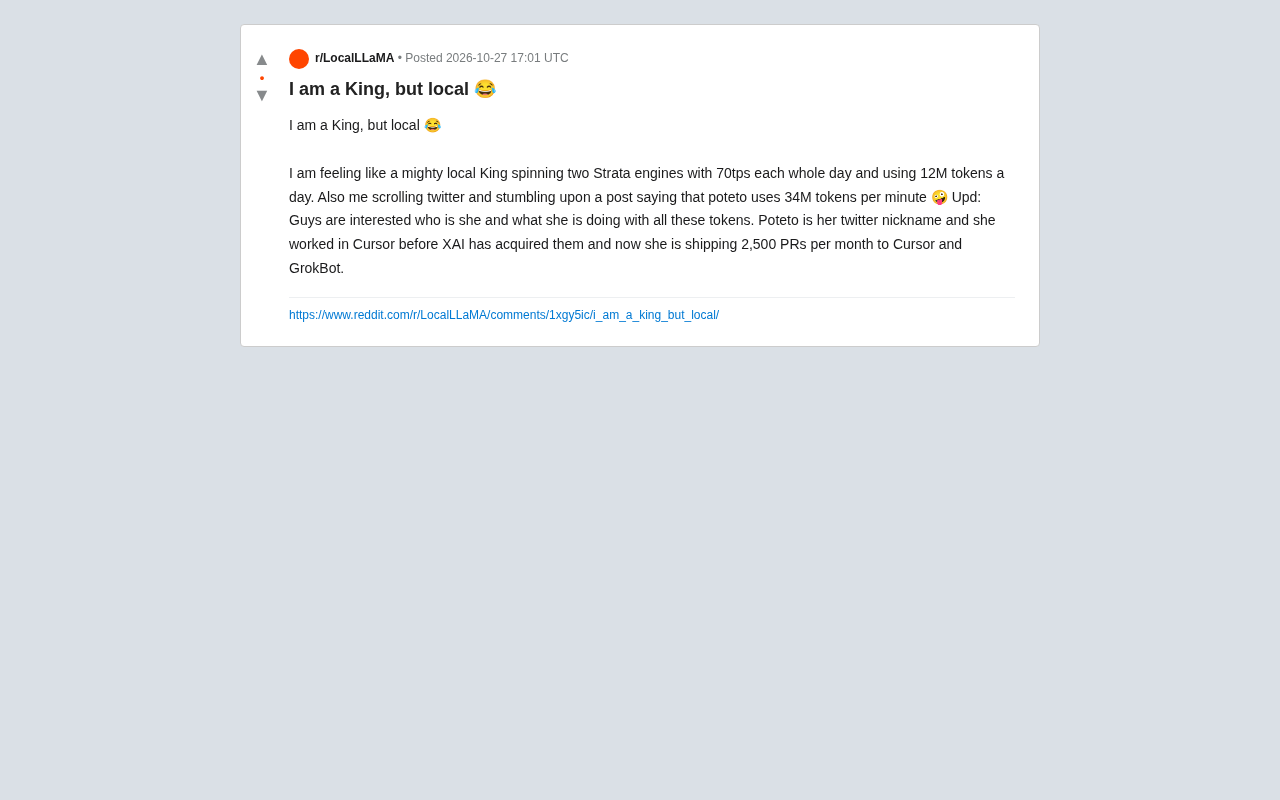
本地AI王者:日耗12M token背后的算力差距与竞争焦虑
Reddit开发者自嘲本地AI王者:日耗12M token,却被每分钟34M token的云端玩家降维打击。文章探讨本地部署与云端自动化的算力差距、token消耗量背后的行业焦虑,以及开发者如何在两种模式间找到平衡。