AI日报:速度战与成本战全面开打

引言:AI竞赛进入速度与成本双线作战
AI行业的竞争焦点正在从单纯的模型能力,转向推理速度与运营成本两条战线。据Conner AI日报的整理,OpenAI推出可提速14倍的UltraFast模式,Google DeepMind将Gemini新版本价格直接砍半,同时芯片供应紧张与新型存储技术的突破,正在重塑整个行业的算力经济格局。
这一系列动态传递出一个清晰信号:当模型能力逐渐趋同,谁能在保证质量的前提下跑得更快、更便宜,谁就能赢得下一阶段的市场。
OpenAI GPT 5.6 UltraFast:推理速度提升14倍
OpenAI官方宣布预览GPT 5.6的UltraFast模式,运行速度最高提升14倍,输出速度达到每秒750个Token。
Token与推理速度的技术解读
Token是大语言模型处理文本的基本单位,一个Token大致对应英文中的一个单词或中文中的一到两个字。传统大模型的输出速度通常在每秒50-150个Token之间,高性能模型如Claude、GPT-4o等在优化后可达每秒200-400个Token。每秒750个Token意味着模型可以在一秒内生成约500-600个英文单词的内容,远超人类阅读速度。
推理速度的提升依赖于多种技术手段。推测解码(Speculative Decoding)通过小模型预测后续Token再用大模型验证来加速生成——具体而言,它使用一个参数量仅为主模型十分之一左右的轻量级"草稿模型"快速生成多个候选Token序列,然后由大模型并行验证这些候选。由于Transformer架构中验证多个Token的计算成本接近生成单个Token,这种"先猜后验"的策略可以在不牺牲输出质量的前提下实现2-5倍的加速。KV Cache优化通过缓存注意力机制中的键值对减少重复计算,使得每生成新Token时无需重新计算与所有历史Token的关联,将计算量从O(n²)降至O(n),但其内存占用随上下文长度线性增长,对于超长上下文的模型可能需要数十GB的显存。模型量化将32位浮点参数压缩到8位甚至4位整数;硬件层面的张量并行则将计算任务分配到多个GPU核心同时执行。这些技术的组合使得750 Token/s的速度成为可能,但也对硬件资源提出了极高要求。
你可能没注意到推出策略——该模式将首先向部分API客户开放,并随着容量增长逐步向更多企业推出。这种"容量约束下的分级放量"策略在云计算行业有着深厚的先例:AWS、Azure等云服务商在推出新型GPU实例时也常采用类似方案。核心考量在于,高性能推理需要专用集群配置、特定的GPU型号和网络拓扑,扩容周期通常以月计算;分级放量还可以收集真实负载数据来优化调度算法,避免大规模上线后的服务质量波动。这从侧面印证了一个现实:高性能推理背后是巨大的算力压力。速度的提升往往意味着更激进的硬件调度和推理优化,而这些资源在当前的芯片短缺环境下并不容易获得。
对于智能体(Agent)应用和实时交互场景而言,每秒750个Token的输出速度是一个关键门槛。它意味着更流畅的多轮对话、更快的代码生成,以及更低的用户等待成本。对于AI编程助手的代码补全、客服机器人的即时响应、以及多智能体协作中的高频通信等场景,推理延迟往往是决定用户体验和产品可用性的核心因素。
Gemini 3.7 Flash:价格减半,编码能力大涨
Google DeepMind推出的Gemini 3.7 Flash,是这轮成本战中最直接的一击。该模型专为编码和智能体工作流设计,首发价格仅为3.6 Flash的一半。
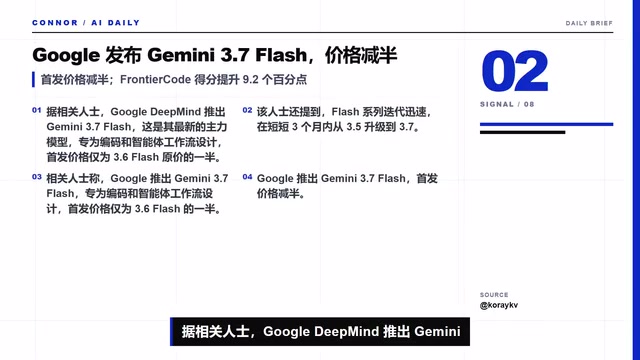
价格腰斩的同时,性能不降反升。评测数据显示:
- Frontier Code得分从34.4%提升至43.6%
- DeepSWE得分从49.0%大幅提升至65.3%
Frontier Code与DeepSWE基准深度解析
Frontier Code是评估AI模型前沿编程能力的综合性基准,涵盖代码生成、代码理解、Bug修复、代码重构等多维度任务。与简单的算法竞赛题不同,Frontier Code更关注模型在复杂工程环境下的表现,包括处理不完整的文档、理解隐式业务逻辑、以及在多文件项目中进行上下文感知的代码修改。从34.4%提升至43.6%的9.2个百分点改进,意味着模型在约四分之一的此前无法解决的难题上取得了突破。
DeepSWE(Deep Software Engineering)是衡量AI模型软件工程能力的重要基准测试,它模拟真实的软件开发场景,要求模型理解复杂代码库、定位Bug并生成修复补丁。与传统的代码生成测试(如HumanEval)仅考察孤立的函数编写能力不同,DeepSWE测试的是模型在真实项目环境中的综合能力——包括代码理解、依赖关系分析、测试用例编写和调试修复等。
从49.0%提升至65.3%这16.3个百分点的跨越,意味着模型在实际软件工程任务中的成功率提高了三分之一。这种能力的提升对AI编程助手的实用价值至关重要,因为真实开发场景中的代码往往涉及数万行代码、复杂的模块依赖和历史遗留问题,远比孤立的算法题复杂。这表明Gemini 3.7 Flash并非简单的"降价换量",而是在编码这一高价值场景中实现了成本与性能的双重优化。
对开发者而言,这意味着以更低的成本获得更强的代码智能体能力,这将进一步推动AI编程工具的普及。
新玩家入场:Red Note与美团的MOE模型
除了头部厂商的正面交锋,几家新玩家也带来了值得关注的技术方案,且不约而同地选择了MOE(混合专家)架构这一降本增效的路线。
MOE架构的技术原理与优势
MOE(Mixture of Experts,混合专家)是一种稀疏激活的神经网络架构,其核心思想是将模型分成多个"专家"子网络,每次推理时只激活其中一小部分。例如,一个280亿参数的MOE模型可能包含数十个专家模块,但每个输入Token只会被路由到2-4个专家进行处理,因此实际激活的参数量远小于总参数量。
这种设计巧妙地解耦了模型容量与计算成本:总参数量决定了模型的知识储备和能力上限,而激活参数量决定了单次推理的实际计算开销。路由机制(Router)是MOE架构的关键组件,它负责决定每个Token应该由哪些专家处理。当前主流的MOE模型包括Mistral的Mixtral系列、Google的Switch Transformer,以及DeepSeek广告-V3等。MOE架构特别适合需要处理多样化任务的场景,因为不同专家可以专注于不同领域的知识。
Red Note DOS 3 Note
据爆料,Red Note的AI实验室推出了DOS 3 Note预览版。这是一个280亿参数的MOE模型,激活参数仅16亿,支持512K超长上下文和多模态。
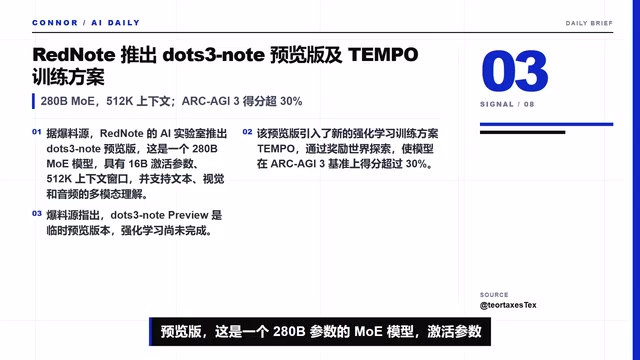
该模型采用了新的强化学习方案Tempo,在ARC-AGI 3基准上得分超过30%。Tempo方案代表了后训练阶段的新探索方向——传统的大模型后训练通常分为监督微调(SFT)和基于人类反馈的强化学习(RLHF)两个阶段,而新一代强化学习方案可能采用了过程奖励模型(Process Reward Model),对推理的每一步而非仅最终答案给予反馈,这对提升抽象推理能力尤为有效。
ARC-AGI基准与抽象推理能力
ARC-AGI(Abstraction and Reasoning Corpus for Artificial General Intelligence)是由Kaggle创始人François Chollet设计的通用智能基准测试,旨在衡量AI系统的抽象推理能力而非记忆能力。该测试包含数百个独特的视觉推理任务,每个任务提供2-3个输入输出示例,要求模型从中推断出转换规则并应用到新输入上。
与传统基准测试不同,ARC-AGI的每个任务都是全新的、从未在训练数据中出现过的,因此无法通过记忆解决,必须依赖真正的抽象推理能力。人类在该测试上的表现通常在85%以上,而早期的大语言模型得分接近零。超过30%的得分虽然距离人类水平仍有差距,但已经代表了模型在归纳推理、模式识别和规则泛化方面的显著进步,这是通向通用人工智能(AGI)的重要能力指标。
值得注意的是,280亿参数中仅激活16亿的极端稀疏比(约5.7%)在业界颇为少见,这意味着模型需要非常精确的路由策略才能在如此少的激活参数下保持性能。较小的激活参数意味着更低的推理成本,这正是MOE架构的核心优势——用大参数量保证能力上限,用小激活量控制运行开销。
美团Longcat 2.0
美团Longcat团队开发的Longcat 2.0模型已在相关平台免费发布。这是一个1.6万亿参数的MOE巨型模型,但激活参数仅约48亿,在Terminal Bench 2.1上得分70.8。
Terminal Bench是评估AI模型在终端环境中执行复杂软件工程任务的基准测试,测试场景包括在命令行环境中导航文件系统、运行和调试程序、管理版本控制等。2.1版本增加了更多真实世界的工程场景和更严格的评分标准。Longcat 2.0选择1.6万亿总参数但仅激活48亿参数(激活比约0.3%)的设计,背后是对"知识密度"与"计算效率"平衡的深度思考——1.6万亿总参数意味着模型可以存储海量的领域知识,而48亿的激活量使得单次推理成本接近一个中等规模的稠密模型,为商业化部署创造了有利条件。
从280亿到1.6万亿,这两个模型代表了MOE架构在不同规模下的探索,也说明国内团队在稀疏化大模型上的技术积累正在快速追赶。值得注意的是,MOE架构的挑战在于负载均衡——需要确保各专家被均匀调用,避免部分专家过载而其他专家闲置,这在1.6万亿参数这样的超大规模下尤为考验工程能力。
算力战场:芯片短缺与存储技术突破
速度战与成本战的背后,是算力供给的根本约束。
据媒体报道,英伟达H100 GPU的一年期租赁成本在6个月内上涨了50%,部分大型芯片集群的等待时间已长达12至18个月。一块H100的零售价约为3-4万美元,但在现货市场上曾被炒至5万美元以上。造成供应紧张的原因是多层面的:台积电的CoWoS(Chip on Wafer on Substrate)先进封装产能是最大瓶颈,这种封装技术将计算芯片和HBM堆栈集成在同一个硅中介层上,其中涉及的硅通孔(TSV)工艺需要在硅晶圆上垂直钻孔并填充导电材料,孔径控制在微米级别,良率要求极高。HBM存储芯片的供应同样紧张,目前主要由SK海力士、三星和美光三家厂商垄断。这一现实催生了一个庞大的GPU云租赁二级市场,CoreWeave、Lambda Labs等GPU云服务商的估值在过去两年间飙升,部分企业甚至开始签订2-3年的长期租约以锁定价格和容量。这组数据揭示了AI行业当前最真实的瓶颈——不是算法,而是硬件供给。
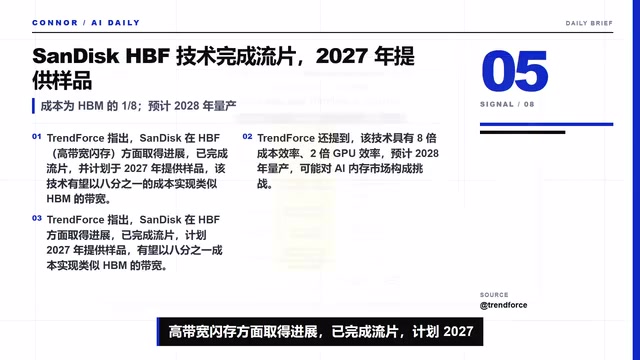
不过,好消息来自存储技术。Sandisk在HBF(高带宽闪存)方面取得进展,已完成流片,计划2027年提供样品,有望以1%的成本实现类似HBM的带宽。
HBM与HBF存储技术对比
HBM(High Bandwidth Memory,高带宽存储器)是当前AI加速器的核心存储组件,采用垂直堆叠的DRAM芯片通过硅通孔(TSV)技术互连,提供极高的内存带宽。例如英伟达H100使用的HBM3可提供超过3TB/s的带宽,是传统GDDR内存的数倍。然而HBM的制造工艺复杂、良率较低,导致成本极高且供应紧张,目前主要由SK海力士、三星和美光三家厂商垄断。
HBF(High Bandwidth Flash)则是一种新兴替代方案,试图通过将NAND闪存进行类似HBM的高密度封装和接口优化,在大幅降低成本的同时接近HBM的带宽性能。闪存本身的单位存储成本仅为DRAM的几十分之一,这就是"1%成本实现类似带宽"这一愿景的技术基础。HBF特别适合推理场景,因为推理阶段对带宽的需求高但对延迟的容忍度相对较大,恰好匹配闪存的特性——闪存的随机读取延迟虽然高于DRAM,但顺序读取带宽经过优化后可以接近HBM水平。如果该技术成熟,将彻底改变AI推理的成本结构,使大规模模型部署不再受困于昂贵的HBM供应。
如果HBF技术能够如期落地,将在很大程度上缓解高带宽存储的成本压力,为大规模模型部署打开新的可能。
此外,Epoch AI发布的分析颇具启发性:根据2023年至2025年每季度实际购买的芯片数据,每亿美元每年能买到的AI算力约增加49%,相当于每21个月翻一番。
AI算力性价比提升的驱动因素
每亿美元每年能买到的AI算力约增加49%,相当于每21个月翻一番,这一规律可以类比半导体行业著名的摩尔定律(每18-24个月晶体管密度翻一番),但两者的驱动机制有所不同。摩尔定律主要依赖制程工艺的微缩,而AI算力性价比的提升则来自多个层面的叠加效应。
首先是芯片架构创新,从通用GPU到专用AI加速器(如Google TPU、Tesla Dojo)针对矩阵运算做了大量优化,包括更大的片上缓存、更宽的内存总线和专用的张量计算单元;其次是先进封装技术如Chiplet(小芯片)和CoWoS突破了单芯片面积限制,允许将多个功能模块在封装层面集成;第三是软件编译优化,通过更智能的计算图优化和内存管理提升硬件利用率;最后是模型本身的效率提升,包括量化、知识蒸馏、稀疏化等技术使得同等能力所需的算力持续下降。
49%的年增长率意味着三年后同等预算可购买的算力将是今天的约3.3倍,五年后接近7.5倍,这将使今天只有大型科技公司才能负担的训练和推理规模在几年后变得中型企业甚至创业公司也能触及,这对整个AI产业的民主化进程意义深远。
推理优化:Prime Flash MOE内核加速
在软件层面,推理优化同样在加速。Prime Intellect官方宣布推出Prime Flash MOE,这是一套针对Blackwell架构优化的CUDA内核,专用于MOE推理。
Blackwell架构与精度优化
Blackwell是英伟达在2024年推出的最新GPU架构,代表产品为B100和B200。相较于前代Hopper架构(H100/H200),Blackwell在AI推理方面引入了多项重要改进:原生支持FP4(4位浮点)精度计算,使得单芯片的推理吞吐量相比H100可提升数倍;第二代Transformer引擎通过动态精度调整在保持模型质量的同时最大化硬件利用率;以及第五代NVLink互连,提供每链路900GB/s的双向带宽,对于MOE模型推理至关重要——因为不同专家可能分布在不同的GPU上,Token路由到特定专家时需要跨GPU传输数据,如果互连带宽不足就会成为严重的性能瓶颈。
CUDA内核是运行在英伟达GPU上的并行计算程序单元,针对特定计算模式的定制化CUDA内核可以显著提升性能。BF16(Brain Float 16)是Google提出的16位浮点格式,通过牺牲精度位数来保持更大的数值范围,特别适合深度学习中的梯度计算;MXFP8是微软和英伟达联合提出的8位混合精度格式,能在进一步减半内存和计算开销的同时保持模型精度。
对MOE模型而言,稀疏激活模式导致GPU计算资源的利用率往往不如稠密模型——专家分发需要额外的通信开销,不同专家的计算量不均衡会导致部分GPU核心空闲。专门优化的CUDA内核能够通过更高效的专家分发策略、动态负载均衡和内存访问模式优化来弥补这一短板,在同样硬件上获得更高的实际吞吐量。
该内核支持BF16和MXFP8两种精度路径,并已在B200上完成基准测试。随着MOE架构成为主流,专门针对稀疏计算优化的底层内核将变得越来越重要——它们能在同样的硬件上榨取更多性能,从而进一步降低推理成本。
结语:能力趋同后,效率决定胜负
综观这一轮行业动态,一个明确的趋势正在形成:当模型能力逐渐逼近天花板,竞争的重心正在转向速度、成本与效率。
无论是OpenAI的14倍提速、Gemini的价格腰斩,还是MOE架构的广泛采用、HBF存储的技术突破,本质上都指向同一个目标——让AI能力以更低的成本、更快的速度触达更多用户和场景。
对于开发者和企业而言,这是一个值得庆祝的信号:AI的使用门槛正在持续降低,而算力性价比每21个月翻一番的规律,也预示着未来几年AI应用将迎来更大规模的爆发。
核心要点
相关推荐

奥特曼称本地部署不如数据中心,开源AI路线之争再起
奥特曼称开源大模型本地部署不如数据中心集中运算,B站UP主瓜熟迪落拉拆解这一表态背后的技术路线之争与中美AI业态差异,讨论本地部署是否真的该被放弃。

MiniMax H3开源工作流:低显存也能打造呼吸感皮肤
本文介绍B站UP主分享的MiniMax H3双采样工作流,通过融合模型、破线LoRA和低显存节点,解决AI人物面部油腻问题,并让12G显存设备也能运行。包含模型搭配、双采样逻辑与参数设置详解。

手机本地大模型+ESP32:自制热量提醒器
B站UP主开源了一个热量摄入提醒器项目:手机APP用miniCPM开源模型本地拍照识别食物并估算热量,ESP32小屏幕同步数据,用绿黄红圆环展示摄入状态,可磁吸在冰箱门上随时提醒。