AI生成美食图为何总翻车?技术局限与商业困境解析

当美食营销遇上AI:一场视觉灾难
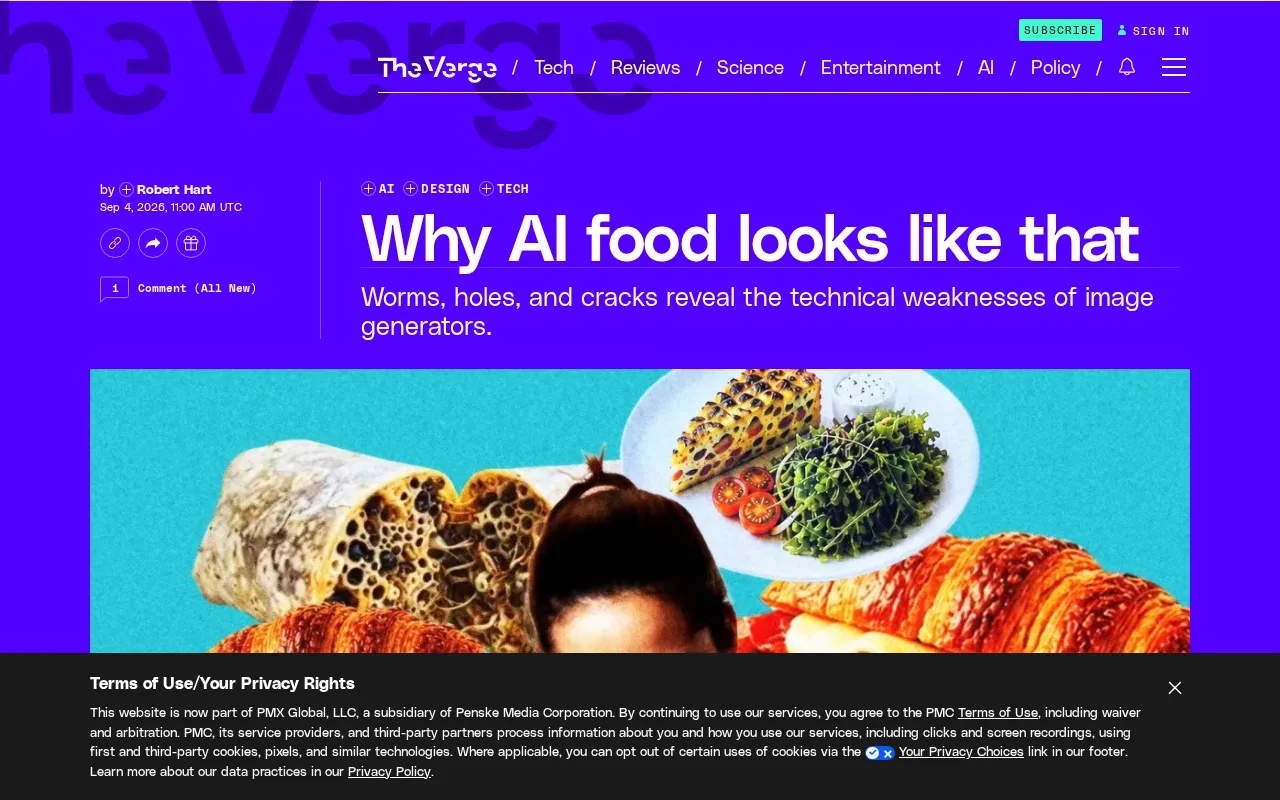
如今,越来越多的餐厅、咖啡馆和品牌开始用AI来生成食物宣传图,结果却常常令人食欲全无。从"甜甜圈虾"到"深海鲁本三明治",从蠕虫般的面条到面条般的糕点,再到黏糊糊的鸡肉——这些AI生成的美食图像正以一种诡异的姿态充斥社交媒体和商家宣传页面。
更荒诞的是,还有"伪装成冰淇淋的建筑材料"和"伪装成其他东西的冰淇淋"。这些图像不仅无法激发购买欲望,反而形成了一种独特的"AI恐怖谷"效应——看起来像食物,却又明显不是真正的食物。
"恐怖谷效应"(Uncanny Valley)这一概念最早由日本机器人学家森政弘在1970年提出,用于描述人类对于"接近但不完全像人"的机器人所产生的强烈不适感。当一个物体与真实事物相似度达到某个临界点,却又在某些细节上明显偏离时,人类的大脑会触发一种本能的排斥反应。这一效应如今已从机器人领域延伸到AI生成图像:那些"看起来几乎对,但又哪里不对"的AI美食图,恰好落入了视觉感知的恐怖谷区间,引发的不适甚至比完全不像食物的抽象图案更加强烈。
为什么AI总是画不好食物?
要理解AI生成的美食图为何频频翻车,得从图像生成模型的工作原理说起。当前主流的文生图模型(如Stable Diffusion、DALL-E等)本质上是基于海量训练数据学习"什么样的像素组合对应什么概念"。
当前主流的文生图模型主要分为三大技术路线:扩散模型(Diffusion Models)、生成对抗网络(GANs)和自回归模型(Autoregressive Models)。其中,扩散模型因其生成质量稳定、训练相对容易而成为当前主流——Stable Diffusion、DALL-E 2/3、Midjourney等知名产品均基于此架构。扩散模型的核心思想源自物理学中的非平衡热力学:通过模拟分子扩散过程,将有序信息逐步转化为无序噪声(前向过程),再训练神经网络学习反向还原的能力(逆向过程)。这一范式在2015年由Sohl-Dickstein等人首次提出,但直到2020年DDPM(Denoising Diffusion Probabilistic Models)论文发表后才真正引爆学术界。与早期的GAN相比,扩散模型避免了训练不稳定和模式坍塌问题,但代价是推理速度较慢——生成一张图像通常需要数十到上百步去噪迭代。
具体而言,以Stable Diffusion为代表的扩散模型(Diffusion Model)采用了一种"先加噪再去噪"的生成策略:训练阶段,模型学习如何从一张被逐步添加高斯噪声直至变成纯噪声的图像中,一步步还原出原始图像;生成阶段,模型则从一团随机噪声出发,在文本提示的引导下逐步"去噪",最终生成一张与描述匹配的图像。
文本提示如何指导图像生成?这依赖于CLIP(Contrastive Language-Image Pre-training)等文本-图像编码器。CLIP由OpenAI在2021年发布,其革命性在于通过对比学习(Contrastive Learning)在海量图文配对数据上训练,让文本和图像在同一个高维向量空间中获得语义对齐——相似概念的文本和图像会被映射到空间中相近的位置。这种对齐能力使得模型可以理解"一只戴墨镜的猫"这样的组合概念,即使训练数据中从未出现过这个精确组合。然而,CLIP的语义表征是统计性的而非符号性的——它通过大量样本学习到"猫""墨镜"在视觉上的典型特征分布,但并不真正理解"戴"这一空间关系的物理约束。这就导致了生成图像时的组合失败:模型可能将墨镜画在猫的耳朵上、尾巴上,或者干脆让猫和墨镜融为一体。这种组合性失败在食物生成中尤为明显——当提示词包含"巧克力""披萨""草莓"多个元素时,模型往往无法正确分离和组织它们的视觉特征。
文本提示通过CLIP等文本编码器被转化为语义向量,这个向量在潜在空间(Latent Space)中引导去噪方向。然而,潜在空间中的语义表征是高度压缩和抽象的——"虾"和"甜甜圈"在这个空间中的表征可能因为形状特征(环形、弧形)而存在意外的邻近关系,这就为生成过程中的概念混淆埋下了隐患。
食物是极其复杂的视觉对象:细腻的纹理、半透明的质感、复杂的光泽反射,以及人类极其熟悉的形态特征。正因为我们太熟悉食物应该长什么样,任何微小的失真都会被立刻察觉。这与AI画风景或抽象图案截然不同——后者即便有瑕疵,人眼也不容易发现。
认知心理学研究表明,人类视觉系统对于"每天都在接触的事物"拥有极其精细的内部模型,食物、人脸和文字是其中最典型的三类对象。这就是为什么AI在生成这三类内容时最容易"露馅"——我们的大脑对它们的判断精度远高于对风景或抽象图形的判断。
AI美食图的典型翻车模式
结构与逻辑的崩塌
AI模型缺乏对物理世界和食物构成的真正理解。它不知道面条应该是可以用筷子夹起的柔软条状物,也分不清甜甜圈和虾之间的本质区别。当训练数据中的特征被错误混合时,就产生了"甜甜圈虾"这类怪异的杂交产物。
面条被画成蠕虫、糕点被画成面条状,正是模型在"形状相似度"上产生混淆的结果。AI只是在统计意义上将相似的视觉模式拼凑在一起,而非真正理解每种食物的物理特性和制作逻辑。
这一问题在技术上被称为"概念混淆"(Concept Bleeding)或"属性泄漏"(Attribute Leakage)——当提示词中包含多个物体时,模型容易将一个物体的视觉属性"泄漏"到另一个物体上。例如输入"一盘虾旁边放着甜甜圈",模型可能在潜在空间中将虾的弯曲形态与甜甜圈的环状形态互相干扰,最终生成出虾形甜甜圈或甜甜圈形的虾。这本质上是因为当前的文生图模型缺乏组合性推理能力(Compositional Reasoning),无法像人类那样将场景分解为独立对象并分别赋予正确属性。
材质与真实感的严重错位
食物图像的另一大难点在于材质表现。冰淇淋应该有绵密、湿润、微微融化的质感,但AI往往生成出看起来像塑料、石膏甚至建筑材料的固态物体。反过来,一些本该坚硬的物体又被赋予了冰淇淋般的柔软外观。
这种材质错位源于AI对物理属性缺乏建模能力——它只能模仿视觉表象,却无法理解"融化""酥脆""多汁"这些与真实体验紧密相关的物理概念。
世界模型(World Models)是AI研究的一个重要分支,旨在让AI系统建立对物理世界的内在模拟和因果理解。这一概念最早由认知科学家Kenneth Craik在1943年提出,他认为智能体需要构建一个"内部的现实小模型"来进行推理和预测。在AI领域,世界模型研究在强化学习中率先取得进展——2018年Ha和Schmidhuber的World Models论文展示了如何让智能体通过学习环境动态模型来提升决策能力。近年来,这一思想被扩展到视觉生成领域:Meta的V-JEPA(Video Joint Embedding Predictive Architecture)试图通过预测视频中的抽象表征而非像素来学习物理规律;DeepMind的Genie可以从视频中学习交互式虚拟世界的物理引擎;OpenAI的Sora则在大规模视频数据上训练出了隐含物理常识的生成模型。然而,这些模型仍然是"隐式世界模型"——它们在神经网络的黑盒中学习到某些物理规律的近似,但无法像物理引擎那样进行显式的物理推理。对于食物生成而言,理想的世界模型需要理解材料科学(面团的黏弹性)、热力学(烘焙中的美拉德反应)和流体力学(酱汁的流动),这远超当前AI的能力边界。
当前AI研究的前沿方向之一,正是赋予模型对物理世界的理解能力。所谓"世界模型"试图让AI不仅能识别和生成图像,还能理解物体的物理属性、因果关系和时间演化。例如,Meta的研究团队提出的V-JEPA模型、Google DeepMind的Genie等项目,都在探索如何让AI建立对物理世界的内在模拟。而OpenAI在发布Sora视频生成模型时也强调,Sora在生成连贯视频的过程中,隐含地学习到了部分物理规律(如流体运动和物体碰撞)。然而,这些能力目前仍处于非常初级的阶段——模型可能学会了"水会流动"的表象,但并不真正理解分子层面的物态变化。对于食物而言,"冰淇淋融化后会变成液态奶油""油炸食物表面应有不规则的酥脆纹理"这类知识,需要的不仅是视觉统计,更需要跨模态的物理常识推理——这恰恰是当前多模态大模型(如GPT-4V、Gemini等)正在努力突破但远未解决的核心难题。
效果堪忧,商家为何仍在用AI美食图?
尽管翻车频频,越来越多的商家依然选择AI生成图像,背后是显而易见的经济动因。
专业美食摄影成本高昂:需要专业摄影师、食物造型师、灯光设备,甚至还需要精心准备真实的食物样品。一组高质量的美食照片动辄花费数千元。
事实上,专业美食摄影是一个高度专业化的细分行业。食物造型师(Food Stylist)的工作远比大多数人想象的复杂:为了让食物在镜头前呈现最佳状态,他们会使用大量"行业秘密"——例如用白胶水替代牛奶拍摄谷物广告(因为真牛奶会让谷物迅速变软),用鞋油给烤鸡上色以获得完美的焦糖色泽,用牙签和胶水固定汉堡的层叠结构,甚至用蒸棉球塞在食物后面制造热气腾腾的效果。一位资深食物造型师的日薪通常在数千到上万元不等,一次完整的商业美食拍摄(包含摄影师、造型师、道具师、后期修图)费用可达数万元,耗时可达数天。正是这种高昂的时间和金钱成本,让许多中小商家望而却步,转而投向几乎零成本的AI生成图像。
相比之下,AI生成图像几乎零成本、即时可得。对于预算有限的小型餐厅和咖啡馆而言,这种诱惑确实难以抗拒。
然而,这种"省钱"策略正在带来反效果。当消费者看到明显失真的AI图像时,不仅不会被吸引,反而可能对品牌的专业性和真实性产生怀疑。虚假的视觉承诺还可能引发货不对板的投诉,长远来看严重损害品牌信誉。
值得注意的是,在部分地区,使用AI生成的食物图像进行营销已经开始触碰法律边界——如果AI图像与实际产品差异过大,可能构成虚假广告或消费欺诈。
这场AI美食灾难揭示了什么?
生成式AI的技术能力边界
AI美食图的普遍失败,暴露了当前生成式AI的一个根本局限:它擅长模仿模式,却不真正理解世界。在那些人类拥有强烈直觉和丰富经验的领域——比如我们每天接触的食物——AI的"伪装"最容易被识破。
这也提醒我们,生成式AI并非万能工具。在需要高度真实感、专业性和情感共鸣的场景中,人类的专业技能仍然不可替代。
从技术发展的脉络来看,当前的图像生成模型正处于一个"高仿真、低理解"的阶段——它们可以生成像素级别极其精细的图像,但对图像内容所代表的物理现实缺乏深层认知。这与大语言模型(LLM)面临的"鹦鹉学舌"批评如出一辙:模型可以生成流畅的文本或逼真的图像,但这究竟是真正的"理解"还是高级的"模式匹配",仍然是AI学术界激烈争论的核心议题之一。
内容生态面临的隐忧
从更宏观的视角来看,这些"AI垃圾内容"(AI slop)正在污染我们的视觉环境。
"AI slop"这一术语在2024年迅速走红,被用来指代那些由AI批量生成、质量低劣、缺乏创意价值的网络内容。这个词的灵感来源于"slop"(泔水、猪食),形象地传达了人们对这类内容的厌恶感。据统计,社交媒体平台上AI生成内容的占比正在以指数级速度增长——Amazon上充斥着AI生成封面的劣质电子书,Facebook信息流中AI生成的"钓鱼"图片获得大量互动,Google搜索结果中AI生成的垃圾网页日益泛滥。这场"内容洪水"不仅稀释了真实创作者的可见度,也正在从根本上侵蚀互联网作为信息载体的可信度。
随着AI生成内容的泛滥,全球范围内的监管和平台治理正在快速演进。欧盟在2024年生效的《人工智能法案》(AI Act)要求所有AI生成的内容必须明确标注,违规者将面临巨额罚款。美国加州在2024年通过的AB 602法案要求社交媒体平台披露AI生成内容。中国也在《生成式人工智能服务管理暂行办法》中明确规定,AI生成内容应当以显著方式标明。技术层面,各大平台正在部署AI内容检测工具和水印技术:Google的SynthID可以在图像和音频中嵌入不可见的数字水印;Meta开发了专门的AI内容检测分类器;Adobe的Content Credentials为创作工具嵌入了内容来源追溯功能。然而,这场"攻防战"面临巨大挑战——水印可以被去除,检测器存在误判,而且最根本的问题是:当AI生成质量足够高时,人类是否还能分辨真伪?这不仅是技术问题,更涉及信息可信度、知识产权、劳动价值等深层社会议题。对于美食营销而言,部分国家的消费者保护法已经将"使用不实图像误导消费者"纳入虚假广告范畴——这意味着商家使用AI美食图不仅是审美问题,还可能构成法律风险。
各大平台已开始采取应对措施,如Meta要求标注AI生成内容、Google调整搜索算法降低AI垃圾页面的权重,但这场"攻防战"显然才刚刚开始。
低质量、批量生产的AI图像充斥网络,不仅拉低了整体内容质量,也让真实、优质的创作更难被发现。
对于品牌方而言,短期的成本节约可能换来长期的信任损耗。在这个视觉即第一印象的时代,一张"辣眼睛"的AI美食图,或许比没有图片更糟糕。
结语
AI生成的怪异美食图,是技术狂热与现实局限碰撞的一个生动缩影。它既反映了生成式AI在特定领域的能力短板,也折射出商业世界在成本压力下对新技术的盲目追逐。
或许,随着模型的持续进化,未来的AI能画出更逼真的美食。但在那一天到来之前,商家们也许应该认真想想:当AI连一碗面条都画不好时,是否真的值得用它来代替真实的食物影像?
与其寄希望于AI的快速迭代,不如在当下做出更明智的选择——即便是一张用手机认真拍摄的真实食物照片,传递出的诚意和信任感,也远胜于一张精致却诡异的AI生成图。
核心要点
相关推荐
tiun.:为AI开发者打造的一站式认证与支付系统
登顶 Product Hunt 的 tiun. 为 AI 开发者提供认证、支付、账单、客户数据与分析的一体化系统,一条命令即可安装,帮助开发者当天上线付费产品。本文解析其定位、卖点与竞争格局。
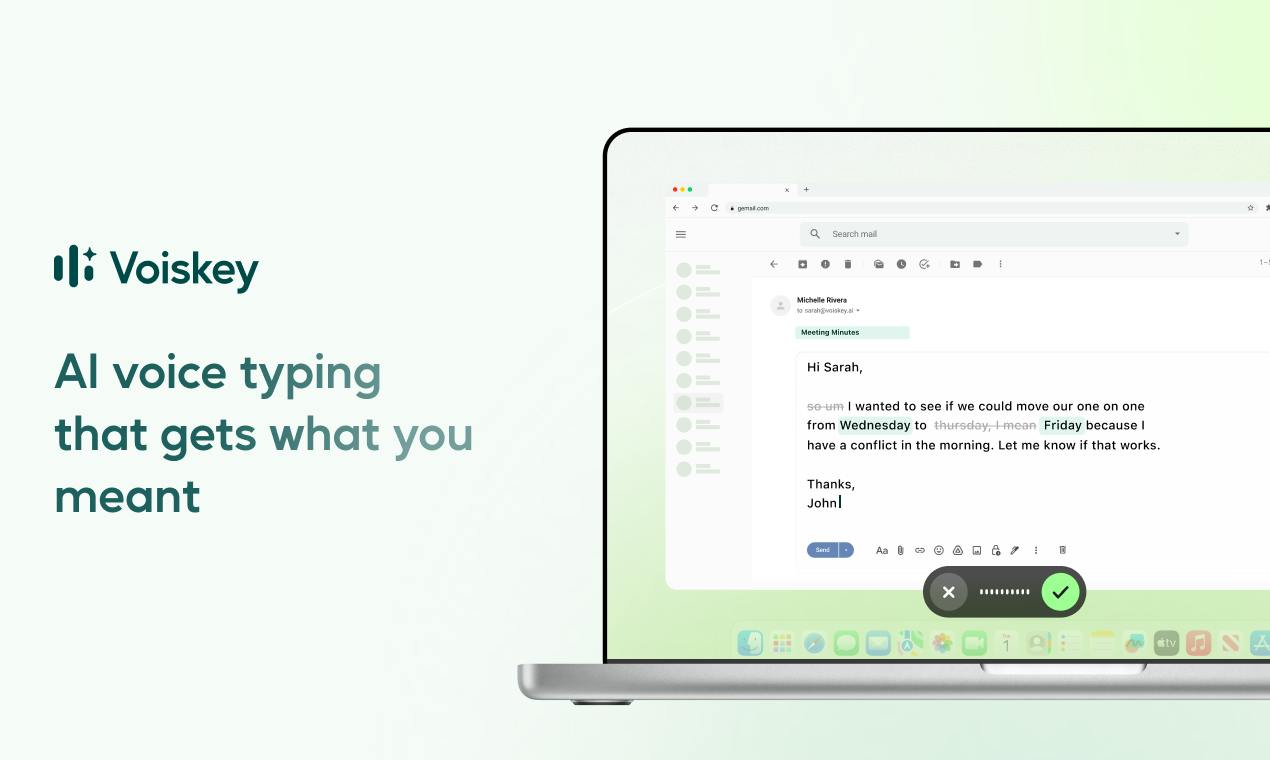
Voiskey:能读懂语境的AI语音输入工具
Voiskey是一款登上Product Hunt排名第3的AI语音输入工具,能根据场景和读者自动调整语气,比打字快5倍,支持iOS、macOS、Android、Windows四大平台及100多种语言。
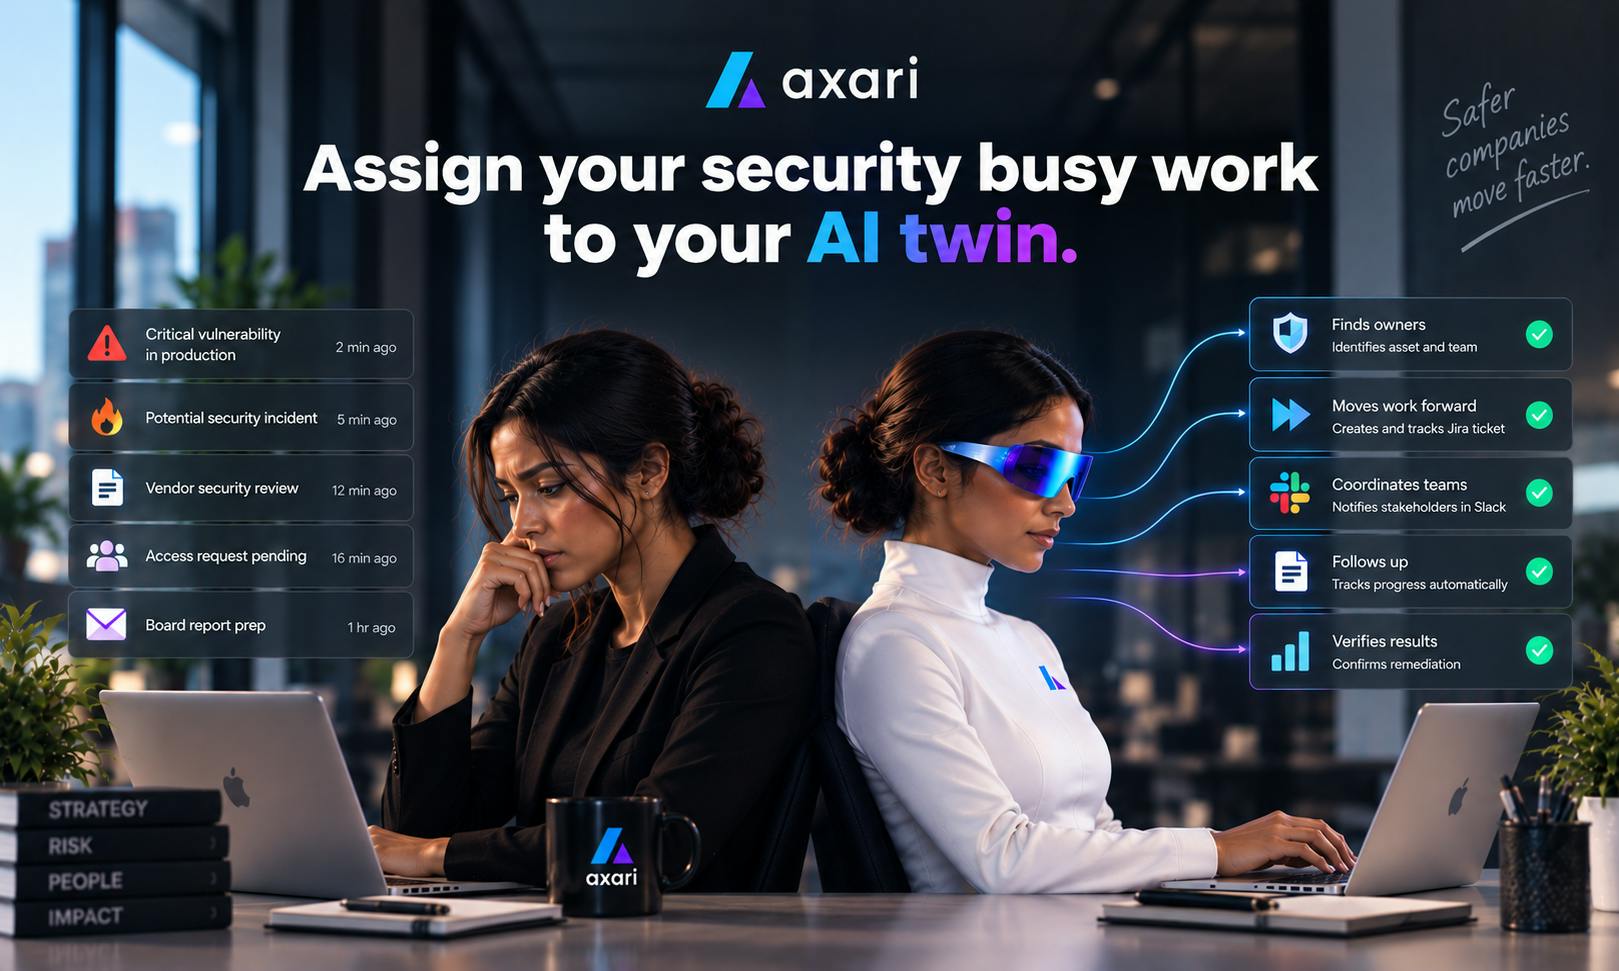
Axari:让AI分身接管你的安全运营琐事
Product Hunt新品Axari主打「AI分身」概念,帮安全团队自动处理重复性运营琐事,可在Slack、MS Teams中指派目标并自主推进任务。本文解析其产品逻辑、行业定位与需要冷静看待的问题。