AI时代为何首选PostgreSQL?从入门到进阶实战全解析
PostgreSQL凭借多模态数据能力与成熟生态,正成为AI应用落地的核心数据底座。
文章从 DB-Engines 排名与 Stack Overflow 2025 调查数据出发,阐述 PostgreSQL 已跻身全球数据库第一梯队、开发者使用率超过55%的现状。其核心论点在于:AI时代的数据库角色已从单纯的存储查询工具,演变为需要同时支撑结构化数据、向量检索、全文搜索、空间数据与安全治理的一体化底座。PostgreSQL 凭借 pgvector、PostGIS、PGSearch、AGE 等扩展以及 PG19 引入的原生图能力,恰好能以单一系统覆盖这些需求,使其在 AI 应用落地场景中具有独特竞争力。文章最后介绍了一套面向开发者的 PG 实战课程,涵盖环境搭建、核心原理到企业级运维与 AI 实战三个递进阶段。
PostgreSQL为何成为AI时代的数据底座
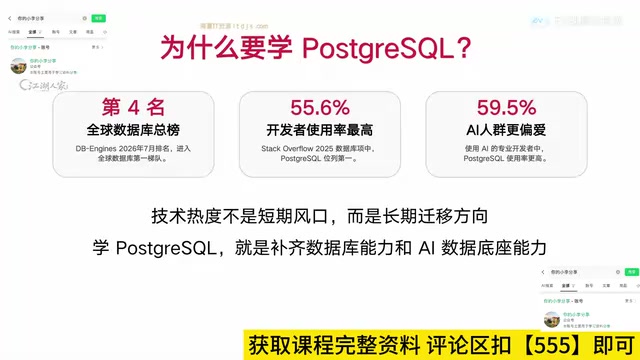
在数据库领域,知名排行榜 DB-Engines 的排名长期被视为行业风向标。该榜单基于搜索趋势、问答社区热度、岗位需求、社交信号等多个维度综合计算,并按月更新。从最新趋势来看,PostgreSQL(PG)已稳居全球数据库总排名第四,正式进入第一梯队。
更值得关注的是它的增长势头——PG 与第三名 SQL Server 之间的差距正在不断缩小,无论是生态势能、扩展能力还是开发者心智,都在持续走强。过去我们熟悉的 "Oracle、MySQL、SQL Server 三足鼎立" 的叙事,正在被 PostgreSQL 悄然改写。
数据层面同样印证了这一判断。据 Stack Overflow 2025 年开发者调查,PostgreSQL 的使用率已达到 55.6%;而在使用 AI 工具的专业开发者群体中,这一比例接近 60%。这意味着 PG 已不再是小众技术,也不是短期风口,而是越来越多开发者和企业选择的核心数据底座。
数据库角色的根本性变化
PG 走红的背后,本质是数据库角色的变化。过去谈论数据库,关注点无非是存储、查询、事务与稳定性——把数据正确存进去,需要时正确查出来,并保证一致性,这就足够了。
但在 AI 时代,一个应用要处理的早已不止是普通业务数据。它可能同时需要处理文档数据、向量、全文检索、空间信息,还涉及权限治理、安全审计等需求。换句话说,AI 需要的不是单纯的数据库,而是一套能支撑多种数据形态、多种查询方式、多种业务场景的一体化数据底座。
很多 AI 项目在真正落地时,难点往往不在模型本身,而在于:数据如何进入系统、进入后如何检索、如何做多维度关联、如何治理、如何稳定运行。PostgreSQL 恰好能在这些环节中承担关键角色。
传统数据库的"单一数据形态"困境在 AI 应用中尤为突出。一个典型的 RAG(检索增强生成)应用需要同时处理:结构化的用户元数据(关系型)、文档的语义向量(向量检索)、关键词匹配(全文检索)以及可能的地理位置过滤(空间数据)。若为每种需求部署独立系统,不仅运维成本高,更严重的问题是数据一致性——跨系统的事务保障极为困难,数据同步延迟会直接影响 AI 应用的检索准确性。将多种数据能力收敛到 PostgreSQL 这一个底座,意味着可以用标准 SQL 在单次查询中完成多维度联合过滤,同时享受统一的事务保证和权限管控,这是分散架构难以复现的优势。
PostgreSQL:AI时代的"六边形战士"
从能力结构看,PG 更像是一位全能型选手。它首先是一款成熟稳定、拥有数十年历史的关系型数据库,具备 SQL、事务、索引、约束、MVCC、WAL、高可用复制等核心能力。
真正让它脱颖而出的,是极其强大的扩展生态:
- 结构化数据:PG 的老本行,天然优势;
- 空间数据:PostGIS 几乎是行业标准,不少开发者正是因为 PostGIS 才认识了 PostgreSQL;
- 全文检索:内置 tsvector,还有提供类现代搜索引擎 BM25 能力的 PGSearch 等插件;
- 向量检索:pgvector 应用广泛,此外还有 DiskANN、pgvectorscale 等插件;
- 图检索:可借助 AGE 插件,而 PG19 更带来了 Property Graph 原生图能力。
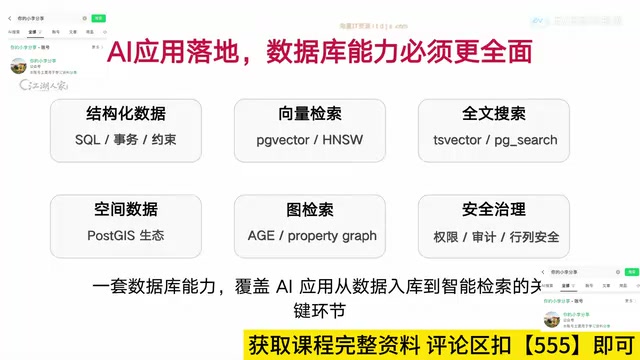
在安全与治理层面,PG 自身提供了权限管理、审计、行列级安全、脱敏策略等机制,能够满足企业级场景对稳定性和安全性的严苛要求。
PG 的核心价值并非单纯"能做数据库",而是把结构化数据、全文检索、向量搜索、空间数据、安全治理、高可用等能力组合在一起,形成一套完整的数据底座——这正是它在 AI 时代的独特竞争力。
pgvector 是 PostgreSQL 的开源向量扩展,允许将高维浮点数组(即"嵌入向量")作为原生列类型存储,并支持近似最近邻(ANN)搜索。其核心意义在于:当大语言模型将文本、图片或代码转换为向量表示后,pgvector 可以直接在 PostgreSQL 中完成相似度检索,省去了独立部署 Pinecone、Milvus 等专用向量数据库的成本与架构复杂性。MVCC(多版本并发控制) 则是 PG 处理并发读写的核心机制——每次写操作不覆盖原数据,而是生成新版本,读操作始终读取一致性快照,从而避免读写互相阻塞。这一机制使 PG 在高并发 AI 推理服务中依然能保持稳定的读取性能。WAL(预写日志) 是 PG 持久性与高可用的基础:所有数据变更在写入磁盘前先追加到日志,既保证崩溃恢复,也是流复制与逻辑复制的数据来源。
课程学习路径设计
这套 PostgreSQL 实战课程并非只教几条命令或堆砌理论概念,目标是帮助学习者建立一套可落地、能用于真实项目的完整能力体系。整体分为三部分:
第一部分:从零搭建环境
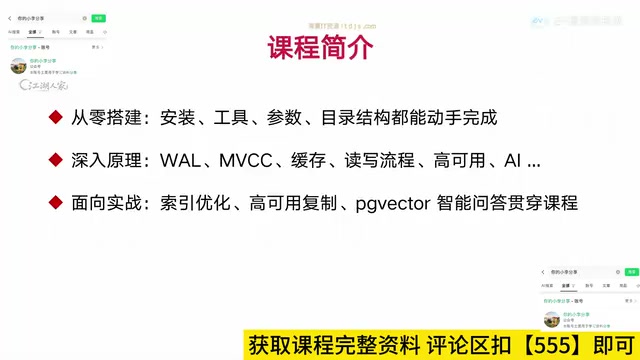
很多人学数据库第一关就卡在环境搭不起来、工具不会用、配置项看不懂。课程从零开始完成 PG 的基础部署安装,讲解配套工具使用、常见参数配置以及目录结构理解,先解决"跑起来、动手操作"的问题。
第二部分:核心原理剖析
环境就绪后进入核心原理,包括 WAL、事务机制、索引原理、执行计划分析等。理解原理,才能在遇到问题时知其所以然。
第三部分:企业级实战
最后进入实战场景:索引优化、慢查询诊断、备份恢复、安全权限、高可用等。同时将向量、图、智能问答等 AI 相关能力纳入主线,让学习者不仅掌握传统 PostgreSQL,也理解它如何支撑 AI 应用。
这门课适合哪些人
课程主讲者在 PG 领域深耕近十年,是《PostgreSQL 14 Internals》中文版译者,同时参与维护 "Postgres How-to in Chinese" 项目,积累了丰富的内核与最佳实践经验。
课程主要面向三类人群:
- 具备基础计算机操作能力、希望掌握 AI 时代首选数据库的学习者;
- 日常从事数据库开发运维的技术人员;
- AI 应用开发者,或需要理解向量数据库原理、智能问答背后数据能力的从业者。
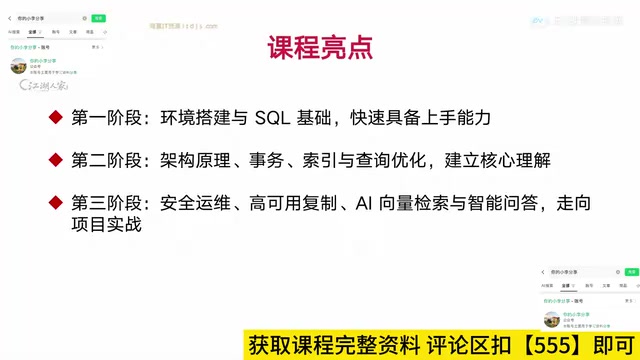
整条学习路线从环境搭建、SQL 基础,到架构原理、事务索引,再到优化运维与 AI 实战,强调"实践驱动"——每个关键能力都配合真实命令案例与操作演示,让人既知道怎么做,也明白为什么这么做。
最终目标是实现从"会用数据库"到"懂用数据库"的跨越:懂原理、能优化、会运维,并能具体落实到 AI 应用之中。对于想在 AI 时代补齐数据库能力的开发者来说,系统掌握 PostgreSQL 无疑是一项扎实而有价值的核心技能。
相关推荐
机器人替代人类:74%工作可胜任,为何仅0.3%被自动化?
Anthropic估算机器人已能完成美国74%的体力工作,但仅0.3%的工作用机器人更划算。本文解析技术可行性与经济可行性之间的鸿沟,以及安装、维护、可靠性等隐性成本如何阻碍机器人替代人类。
iPhone 18 Pro深度评测:性能翻倍,AI功能成最大亮点
基于LTT深度评测,解析iPhone 18 Pro的A20 Pro芯片性能跃升、续航充电改进、可变光圈相机与Apple Intelligence实用化进展,并给出换机建议。

2026年CNN项目创意:打造作品集的实用指南
针对2026-27年作品集需求,整理四个CNN项目方向:农业病害检测、医学影像可解释性、视频动作识别和混合CV管道,并给出让项目脱颖而出的工程习惯建议。