AI世界杯祖传BUG挑战赛C组首战:Grok 4.6力压Kimi K3

主流大模型编程能力横评:Grok 4.6稳定发挥夺魁,Step 3.7 Flash因误判复杂度出局。
「AI世界杯祖传BUG挑战赛」C组通过白银、黄金、钻石三道递进难度的代码修复题,对 Kimi K3、Grok 4.6、DeepSeek V4 Pro 和 Step 3.7 Flash 四大模型进行了横向评测。白银题四者全部通关,黄金题 Grok 4.6 一击命中拉开差距,钻石题涉及 AOP 切面、缓存与复杂业务逻辑耦合,Step 3.7 Flash 两度因用时极短误判难度而失败最终出局。最终 Grok 4.6 以5:3战胜 Kimi K3,DeepSeek V4 Pro 胜出 Step 3.7 Flash,两队各积2分。赛果揭示:在复杂 BUG 场景下,稳定性与合理的任务规划比单纯的推理速度更为关键。
一场别开生面的AI「祖传BUG」对决
所谓「AI世界杯祖传BUG挑战赛」,本质是一档用趣味竞技形式评测主流大模型编程能力的横向对比实验。规则简单直接:给每位「选手」(即大模型)下发难度递进的BUG修复任务,看谁能在有限的修复机会内把问题真正解决。这种拟人化的赛事包装,让原本枯燥的模型代码能力测试变得颇有观赏性。
本轮登场的C组四位选手分别是:Kimi K3、Grok 4.6、DeepSeek广告 V4 Pro(视频中戏称「威斯普肉」)以及 Step 3.7 Flash。对阵表为 K3 对战 Grok 4.6、DeepSeek V4 Pro 对战 Step 3.7 Flash。所有选手的思考模式均开到最大档位,力求呈现各模型的最强表现。
比赛设置了三道难度递进的题目:白银BUG(S003,单次机会,答对得1球)、黄金BUG(G003,两次机会,答对得1-2球)、以及钻石BUG(D001,三次机会,答对得1-3球)。其中钻石题被点名为最硬的骨头——它「融合了业务逻辑、缓存和AOP切面的问题」,是典型的复杂耦合场景。
白银BUG:四位选手集体通关
首轮白银题相对基础,考验的是模型对简单缺陷的快速定位与修复能力。四位选手都在10分钟内交出了答案,速度上出现了一个小意外:以「火星速度」著称、全程反复强调「Plan」的 Grok 4.6,这次反而是最慢的,用时9分32秒;而一贯淡定、习惯先列 To-Do List 的 Step 3.7 Flash 以4分26秒夺得最快,DeepSeek V4 Pro 用时5分37秒,Kimi K3 则用了7分44秒。
验证环节没有悬念——四位选手全部答对,各入一球。白银题的集体通关也印证了当前主流大模型在基础代码修复上的能力已趋于成熟,真正拉开差距的往往是更复杂的场景。正如解说所言:「四位选手都成功了一半,那就等于没成功」,戏剧性从黄金题才真正开始。
黄金BUG:比分意外拉开
黄金题的难度陡增,四位选手的表现开始分化。Step 3.7 Flash 依旧按部就班地列 To-Do List,并启动了两个子代理,显示它意识到了这道题的复杂度。DeepSeek V4 Pro 则全程用中文思考,虽然过程「看不太懂」,但思路清晰。
第一轮验证中,只有 Grok 4.6 一击命中,直接拿下两球,展现了极强的稳定性。其余三位——K3、V4 Pro、Step 3.7——都「打在门框上」,全部未能通过。进入第二轮修复后,DeepSeek V4 Pro 成功拿下一球,而 Kimi K3 和 Step 3.7 Flash 两轮机会用尽仍未修复,黄金题颗粒无收,被判定为失误。
这一轮结束后比分骤然拉开:Grok 4.6 三球、DeepSeek V4 Pro 两球、Kimi K3 一球、Step 3.7 一球。解说也直言这是「不太符合常规」的表现,尤其是被寄予厚望的 K3 状态明显不佳。值得关注的是,赛事组从小组赛第二轮起,还在提示词中加入了各选手的积分情况,试图观察积分压力是否会影响模型的表现。
钻石BUG:复杂耦合下的终极考验
钻石BUG是全场难度天花板,涉及AOP切面、缓存与复杂业务逻辑的耦合,极具迷惑性。第一轮,四位选手的定位速度差异巨大:Step 3.7 Flash 仅用2分钟就交卷,且这次没有列 To-Do List——这被解说视为「不好的信号」,大概率是把这道硬题误当成了简单问题。
第一轮验证结果不出所料,四位选手全军覆没。这在复杂耦合类BUG上属于正常现象。第二轮成为分水岭:Kimi K3 花了8分钟,凭借「2.8万亿参数」的底子成功修复,拿下两球;Grok 4.6 用25分钟同样答对,锁定胜局。而 DeepSeek V4 Pro(29分钟)和 Step 3.7 Flash(仅1分20秒)第二轮均未通过——Step 3.7 的极短用时再次暴露了它对题目复杂度的严重误判。
在追加的第三轮修复中,DeepSeek V4 Pro 用约20分钟终于攻克钻石题,再入一球,交出白银、黄金、钻石各进一球的均衡答卷;Step 3.7 Flash 则「打到门柱上」,遗憾出局。
AOP(面向切面编程,Aspect-Oriented Programming)是一种将横切关注点(如日志、权限、事务、缓存)从核心业务逻辑中剥离出来统一管理的编程范式。在 Java/Spring 生态中,AOP 切面通常以注解或配置的方式拦截方法调用,在方法执行前后插入额外逻辑。当 AOP 切面与缓存机制同时存在时,极易产生执行顺序、代理对象、缓存键生成等方面的隐蔽耦合问题——例如,切面可能在缓存命中后直接返回,导致某些业务校验被跳过;或者缓存的存储时机与切面的事务边界不一致,引发数据不一致。这类 BUG 的迷惑性在于单独测试每个组件时均表现正常,只有三者同时作用于同一请求路径时才会触发,因此极难通过静态代码审查发现,需要对整个调用链路有全局性理解才能准确定位。
最终战果与观察
本轮C组最终成绩:Grok 4.6 以 5:3 战胜 Kimi K3,DeepSeek V4 Pro 以并列积分优势赢下 Step 3.7 Flash。Grok 4.6 与 V4 Pro 各积2分,Kimi K3 与 Step 3.7 Flash 积0分。
从这场对决可以提炼出几点值得玩味的观察。其一,基础代码能力已成主流模型的标配,白银题的集体通关说明简单缺陷修复不再是区分度所在。其二,稳定性比爆发力更关键——Grok 4.6 在黄金题一击命中、钻石题稳扎稳打,全程没有明显失误,这种「稳」正是解说反复强调「整个赛季稳定才是走得远的关键」的注脚。其三,Step 3.7 Flash 的翻车揭示了一个有趣的模型行为:过快给出答案往往意味着对问题复杂度的误判,而合理的规划(To-Do List、子代理)反而是复杂任务成功的前提。
需要提醒的是,这类拟人化评测更多是趣味性的横向对比,单场比赛结果并不能完全代表模型的真实工程能力。样本量、题目设计、提示词工程等因素都会影响结果,正如解说所说:「一次比赛的输赢说明不了什么问题。」但作为观察不同大模型在真实复杂BUG场景下表现差异的一个窗口,这样的对比仍具参考价值。
相关推荐
DeepSeek V4.1 Flash对决GPT-6 Astra:四项实测谁更强
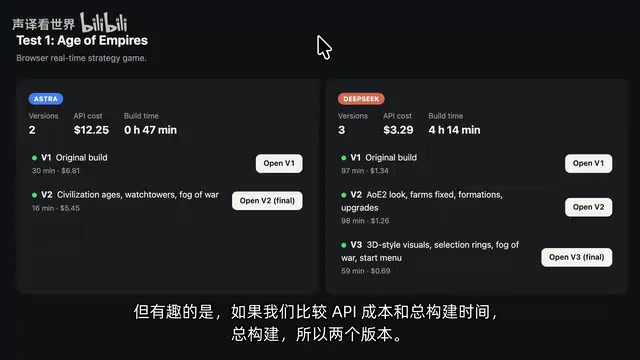
DeepSeek V4.1 Flash与GPT-6 Astra实测对比:通过游戏、3D网站、预约应用和Blender卡车动画四项任务,横向评测两大模型在质量、成本、构建时间和迭代能力上的差异,DeepSeek便宜6倍但Astra速度快首次成功率高。
Solid:拥有独立电脑、账户与预算的AI智能体
Solid 是登上 Product Hunt 榜首的 AI 智能体产品,让智能体拥有独立的电脑、账户和预算,自主构建应用、自动化工作流并完成复杂长周期任务。本文解析其核心能力与定位差异。
Naise AI:能真正执行任务的自主营销智能体
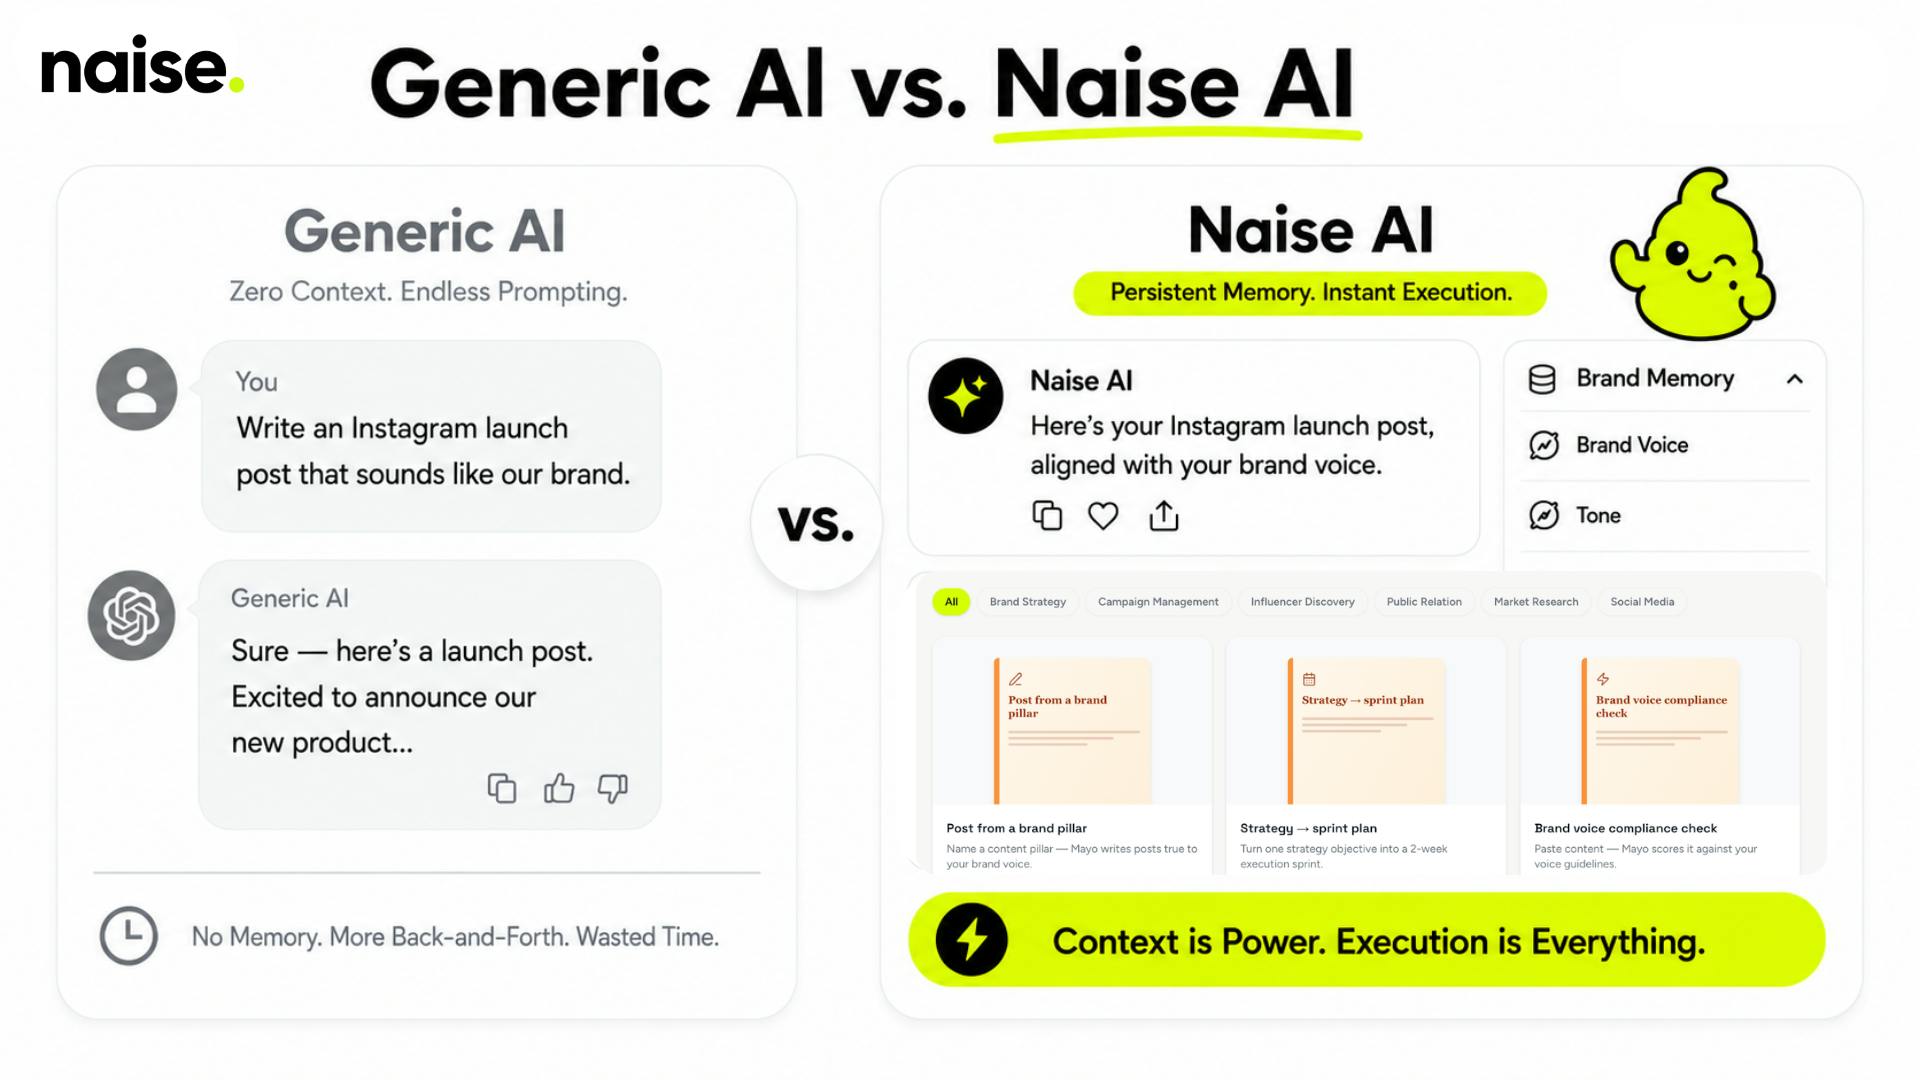
Naise AI 是一款主打自主执行的营销智能体,通过持久记忆锁定品牌调性、提示词剧本降低门槛,覆盖网红对接、媒体pitch和社交内容排期,宣称每周省下40+小时,登上 Product Hunt 当日第2名。