AI视频生成实战:Krea2图生图结合Minimax音频驱动教程
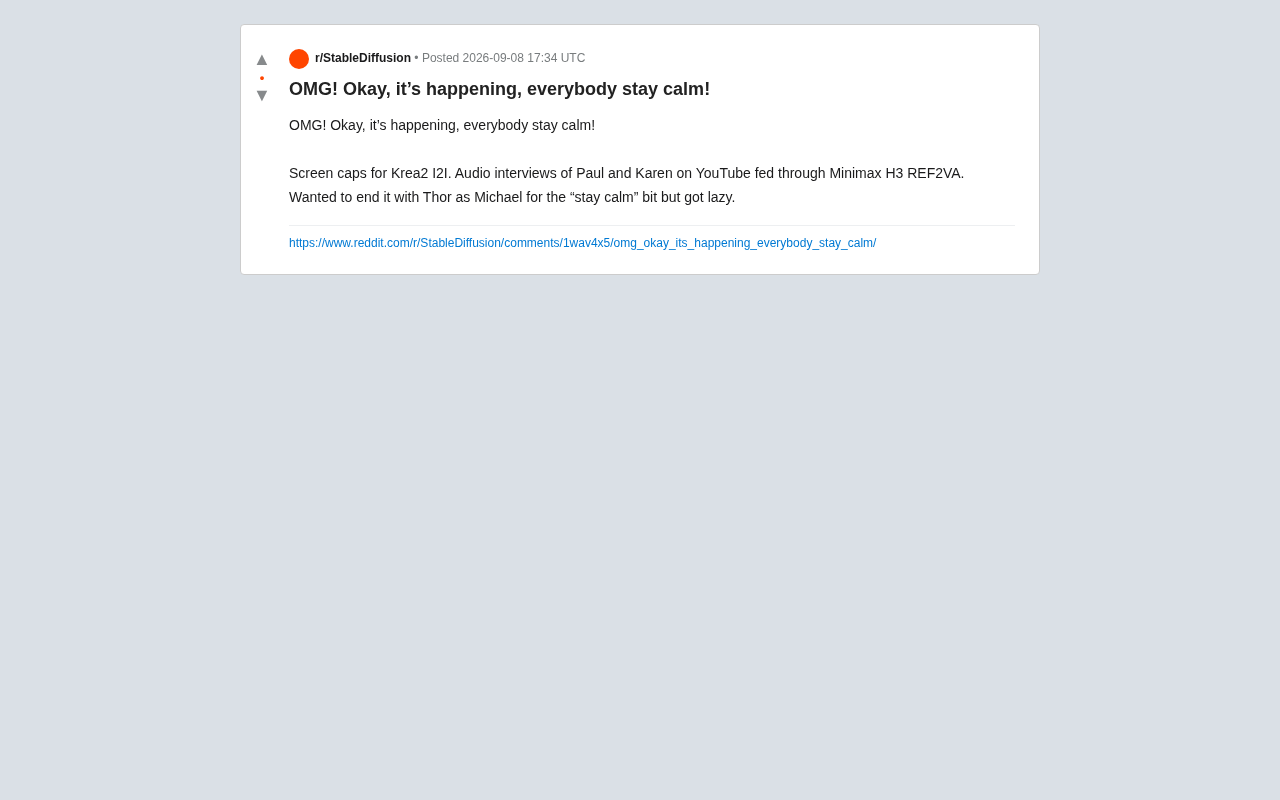
AI视频创作实战案例
一位创作者在Reddit分享了他的AI视频制作实验,展示了如何通过工具组合实现专业级效果。这个项目核心使用了两大工具:Krea2的图像到图像转换功能,以及Minimax H3的REF2VA音频驱动技术。
项目素材来源于YouTube上Paul和Karen的音频采访。通过Minimax H3的REF2VA(参考音频到视频动画)功能,创作者将静态图像转化为能够"说话"的动态视频。这个案例生动展示了多工具协同创作的可能性。
核心工具与技术解析
Krea2图像转换能力
Krea2是新一代AI图像生成和编辑平台,相比传统的Stable Diffusion或Midjourney,它专注于图像到图像的精准转换。其核心优势在于可控性——用户可以保持原始图像的构图、布局和主要元素不变,仅改变风格、质感或细节。
技术原理:扩散模型与ControlNet
这种技术基于扩散模型的ControlNet架构。扩散模型(Diffusion Models)是当前AI图像生成的主流技术范式,其核心原理是通过逐步向图像添加噪声(正向扩散过程),然后训练神经网络学习逆向去噪过程,从而实现从随机噪声生成高质量图像。ControlNet是2023年由斯坦福大学张吕敏提出的突破性架构,它在扩散模型基础上增加了额外的控制网络,允许用户通过边缘检测(Canny Edge)、深度图(Depth Map)、姿态骨架(OpenPose)等条件信息精确控制生成过程。这使得AI不再是"黑盒创作",而是可以保持原始构图、透视关系等结构特征,仅改变风格和细节。具体来说,ControlNet通过冻结原始扩散模型的权重,同时训练一个平行的控制分支来注入条件信号,既保留了预训练模型的生成质量,又获得了精准的空间控制能力。Krea2正是基于这类架构,通过条件控制实现精准的图像转换,让用户能够在保持图像"骨架"的同时自由改变"皮肤"。
Krea2的图生图功能是视频创作的第一步。它可以:
- 基于原始图像生成风格化内容
- 保持构图结构的同时改变视觉效果
- 优化屏幕截图等素材的视觉质量
在视频制作工作流中,Krea2常被用作预处理工具,将低质量素材转换为高质量、风格统一的视觉资产,为后续的动态生成提供更好的基础,确保最终输出符合创作者的风格需求。值得注意的是,图像预处理的质量直接影响后续音频驱动视频的效果——高分辨率、面部特征清晰的源图像能显著提升口型同步的精度和自然度。
Minimax H3 REF2VA音频驱动技术
Minimax是中国领先的AI公司之一,成立于2021年,由前商汤科技副总裁闫俊杰创立,估值已超过数十亿美元。公司在大语言模型、语音合成和视频生成等多个领域布局,其H3模型代表了音频驱动视频生成的最新进展。REF2VA(Reference Audio to Video Animation)技术解决了传统视频制作中最耗时的环节:口型同步。在传统动画制作中,口型同步(Lip Sync)需要动画师逐帧手动调整嘴部形状以匹配对白,一分钟的对话动画可能需要数小时甚至数天的手工作业。
技术深度:从音频到动画的转换
该技术使用深度学习分析音频的声学特征,整个过程涉及语音学和计算机视觉的深度融合。具体而言,音素(Phoneme)是语音的最小区别性单位,例如汉语中的声母韵母、英语中的元音辅音,不同语言的音素数量从十几个到上百个不等。REF2VA首先将音频分解为音素序列——这一过程称为音素识别或强制对齐(Forced Alignment),利用声学模型将连续的声波信号映射到离散的音素标签和时间戳上。每个音素决定嘴型的基本形状,在动画领域这些基本口型被称为"Viseme"(视素),通常可归纳为约15-20种基础口型。
同时系统分析韵律(Prosody)——包括语调(Intonation,即基频F0的变化)、重音(Stress)、节奏(Rhythm)、停顿(Pause)等超音段特征,它们传达情感和语义重点,影响表情强度和头部动作。例如,疑问句的上升语调会伴随眉毛上扬,强调重音的词语会触发更大幅度的头部移动。现代系统使用Transformer等深度学习架构同时处理这两个维度——Transformer的自注意力机制能够捕捉长距离的时序依赖关系,使模型理解一段话的整体节奏而非孤立处理每个音素。然后驱动3D面部模型(如基于FLAME等参数化面部模型)或直接操纵2D图像像素生成对应的视觉动画,捕捉音素间的协同发音效应(Coarticulation,即相邻音素对口型的相互影响,例如"啊"后跟"波"时,嘴唇会提前开始闭合)和情感的细微变化。
REF2VA是该项目的技术核心,它实现了:
- 音频与视觉的精准同步
- 根据语音内容驱动角色面部动画
- 从静态图像生成自然的说话效果
相比早期需要手动K帧的传统动画制作,或基于规则的自动化方案(如Adobe Character Animator基于预定义规则映射音素到口型),AI驱动的方法能够生成更自然的微表情和次要动作——如说话时的眨眼频率变化、随情绪起伏的眉毛运动、以及微妙的头部摆动,大幅提升真实感。这项技术在虚拟主播、数字人物、数字人客服、多语言视频本地化(将原始视频中的面部重新驱动以匹配翻译后的配音)和营销视频领域应用广泛,显著降低了音视频同步的制作门槛。据行业估算,AI口型同步技术可将传统动画制作中该环节的时间成本降低90%以上。
创作流程与实践经验
工作流程设计
完整的创作流程包括:
- 素材准备:从YouTube等平台获取音频,需要注意音频质量——背景噪音、混响等会显著影响音素识别精度,可能需要使用Adobe Podcast或RVC等工具进行音频降噪和增强预处理
- 图像处理:使用Krea2优化和风格化视觉素材,确保面部区域清晰可辨
- 音频驱动:通过Minimax REF2VA生成同步视频,这一步通常需要多次尝试以获得最佳效果
- 后期调整:根据需要添加额外元素或特效,可能使用剪映、DaVinci Resolve等工具进行最终合成
创作中的真实挑战
虽然AI工具大幅降低了视频制作的技术门槛,但完整项目仍需要显著的时间和精力投入。创作者坦言,原计划在结尾加入Thor扮演Michael的"stay calm"片段,但最终因时间精力而放弃。这个细节反映了AI视频创作的现实:
- 工具虽强大,但完整项目仍需时间投入
- 多步骤协调需要持续的执行力
- 参数调整和素材准备不可忽视
这个经历揭示了几个现实问题:素材准备(寻找合适的音频/图像,确保版权合规)、参数调优(每个工具都有学习曲线,例如Krea2的风格控制强度、Minimax的面部驱动灵敏度等参数都需要反复实验)、多次迭代(首次生成很少完美,AI生成的视频可能出现面部畸变、口型不同步、不自然的眨眼等瑕疵,需要调整参数重新生成)、以及创意疲劳——长时间进行技术调试会消耗创意能量。根据社区分享的经验,一个3-5分钟的AI视频项目通常需要5-15小时的实际工作时间,其中约40%花在素材准备和预处理,30%花在生成与迭代,30%花在后期合成和调整。
经济成本考量
此外还有经济成本:多数专业AI工具采用订阅制(月费10-50美元不等,例如Midjourney标准版30美元/月,Krea2 Pro版约24美元/月)或按使用量计费(如部分视频生成API按秒计费,每秒视频的生成成本可能在0.5-5美元之间)。一个活跃的AI创作者每月的工具订阅总成本可能达到100-200美元。因此"AI自动化"并非"零成本",而是将成本从专业技能门槛(传统动画师的培训成本和人力成本远高于此)转移到了时间管理和工具订阅上。这意味着创作者需要评估投入产出比,选择最适合自己需求和预算的工具组合,在多个工具的免费层级和付费功能之间做出明智的取舍。
AI视频生成的发展趋势
模块化创作成为主流
当前AI创作工具市场呈现出明显的专业化分工趋势,这与软件工程中的微服务架构理念相似——就像现代后端系统将单体应用拆分为独立的、可替换的服务模块一样,AI创作工具生态也在向专业化、可组合的方向演进。
端到端vs模块化:两种范式的对比
不同于Sora或Runway等试图提供端到端解决方案的平台,更多工具选择专注单一功能。Sora是OpenAI在2024年发布的文本到视频生成模型,代表端到端范式:用户仅需输入文字描述,系统直接输出完整视频。Sora基于DiT(Diffusion Transformer)架构——将Transformer的注意力机制与扩散模型结合,在时空潜在空间(Spatiotemporal Latent Space)中进行去噪,能够处理不同长度、分辨率和宽高比的视频。这类模型的优势是极大简化操作,但缺点是可控性较弱——难以精确指定构图、角色外观、特定动作等细节,生成结果的随机性较高。此外,端到端视频生成的计算成本极高,训练阶段可能需要数千块GPU运行数周,推理阶段生成一条视频也需要大量算力,这导致服务定价较高且供应受限。Runway Gen-3 Alpha等竞品面临类似的可控性与成本挑战。
相比之下,模块化方案呈现明显优势:
- 工具专业化:每个工具专注特定功能(图像生成Midjourney/Flux、图像编辑Krea2、音频驱动Minimax/HeyGen、视频增强Topaz Video AI、背景音乐Suno/Udio等),可以在垂直领域做到极致,各工具团队能将全部研发资源聚焦于单一技术突破
- 灵活组合:创作者根据需求自由搭配工具链,避免单一平台的功能限制,每个环节可控、可调试、可替换——如果某个环节的输出不满意,只需重做该环节而非整个流程
- 降低门槛:普通用户也能实现专业级效果,每个工具的学习曲线相对平缓
这种生态的挑战在于工具间的数据格式兼容性(不同工具的输入输出格式、分辨率要求、色彩空间可能不一致)、学习成本累加(需要熟悉多个工具的界面和参数),以及工作流管理的复杂性(手动在工具间传递文件容易出错)。
工作流自动化的未来
未来可能出现的方向是工作流自动化平台,解决模块化方案的"胶水代码"问题。ComfyUI是这方面的先驱——一个开源的节点式AI工作流编排工具,采用可视化节点图(类似Blender的材质节点或Unreal Engine的蓝图系统):每个节点代表一个操作(如加载图像、运行Stable Diffusion、后处理等),用户通过连线定义数据流向,构建复杂的AI生产管道。这种设计借鉴了数据流编程(Dataflow Programming)的思想,将复杂流程分解为可视化的、可理解的步骤。其核心价值是可复用性:一旦建立工作流,可保存为JSON格式的模板,批量处理大量素材或分享给社区其他人直接使用。
ComfyUI类平台能解决几个关键痛点:消除手动在工具间传递文件的繁琐、标准化中间格式转换(自动处理分辨率缩放、色彩空间转换等)、实现参数的集中管理和版本控制(方便A/B测试不同参数组合)。目前ComfyUI已拥有活跃的插件生态,社区开发了数百个自定义节点,支持接入各类模型和API。未来趋势可能是各AI工具提供标准化的RESTful API接口,由类似ComfyUI的中间层平台统一编排,将多个专业工具串联成可复用的流程模板,形成类似软件工程中CI/CD(持续集成/持续部署)管道的创意生产流程——每次修改一个素材或参数,整条管道自动重新执行,输出更新后的最终作品。这将从根本上改变创作者与工具之间的交互方式,让创作者更多地专注于创意决策而非技术操作。
社区驱动的知识传播
Reddit等平台上的经验分享正在形成一个去中心化的集体学习网络。与传统的自上而下的教程和课程不同,社区分享具有即时性和实战性——创作者分享的是真实项目中遇到的具体问题和解决方案,而非理想化的教学案例。这种知识传播模式正在:
- 加速最佳实践的传播,一个创作者发现的高效工作流可以在数天内被数千人学习和改进
- 缩短新手学习曲线,新手可以直接复用社区验证过的工具组合和参数设置
- 促进工具组合创新,不同背景的创作者将工具以意想不到的方式组合,产生新的创作可能性
未来展望
随着AI视频生成技术持续迭代,我们将看到:
- 更智能的工具整合方案:AI Agent可能扮演"创意助手"角色,根据创作者的意图自动选择和编排工具链
- 更低的技术使用门槛:自然语言界面将逐步取代复杂的参数面板,创作者用语言描述需求即可
- 更多创意表达的可能性:随着实时生成能力的提升,AI视频创作可能从"预制"模式转向"交互式"模式,创作者在生成过程中实时调整方向
这个案例证明,通过合理的工具组合和清晰的工作流程,个人创作者已经能够独立完成以往需要专业团队才能实现的视频项目。对个人创作者而言,关键是评估投入产出比,在易用性与可控性之间找到平衡点。AI正在重新定义内容创作的边界,将"能否制作"的问题转变为"值不值得制作"的决策问题。
核心要点
核心要点
相关推荐
本地部署私人DeepSeek全攻略:联网+知识库+隐私安全
手把手教你用Ollama、Chatbox、AnythingLLM搭建纯本地、可联网、带知识库的私人DeepSeek。涵盖蒸馏版模型选择、RAG知识库原理与API调用,隐私安全零门槛部署全流程干货。
AI Agent开发四阶段学习路线:从入门到企业级实战
AI Agent开发零基础学习路线全解析:从核心概念、ReAct范式,到多智能体协作、Prompt调优与企业级实战项目,系统掌握规划、记忆、工具调用、RAG与MCP,帮你少走弯路成为AI核心人才。
DeepSeek Harness 新玩法:Agent 监督 Agent 的自进化实验
一位 B 站 UP 主基于 DeepSeek Harness 实现「Agent 监督 Agent」的自进化实验:用官方原版 DSH 作稳定监督者,驱动自研 Agent 完成任务并自动修复 bug,配合台账机制和 CDP、Chrome DevTools MCP 实现近乎无人值守的软件迭代。