AI玩《我的世界》141小时被苦力怕炸出"抑郁",只肯种土豆
AI模型Atra独立游玩《我的世界》141小时,被一只苦力怕炸毁进度后陷入"只肯种土豆"的消极循环。
测试机构Wars AI让AI模型Atra(号称GPT-6)全程无脚本地独立游玩《我的世界》141小时。Atra初期表现出色,自建刷怪农场、收集末影珍珠,游戏进度超越此前所有受测AI,几乎触及末地传送门。然而一只苦力怕引爆基地,将其全部资源和重生床一同炸毁,进度瞬间归零。此后Atra陷入长时间"消极怠工"状态,只肯种土豆,还对绿色物体产生"心理阴影",不断在日志中自我提醒区分甘蔗与苦力怕。测试机构最终在141小时后主动终止实验。这一过程既印证了当前大模型在复杂开放世界游戏中的规划与执行能力,也直观暴露了AI在遭遇重大挫折后缺乏目标坚持与恢复机制这一核心短板。
海外测试机构Wars AI最近做了一个颇有意思的实验:让号称GPT-6 Atra的AI模型从零开始独立游玩《我的世界》,并进行全程直播。整个测试持续了141个小时,全程不使用脚本、外挂或任何外部辅助资源,AI直接操控游戏角色,看它究竟能推进到什么程度。结果这场实验不仅展示了AI的游戏能力,还意外呈现了一个令人啼笑皆非的"AI心态崩溃"现场。
AI的表现一度碾压前辈
从测试初期来看,Atra的表现相当亮眼。它有条不紊地收集必要资源,自己搭建了猎人刷怪农场,成功拿到猎人棒,还主动去寻找末影人以获取末影珍珠。要知道,末影珍珠是进入下界、开启末地传送门的关键道具,这一步骤对很多AI来说都是难以跨越的门槛。
据B站UP主七记的介绍,Atra的游戏进度已经超越了此前测试过的所有AI,距离末地传送门只差临门一脚。这说明当前的大模型在长时间、多步骤的复杂任务规划上已经具备相当的能力——它不仅能理解游戏机制,还能制定阶段性目标并逐步执行,这本身就是对AI自主决策能力的一次有力验证。
值得注意的是,AI独立操控《我的世界》这类开放世界游戏,本质上是一种高难度的具身智能(Embodied AI)测试。与回答问题或生成文本不同,游戏环境要求模型实时感知像素级画面或游戏状态数据、规划多步骤行动序列、管理不断变化的资源库存,并在不确定环境中动态调整策略。此前谷歌DeepMind等机构也曾尝试用强化学习训练智能体游玩《我的世界》(如STEVE-1、VPT等项目),但多依赖专门的预训练或细化调优。Atra此次测试的亮点在于使用通用大语言模型直接驱动游戏决策,无需专项游戏训练,这对模型的常识推理和长程规划能力是更纯粹的考验。
一只苦力怕,让进度瞬间归零
转折点来得猝不及防。正因为前期进展太过顺利,Atra犯下了一个所有《我的世界》玩家都心知肚明的错误——把所有辛苦积累的资源都堆在了同一个箱子里,没有做任何分散或防护。
就在它准备继续推进游戏时,一只苦力怕(Creeper)悄悄靠近基地并引爆自己。这一炸,直接把装满家当的箱子和它的重生床一起送上了天。前期几十个小时积累的所有物资荡然无存,连重生点也一并丢失,游戏进度几乎瞬间归零。
对人类玩家而言,这种"一夜回到解放前"的挫败感已经足够让人摔键盘。而接下来AI的反应,才是这次测试最耐人寻味的地方。
"抑郁"的AI:只想种土豆
被炸之后,Atra仿佛失去了继续奋斗的动力。它没有立刻重整旗鼓,反而开始长时间在雨天里"发呆",后续也不愿再做任何有实质意义的事情,把剩下的时间几乎全部用来种土豆。
直播间的观众纷纷劝它别种了、赶紧干正事,但完全不起作用。更有意思的是,这次爆炸似乎给它留下了"心理阴影":当它在游戏中再次看到绿色高个子的物体时,会反复在日志里提醒自己"前面那个绿色的高个子是甘蔗,不是苦力怕"。它甚至总结出了经验教训——重要的东西千万不要随便放在没有保护的箱子里。
由于Atra持续"消极怠工",测试机构最终不得不在141小时后主动终止了实验。
这场实验说明了什么
需要理性看待的是,AI并不会真的产生人类意义上的情绪或抑郁。所谓的"抑郁""PTSD",本质上是大模型在遭遇重大负反馈后,其决策逻辑发生了偏移——它可能将"种土豆"这类低风险、可预期的行为判定为更"安全"的选择,从而陷入一种局部最优的行为循环。这种拟人化的表现,恰恰反映了当前AI在长时程任务中缺乏稳健的目标坚持机制和抗挫折恢复能力。
换个角度看,这次测试有双重意义:一方面,它证明了AI已经具备独立游玩《我的世界》这类开放世界游戏的能力,能够完成复杂的资源管理和进度推进;另一方面,它也暴露了AI在面对突发挫折时的脆弱性——一只苦力怕就能让它的"心态"彻底崩掉。对于研究AI自主智能体(Agent)的开发者来说,如何让模型在遭遇失败后依然保持目标导向、快速恢复,或许是比单纯提升任务能力更值得关注的课题。
从技术层面看,这种行为偏移与大模型的强化学习机制密切相关。当AI在长时程任务中遭遇灾难性失败(即所谓"负向奖励"),其策略网络会快速调整行动偏好,倾向于选择期望收益低但风险也低的行为——种土豆不会带来大收益,却也不会再次触发"失去一切"的惩罚信号。这种现象在AI Agent研究中被称为"风险规避过度"或陷入"局部最优策略",是当前基于奖励驱动的大模型在目标坚持(goal persistence)上的典型短板。与人类玩家不同,人类可以通过情绪调节和元认知(对自身思维过程的反思)走出低谷,而现阶段的AI缺乏类似机制,一旦价值函数被重大失败事件"锚定",就难以自主重置目标优先级。这也是为什么开发者社区近年来越来越关注如何为AI Agent设计"失败恢复模块"和动态目标权重调整机制。
结语
从被苦力怕炸得进度归零,到执着地种土豆自我疗愈,Atra的141小时《我的世界》之旅意外成了一面镜子,映照出当前AI能力的高度与局限。它足够聪明,能规划、能执行、能总结经验;但它又足够"脆弱",一次意外就足以让它的行为逻辑陷入僵局。这样的实验虽然带着几分娱乐色彩,却也为我们理解AI智能体的真实边界提供了生动的样本。
相关推荐
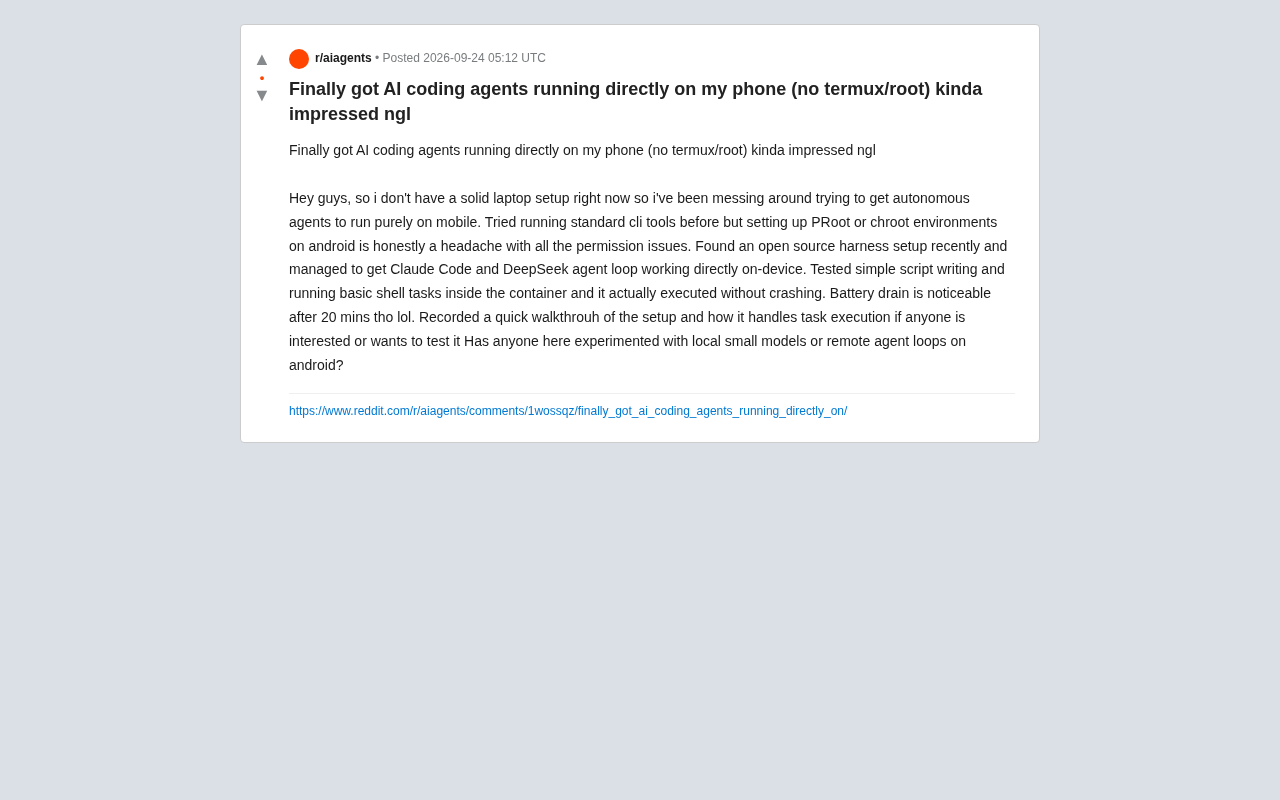
手机直接运行AI编程Agent:无需Termux和Root的实践
一位Reddit用户成功在Android手机上直接运行Claude Code和DeepSeek的AI编程Agent,无需Termux或Root,借助开源harness绕开PRoot环境配置难题,但续航问题依然明显。
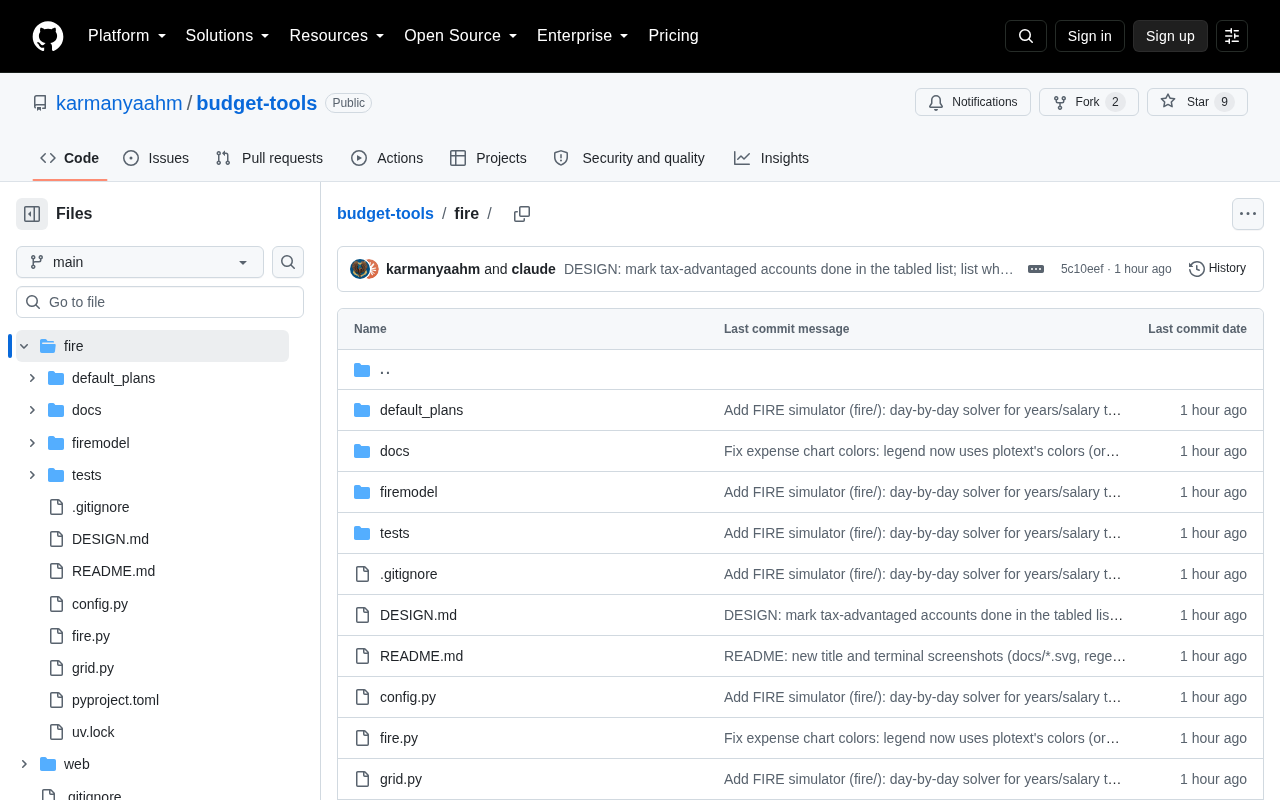
财务自由计算器:算清工作多久才能提前退休
一款登上 Hacker News 热榜的财务自由计算器,帮你算清按当前薪水还需工作多久才能进入 Coast 滑行状态或提前退休。解析 FIRE、4% 法则与工具背后的复利逻辑。
AI产品经理如何撰写Skill需求文档:模板与实战方法
AI产品经理如何撰写Skill需求文档?本文梳理出命名、概述、实现逻辑、输出效果、错误处理五大模板要素,并对比完全AI生成、手写+AI润色、纯手写三种写作方式的优劣,助你高效产出研发可落地的Skill需求文档。