AI写的测试90%是伪逻辑?三大盲区与探针实战

AI生成的单元测试约九成在变异后仍通过,覆盖率是假象,需用变异测试与边界探针重建质量防线。
文章基于B站一期技术分享,指出AI生成测试的普遍隐患:大量测试只覆盖正向路径,断言薄弱、边界缺失、副作用未验证,实测约90%的测试在变异后仍然通过,说明它们并未真正锁住逻辑。作者将问题拆为假覆盖、逻辑空洞、副作用缺失三层盲区,并警告Mock过度会让测试从验证业务变成验证Mock。方法上给出四把探针武器:变异测试优先、边界探针跟进、覆盖率兜底、副作用钩子防生产,并以变异通过率低于70%作为测试存在空洞的判定标准。文章强调覆盖率不等于正确性,任何快速产出、快速合并的测试流程都值得用探针重新审视。
AI生成代码已经越来越普遍,但AI写的测试真的能守住质量防线吗?B站一期技术分享给出了一个略显刺眼的结论:大量AI生成的单元测试只覆盖了正向路径,反向和边界情况几乎全漏。更关键的是,作者实测发现约90%的测试在经过变异后仍然通过——这意味着测试根本没有"锁住"逻辑,只是看起来通过了。
为什么"权力测试"反而危险
视频里用了一个词叫"权力测试",指的是那种追求快速生成、写完就合并的测试。AI写测试的动机和人类工程师不同:它倾向于输出"输入-断言输出"的浅层结构,因为这类模式在训练数据中最常见、最容易被判定为"正确"。于是副作用状态、异常分支、边界值这些真正容易出问题的地方,反而成了盲区。
危险在于,覆盖率数字会给人一种"已经测完了"的错觉。多数团队卡在前两个盲区就停下了,以为质量有保障,实际上核心逻辑根本没被验证到。
三大盲区:假覆盖、逻辑空洞、副作用缺失
作者把AI测试的问题拆成层层递进的几类:
假覆盖是最表层的问题——测试跑过了,覆盖率涨了,但断言本身很弱,等于没测。
逻辑空洞更隐蔽。测试代码结构完整,但断言没有真正校验业务规则,比如只检查返回值不为空,却不检查返回值是否正确。
副作用缺失最容易坑到生产环境。当测试涉及数据库写入、外部API调用、状态变更时,AI生成的测试往往只验证了返回值,而没有验证这些副作用是否按预期发生。
还有一层是边界值探针的缺失。这是"最后一刀"——极端输入、空串、越界参数,恰恰是真实故障的高发地带。
覆盖率通常指行覆盖率、分支覆盖率等指标,由 JaCoCo、Coverage.py 等工具统计。它回答的是“哪些代码被执行过”,而不是“执行结果是否被正确断言”。一段代码可以 100% 被执行却没有任何有效断言,这就是“假覆盖”的根源。边界值分析则是黑盒测试的经典方法:对每个输入区间取最小值、最大值、略小于最小值、略大于最大值、空值、None 等点位,因为 off-by-one、空集合、整数溢出等故障几乎都发生在边界附近。参数化测试(如 Pytest 的 @pytest.mark.parametrize)正是批量打这些边界点的常用手段,能让边界探针以极低成本覆盖大量组合。
Mock一过界,测试就变味
视频里有一句很到位的判断:Mock一过界,测试就从验证业务变成了验证Mock。当测试对象依赖数据库或外部API时,如果探针没有真正打到这些外部依赖上,覆盖率再高也只是自欺欺人。
这也解释了为什么"全Mock"的测试在老做法里看起来很美,在新做法里却需要被重新审视。
Mock 在单元测试中指用替身对象替换真实依赖(数据库、HTTP 客户端、消息队列等),使测试可以脱离外部环境独立运行。适度 Mock 能隔离不确定性,但一旦把被测对象依赖的所有外部交互都替换掉,测试实际验证的只是“被测代码是否按预期调用了 Mock”,而非“真实依赖下的行为是否正确”。这带来两个后果:一是断言容易退化为对 Mock 调用参数的检查,业务规则被架空;二是数据库约束、序列化格式、网络超时等真实环境问题完全暴露不出来。业界通常用“测试奖杯”来平衡:单元测试少而精、集成测试覆盖真实依赖、端到端测试兜底关键链路,避免测试金字塔倒置成“冰淇淋筒”。
实操:四把探针武器
方法层面,作者给出了具体的工具组合,优先级依次是:
- 变异测试:用P-Test或Cosmo跑变异,观察变异通过率。这是判断测试是否真有约束力的核心手段。
- 边界探针:用参数化测试专门打None、空串、极端值这类边界输入。
- 覆盖率:作为兜底参考,而不是质量指标。
- 副作用钩子:防止生产环境被测试的副作用坑到。
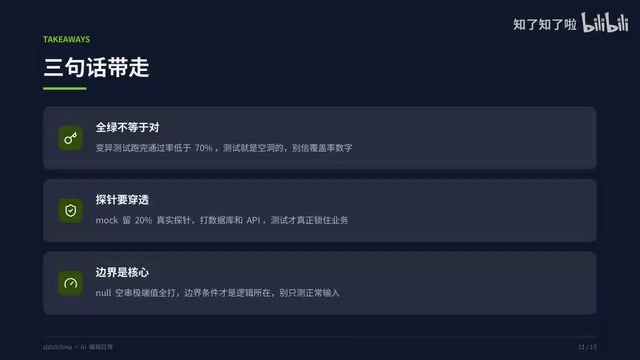
工具不用多,核心是打对位置。作者给出的判定标准很直接:变异通过率低于70%,说明测试存在空洞,探针没打到位。
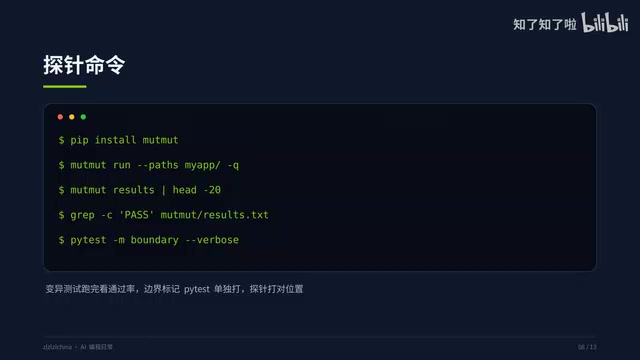
落地流程可以概括为几条命令:装依赖、跑变异看通过率、用Pytest单独打边界标记。流程本身不复杂,难的是把它变成习惯。
变异测试(Mutation Testing) 的原理是:向源代码注入微小的人为缺陷(如把 > 改成 >=、把 + 改成 -、删除一行语句),生成一批“变异体”,然后用现有测试集去跑。如果某个变异体让测试失败,说明测试“杀死”了这个变异,证明它对该段逻辑有约束力;如果变异体存活(测试仍通过),则说明测试没有覆盖到被改动的那行逻辑。变异通过率 = 存活变异体数 / 总变异体数,数值越低说明测试越强。P-Test 与 Cosmo 是 B站内部用于 Java/Go 等服务的变异测试平台,负责自动生成变异体、调度测试并汇总分数。相比覆盖率,变异分数衡量的是“断言是否真的在检查业务规则”,因此更难被假覆盖糊弄。
老做法 vs 新做法:四组对照
作者用四组对比讲清了差异:
- 覆盖率 vs 变异分数
- 全Mock vs 真探针
- 正向用例 vs 边界用例
- 写完不碰 vs 持续变异
新做法不是推翻老做法,而是在老做法之上加一层探针。写完测试就放心,和写完测试打探针,是两种完全不同的质量心态。前者看覆盖率数字,后者看变异分数——差距就在这。
三句话收束
视频最后用三句话总结了核心:覆盖率不等于正确性,探针要穿透到真实依赖,边界是核心战场。
下次AI帮你生成测试,别急着合并。先跑一遍变异测试和边界探针,看看那些测试是真的锁住了逻辑,还是只是看起来通过了。作者在结尾还预告了后续内容,会聊AI修bug的循环内契,以及怎么让AI改bug不引入新bug。
对工程团队来说,这个思路的价值不只在AI生成测试——任何"快速产出、快速合并"的测试流程,都值得用探针重新审视一遍。
相关推荐

AI能直接读懂神经网络权重:模型能力已超出预期?
Reddit开发者实验显示,语言模型能直接阅读神经网络权重并推断其功能。Astra、Opus 5.5和Muse Spark 1.3均通过测试,引发对模型泛化能力与训练来源的讨论。

印度微短剧市场爆发:EloElo获NBCUniversal 8000万美元投资
印度社交娱乐平台EloElo获NBCUniversal 8000万美元投资,加码微短剧平台StoryTV。StoryTV月活超3300万,印度微短剧市场正吸引全球资本关注。

多旋翼无人机声学检测:融合手工特征与预训练嵌入
研究揭示无人机声学检测中随机划分导致数据泄漏,提出源不相交评估协议下融合手工声学特征与YAMNet嵌入的堆叠集成方法,准确率达95.29%,为低成本无人机探测提供可靠基准。