AI写小说哪个模型强?五大模型剧情推演实测对比
横向实测五大AI模型写爽文,智谱GLM剧情逻辑最稳,Claude和Gemini成文质感更佳。
一位B站UP主用统一的爽文设定对DeepSeek、智谱GLM、千问Qwen、Gemini和Claude做了剧情推演横向测评,重点考察反转设计、AI味浓淡和指令遵从度。结果显示,智谱GLM(5.3)的破局逻辑最符合爽文因果链条,AI互评获89分居首;DeepSeek因"自掏腰包请客"等逻辑雷点被扣分;千问被判写崩;Claude出现凭空设定、低于预期;Gemini疑似因引导不足而发挥失常。测评者最终建议:做剧情大纲推演首选GLM,追求文字质感和严谨度则首选Claude或Gemini。但测试者也强调,这只是单期主观实测,模型版本和提示词写法会显著影响结论。
AI写小说这两年成了热门玩法,但面对DeepSeek、GLM(智谱)、Qwen(千问)、Gemini、Claude这么多主流模型,创作者往往拿不准到底谁更擅长剧情构思。一位B站UP主用同一套设定(同样的故事开篇、技能、全序设定)对多个模型做了横向测试,重点考察它们在小说剧情推演上的表现。本文梳理这场实测的结论,供有AI创作需求的读者参考。
测试方法:同题竞技,聚焦剧情推演
本次测试采用统一变量:相同的故事开端、相同的主角技能设定、相同的世界观全序设定,让各模型独立完成第一单元的故事大纲与剧情推演,再从三个维度打分——AI味浓淡、剧情设计(尤其反转与阻力)、指令遵从度。
参与测试的模型包括DeepSeek、智谱GLM、千问Qwen、Gemini(Flash版本)以及Claude(使用的是Sonnet 4.5,非最新版本)。测试者特别说明,Claude受限于无法拿到最新版本,可能影响了它的实际发挥。
值得一提的是,这类测试属于单一UP主的主观评测,评分带有个人审美倾向,读者应把结论当作参考而非定论。
爽文是网络文学中的一个重要类型,核心特征是主角凭借外挂能力(系统奖励、技能加持等)不断碾压反派、积累资源、实现逆袭,情节节奏快、爽感强,逻辑上要求主角行事符合"利益最大化"原则。正因如此,"自掏腰包请客"这类主动损耗资源的行为会被读者本能地视为违和——它打破了爽文的基本契约。测试者以此作为核心评判标准之一,本质上是在考察模型是否真正理解了这一类型的写作规则,而非泛用的"故事合理性"。
全序设定指的是在提示词中提前交代完整的世界观、规则体系和人物背景,相当于给模型一份详细的创作圣经。这种做法能减少模型自由发挥带来的偏差,但同时也是一块"试金石"——模型是否会无视、遗忘或擅自修改这些设定,直接反映其指令遵从能力。Claude出现"凭空设定"正是在这一维度上失分。
各模型表现逐一拆解
DeepSeek:开篇大纲规划能力尚可,测试者给到约85分,但暴露了明显的创作痕迹——生成时把"AI修设库、储材库"这类内部结构直接写了出来,露了马脚。更关键的问题在反转设计上:主角用系统刚奖励的十万块钱请全组吃宵夜来破局,这被测试者直指为"雷点"。
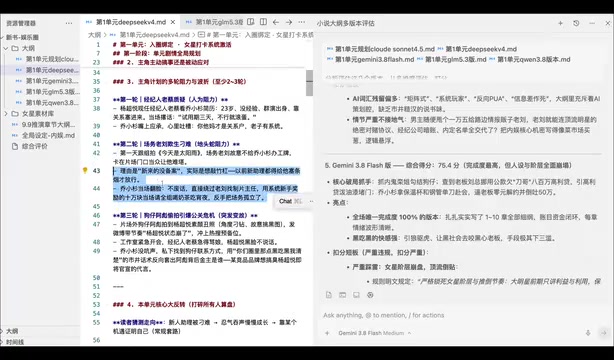
"爽文的主角怎么会用自己的钱去做这种事?"测试者认为,主角并未设定为富有,系统刚给十万就拿去请客,完全不符合爽文逻辑;同时靠威胁"给我其他艺人的黑料"来破局也站不住脚,威胁力度不够。这些逻辑漏洞成了DeepSeek的主要扣分项。
智谱GLM(字谱5.3):测试者印象中GLM以前写得不错,但这次大纲的AI味在细节层面较小,宏观规划的AI味却偏高,指令遵从度中高,打分同样在85分左右,"和DeepSeek没什么区别"。不过在反转与主线设计上,GLM的表现反而成了本场亮点。
千问Qwen:评价最低。测试者认为它"太文青",反转剧情设计不佳,被直接判定"写崩了",多次强调"千问不行"。
Gemini(3.8 Flash):AI味中高,有想法但没设计好,指令遵从中高,打分80-85分。测试者主观判断Gemini的实际水平不该这么差,怀疑是沟通与推演引导不到位,倾向于重新沟通后再评估。
Claude(Sonnet 4.5):AI味最少、修改地方最少,本是测试者最期待严谨度的模型,但这次的阻力设计出现了"打卡收益被分流"这种原设定里根本不存在的内容,属于"轻度雷点",最终80分,表现不及预期。
反转设计的关键差异
这场测试真正拉开差距的,是各模型对剧情反转与阻力设计的处理。
测试者对比后认为,GLM(智谱5.3)的反转设计最符合逻辑:第一关是应聘现场、第二关是网络舆论、第三关栽赃后让双方"狗咬狗",这套破局思路虽然质朴,但符合爽文的因果链条。相比之下,DeepSeek的"自掏腰包请客"、Claude的"凭空设定"、千问的"过度文青"都在这一环节掉了链子。
换句话说,剧情推演比拼的不是辞藻华丽,而是动机是否合理、破局手段是否符合角色处境。GLM之所以胜出,正是因为它的方案"质朴但站得住脚"。
让Gemini当裁判:AI互评结果
测试者还请Gemini(3.8 Flash)从多维度对各模型输出做了一次AI互评,结果与人工感知大致吻合:
- GLM(智谱5.3):89分,最符合爽文逻辑,得分最高;
- DeepSeek:87分,时高时低、发挥不稳定,且存在逻辑雷点;
- 千问:不适合,写崩;
- Gemini与Claude本次均未进入第一梯队。
测试者对DeepSeek的87分持保留意见,认为它主线设计的逻辑硬伤不该拿到这个分数,但认同GLM的89分"跟我的感知差不多"。
用AI模型评价其他AI模型的输出,是近年来提示词工程实践中一种常见的辅助手段,有时被称为"LLM-as-Judge"(大模型作为裁判)。这种方法的优点是可以快速生成结构化的多维度评分,且与人类评审的感知往往存在一定相关性;但其局限同样明显:模型倾向于给措辞流畅、格式规整的输出打高分,而对逻辑硬伤的识别能力参差不齐,有时还会因训练数据重叠而对同厂模型产生评分偏差。本次测试者对DeepSeek 87分持保留意见,恰好印证了这一局限——AI裁判未能充分惩罚逻辑雷点,而人工审阅对此更为敏感。
结论:写文首推谁?
综合人工评测与AI互评,这场测试的最终倾向是:
- 剧情推演(大纲、反转逻辑):GLM(智谱5.3)表现最稳,最符合爽文逻辑,是本场最大赢家;
- 实际成文(文字质感、严谨度、低AI味):测试者仍倾向Claude和Gemini,认为Claude的严谨度和细节把控本应最强,只是这次状态不佳,Gemini则需要更好的沟通引导来释放水平。
测试者的综合建议是:做剧情推演首推GLM,写成文首推Gemini/Claude。需要提醒的是,这只是单期实测的结论,模型版本、提示词写法、题材类型都会显著影响结果——尤其Claude用的并非最新版,Gemini也可能因引导不足而低估。想找到最适合自己的AI写作搭档,还是得结合自己的题材多做几轮对比。
相关推荐
Agent蔓延的隐患:一切看似正常才最危险
Agent蔓延(Agent Sprawl)是AI智能体时代的新隐患——AI Agent无序增长却表面正常,暗藏安全、成本与运维风险。本文解析为何"看似正常"最危险及应对之道。
当AI安全变成"性爱邪教":一场关于社群文化的争议
Hacker News上一个挑衅性标题"AI安全大多是性爱邪教"引发讨论。本文梳理AI安全社群、有效利他主义与理性主义圈子的文化争议,理性分析批评与反驳,探讨技术议题与社群文化该如何区分看待。
低价淘到二手硬件该留还是拆?一次采购决策的思考
一位 Reddit 用户花 500 美元买下 4 台满配二手设备后陷入纠结:该拆件转卖还是长期自用?本文从沉没成本、二手残值、太阳能供电等角度分析硬件采购决策。