AI修Bug的隐形代价:失控的代码变更
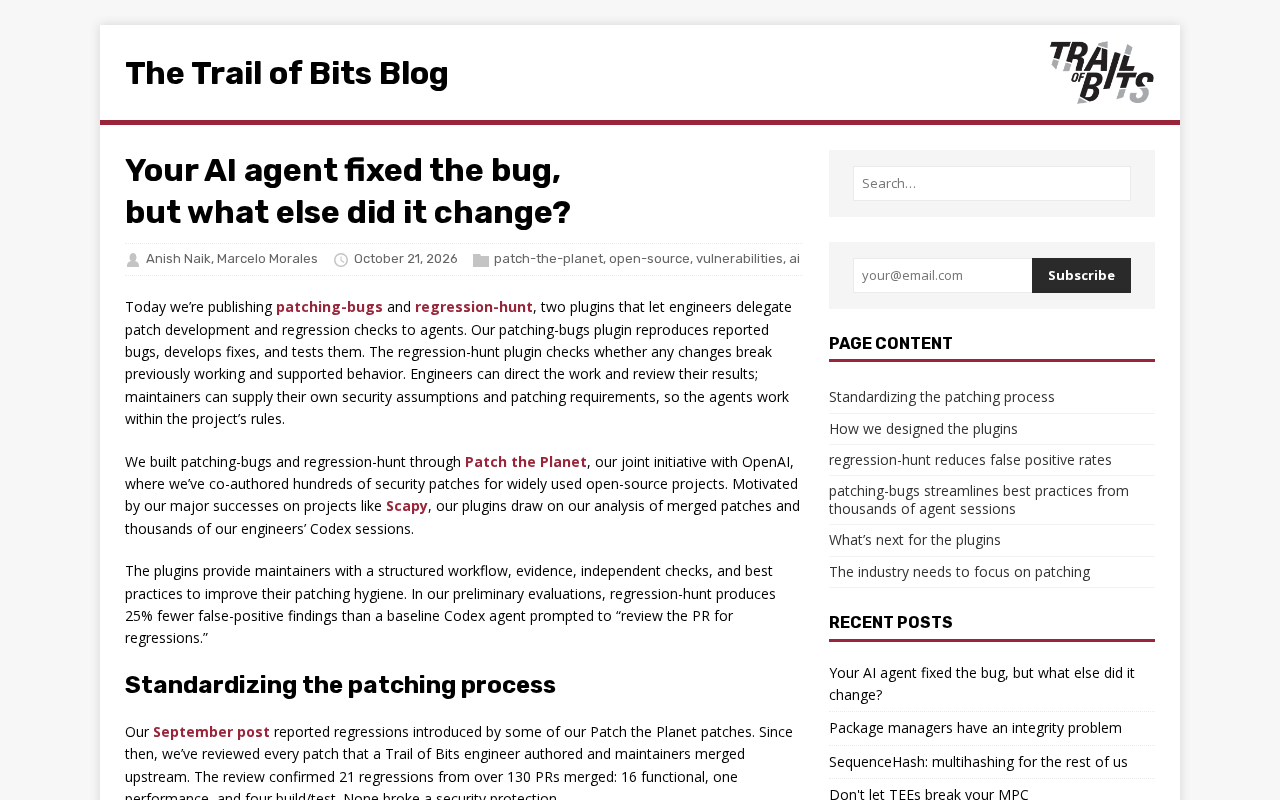
AI代理修复Bug时附带无关变更,透明度缺失成信任瓶颈。
文章由Hacker News上一个关于AI代理修复Bug的讨论帖切入,指出AI编程代理在自动修复缺陷时常常“顺手”进行重构、重命名、调整导入等非必要修改,形成开发者难以察觉的副作用。由于审查者容易只关注Bug相关行,代理的变更范围缺乏可见性,导致代码审查效率下降、信任成本上升。文章提出三条应对策略:强制最小变更原则、差异可视化与分类、自动化副作用检测。结合多社区讨论,文章总结出共识——变更透明度是当前最大短板,并建议工具设计应输出变更理由摘要,提升可解释性。最终强调:修复不是终点,变更是否必要与问题是否解决同等重要。
一个Bug修复引发的担忧
Hacker News上最近出现了一个引人深思的帖子:“AI agent fixed the bug, but what else did it change?”(AI代理修复了Bug,但它还改了什么?)。这个标题本身就像一记警钟——当AI代理自动修复代码缺陷时,开发者往往只关注问题是否被解决,却忽略了代理可能带来的副作用变更。尽管该帖子仅有14个积分和1条评论,但它戳中了AI编程工具落地的核心痛点。
自动修复背后的“黑箱”效应
AI编程代理(如基于大模型的代码修复工具)通常通过分析错误日志、定位问题代码、生成补丁来工作。问题在于,这个过程对开发者而言是一个黑箱。代理可能为了修复一个简单的空指针异常,顺手重构了函数结构、重命名了变量、甚至调整了无关模块的导入顺序。
据Hacker News上的讨论,这种“顺手修改”在复杂项目中尤为危险。开发者审查diff时,容易陷入“只看Bug相关行”的认知陷阱,而忽略了其他被改动的文件。一条评论尖锐地指出:代理的变更范围缺乏可见性,使得代码审查的效率不升反降。当AI的修改量超过人工修复的预期时,信任成本会急剧上升。
AI编程代理(AI Coding Agent)是指能够自主感知代码上下文、规划修改步骤并执行编辑的智能系统,典型代表包括基于大语言模型的代码修复工具(如GitHub Copilot的Agent模式、Devin、Aider等)。与传统的代码补全或静态分析工具不同,代理具备多步推理与工具调用能力:它可以读取错误日志、检索相关文件、生成补丁并运行测试。然而,这种自主性也带来了“行为空间”的扩大——代理在完成目标(修复Bug)的过程中,可能执行大量未被显式要求的中间操作,如重构、重命名、依赖调整等。这些操作在代理的决策链中可能被视为“合理步骤”,但对开发者而言却是不可见的副作用。因此,理解代理的“规划轨迹”与“实际变更”之间的差异,是评估其可控性的关键。
代码审查的盲区与应对策略
要应对这一问题,开发者需要建立针对AI生成代码的审查规范。以下是几个可操作的方向:
1. 强制最小变更原则
要求AI代理在修复时限定修改范围,比如仅允许改动与错误堆栈直接相关的文件。部分工具已支持通过提示词约束代理“不要重构”“不要格式化无关代码”。
2. 差异可视化与分类
将AI生成的diff按功能模块分组,标记出“直接修复”与“附带改动”两类。审查者优先确认附带改动是否必要,而非默认接受。
3. 自动化副作用检测
结合测试覆盖率工具和静态分析,检查代理修改是否引入了新的依赖或未覆盖的分支。如果变更涉及测试文件之外的核心逻辑,应触发人工复核。
多源视角下的共识与分歧
尽管该帖子讨论量有限,但结合其他开发者社区(如Reddit的r/programming和GitHub Discussions)的类似讨论,可以交叉验证几个共识:
- 共识一:AI代理的变更透明度是当前最大短板。多数开发者认同“修复本身不是问题,问题是修复了什么别的东西”。
- 共识二:现有的代码审查工具(如GitHub PR diff)并非为AI生成的大量微小变更设计,需要适配。
- 分歧点:部分开发者认为应完全禁止代理进行任何非必要修改,而另一派认为适当的代码清理是代理的优势,关键在于审查流程的完善。
对AI编程工具设计的启示
从产品角度看,AI编程工具需要在能力与可控性之间找到平衡。代理的“智能”不仅体现在修复成功率上,更体现在变更意图的可解释性上。未来的工具或许应该输出变更理由的摘要,例如:“修复了X处的空指针,同时移除了Y文件中的未使用导入”。
据Hacker News原帖的提问方式,这种对“还改了什么”的追问,本质上是开发者对AI信任度的试探。只有当代理能清晰回答这个问题时,自动修复才能真正被放心地集成到工作流中。
结语:修复不是终点,可控才是
AI代理修复Bug的能力已经得到验证,但“修复了什么”和“还改了什么”同等重要。开发者需要将审查焦点从“问题是否解决”扩展到“变更是否必要”,而工具设计者则需提升变更的可见性与可解释性。否则,每一次自动修复都可能埋下新的技术债。
背景补充
Diff(差异)是版本控制系统中用于表示两个版本之间变更的标准化格式,通常以行为单位标记新增(+)、删除(-)和上下文。在AI代理场景下,diff的粒度与规模直接影响审查效率:传统人工提交的diff通常聚焦于单一目的,而AI代理可能在同一提交中混合多种意图(修复、重构、格式化)。将diff按功能模块或变更意图分组,本质上是为审查者提供一种“认知分层”——先看直接修复部分,再评估附带改动。部分工具(如GitHub的Split Diff视图、Semantic Diff工具)已支持按语法结构或变更类型折叠无关行,但针对AI生成的多意图diff,仍需更细粒度的分类标签(如“必要修复”“潜在副作用”“风格调整”),以辅助审查者快速定位风险点。
测试覆盖率(Test Coverage)是衡量测试用例对代码执行路径覆盖程度的指标,常见类型包括行覆盖率、分支覆盖率和条件覆盖率。在AI代理修改代码后,覆盖率工具可以揭示代理是否引入了未被现有测试覆盖的新分支或依赖。静态分析(Static Analysis)则在不执行代码的情况下,通过解析源码检测潜在缺陷(如未使用变量、循环依赖、空指针风险)。将两者结合,可以构建一个“变更影响面”的检测流水线:静态分析识别代理修改是否触及核心逻辑或引入新依赖,覆盖率工具验证这些修改是否被测试覆盖。若变更涉及测试文件之外的核心逻辑且覆盖率下降,则应触发人工复核。这种自动化检测并非追求完全拦截,而是为审查者提供风险信号,降低遗漏副作用的概率。
相关推荐
WorkBuddy智能体实战:从AI问答到自动办公的跨越
WorkBuddy是腾讯推出的AI智能体桌面工作台,能读取本地文件、操作办公软件、执行多步骤任务并定时自动运行。本文详解其核心功能、与传统AI工具的本质区别及适用场景。
Anthropic研究:LLM让形式化软件验证规模化成为可能
Anthropic Frontier Red Team研究显示,LLM已能在上百个真实开源库的RISC-V汇编级别批量生成形式化证明,覆盖123个OSS-Fuzz库、239个入口点,合计约1.8亿行Rocq证明,并在过程中发现数百量级Bug。文章解析其规格生成、证明流水线、信任边界与成本下降路径。
提示词工程入门:从写提示词到构建AI协作能力
从提示词的四大作用到提示词工程的六步流程,系统梳理AI提示词工程的核心概念、商业价值与三层局限性,帮助初学者建立对提示词工程的完整认知框架。