AI训练数据从哪来?数据授权中介模式悄然兴起

AI训练数据需求催生企业数据授权中介,但合规、定价与规模化仍是瓶颈。
文章从Reddit一则帖子出发,揭示AI训练数据正从公开互联网转向企业自有应用数据,催生了数据授权中介这一新兴角色。发帖人扮演轻资产的数据经纪,对接数据持有方与AI训练需求方。企业数据变现面临隐私合规、定价困难和竞争顾虑三大障碍,其中合规是最大成本项,数据价值评估也缺乏行业标准。数据经纪模式要成立,需解决信任建立和规模化撮合两大问题。对AI开发者而言,除公开数据集外,授权渠道正成为获取特定领域数据的可行路径,但需在交易前做充分合规尽调。
在Reddit的AI相关板块,一则帖子引发了不少讨论:发帖人声称自己与多个国家的初创公司和各行业企业合作,帮助它们将自己应用产生的数据授权出去,供给需要AI训练、微调、研究或评估数据的公司、研究者和个人使用。
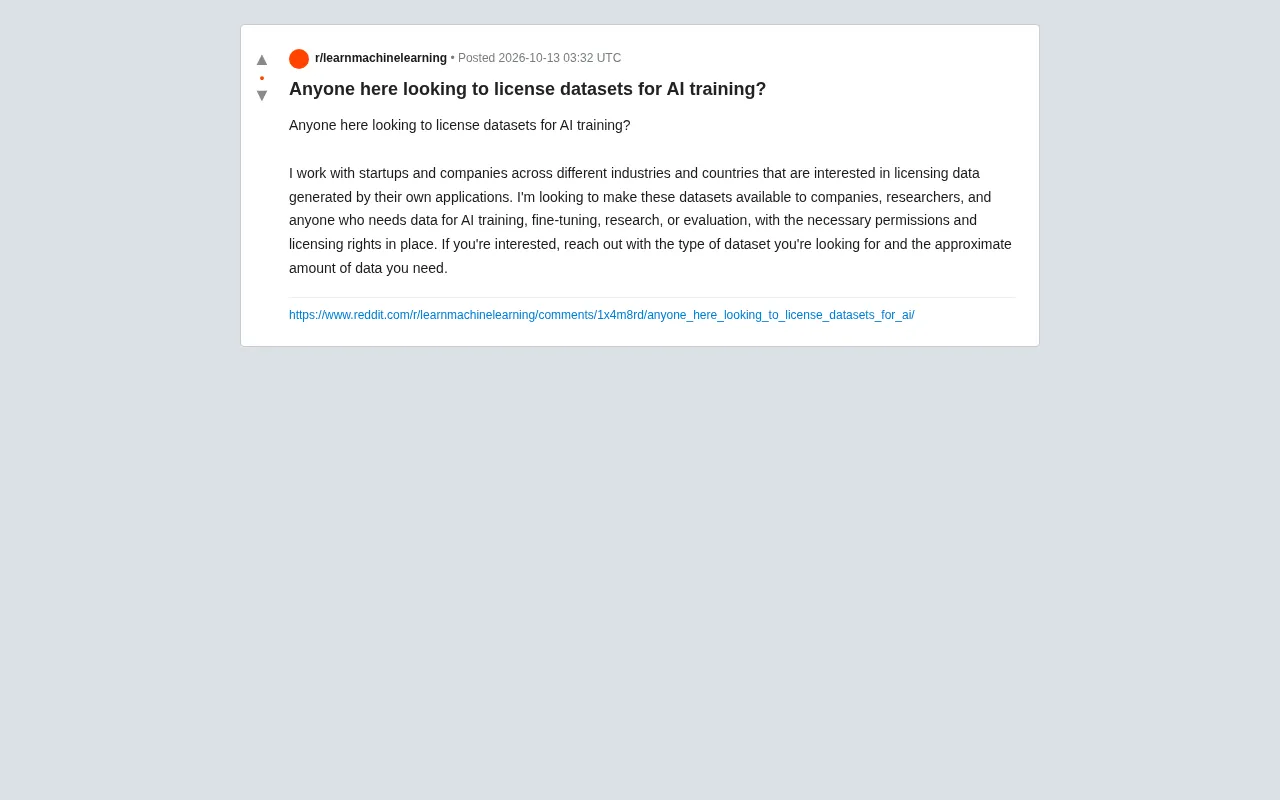
这条帖子本身信息量不大,但它指向了一个正在浮出水面的产业环节:AI训练数据的授权与流通。
数据荒之下,谁在卖数据?
大模型的能力高度依赖训练数据的规模和质量。公开互联网上高质量文本的存量正在被快速消耗,越来越多的团队开始转向非公开数据源——企业自有应用产生的用户行为数据、行业垂直数据、专有语料库等。
帖子中的发帖人扮演的正是中间人角色。他的商业模式是:对接拥有数据的企业和有数据需求的下游买家,在合规授权的前提下完成数据交易。覆盖范围包括"不同行业和国家"的初创公司与成熟企业,数据类型则根据买方需求匹配。
这类需求并非空穴来风。Reddit上经常出现寻找特定领域数据集的帖子,从医疗问答、法律文书到多语言对话记录,需求端相当分散。
数据荒(Data Famine) 是近年来AI行业频繁讨论的现象。根据Epoch AI等机构的研究,公开互联网上可用于训练的高质量文本(如书籍、学术论文、优质网页内容)总量约为数百亿词级别,而大模型的训练数据需求正以每年数倍的速度增长。部分研究预测,到2026-2032年间,高质量公开文本可能被消耗殆尽。这一趋势迫使AI团队转向三类替代数据源:一是企业内部的用户行为日志和交互记录,二是行业垂直领域的专有数据(如医疗影像、法律判例),三是由人工标注或合成生成的数据。这三类数据中,企业自有数据的规模最大、真实性最高,但获取门槛也最高,由此催生了数据授权交易的市场需求。
企业数据变现的诱惑与风险
对于拥有数据的企业来说,将自有数据授权出去是一条潜在的变现路径。尤其是那些积累了海量用户交互数据的应用开发者,这些数据在AI训练场景下可能具有超出自身业务的价值。
但实际操作中,企业数据授权面临几个核心障碍:
隐私与合规。用户数据往往涉及个人信息,GDPR、CCPA等法规对数据二次利用设置了严格限制。帖子中强调"necessary permissions and licensing rights in place",恰恰说明合规是这类交易的前提条件,也是最大的成本项。
数据定价困难。不同于标准化的商品,数据集的价值高度依赖具体用途。同一份数据用于预训练和用于评估,价值可能相差悬殊,目前行业缺乏成熟的定价基准。
竞争顾虑。企业可能不愿意将数据授权给潜在竞争对手,尤其是当数据本身构成业务壁垒时。
数据定价之所以困难,根源在于数据作为一种商品具有几个特殊属性:非竞争性(同一份数据可以卖给多个买家而不损耗)、场景依赖性(价值随用途剧烈变化)、边际成本趋零(复制成本极低)。传统经济学中缺乏对这类商品的成熟定价框架。目前业界探索的定价方式包括:按数据量(每token/每条记录)、按使用场景分级授权(预训练/微调/评估分别定价)、按下游模型收益分成、以及拍卖机制。此外,同一数据集对不同买家的价值差异可能达数十倍,信息不对称使得卖方难以确定合理报价。这些因素共同导致数据交易目前高度依赖一对一谈判,缺乏透明、流动的公开市场。
这个中间商角色能成立吗?
从帖子内容看,发帖人的定位是轻资产的数据经纪——不自己生产数据,只做供需匹配和授权协调。这种模式要跑通,至少需要解决两个问题。
一是信任。数据交易涉及卖方对买方使用方式的信任、买方对数据质量和来源合法性的信任。作为中间方,需要建立足够的信用背书。
二是规模化。一对一撮合效率低下,如果能形成标准化的数据目录和授权框架,价值会大得多。
目前已经有一些平台在做类似的事情,但行业整体仍处于早期阶段。数据授权会不会成为AI产业链中一个独立的、规模化的环节,还有待观察。
目前国际上已出现若干数据交易平台和经纪商,形态各异。数据市场平台(如Databricks Marketplace、Snowflake Data Cloud)提供数据上架、检索和交付的基础设施;数据经纪商(如Bright Data、Scale AI的部分业务)侧重于数据采集、清洗和按需供应;数据信托与合作社则在探索让数据主体集体议价和管理授权的模式。不过,与金融资产或大宗商品不同,数据交易的标的物高度异构,每笔交易的条款、合规要求和交付形式都可能不同,这使得标准化和规模化尤其困难。行业尚未形成统一的数据描述标准、授权协议模板或质量评级体系,这也是当前数据授权环节碎片化的核心原因。
对AI开发者的启示
如果你在做AI相关的产品研发,这条帖子传递的信号值得关注:除了公开数据集,越来越多的非公开数据正在通过授权渠道流通。对于需要特定领域数据的团队,除了自己爬取或标注,考虑数据授权也是一条可行路径。
同时也要注意,数据授权链条中的合规风险不可忽视。买到的数据是否来源合法、授权范围是否覆盖你的使用场景,都需要在交易前做充分尽调。
相关推荐

FastAPI从入门到精通:B站教程带你搞懂高性能Python框架
基于B站FastAPI教程深度梳理:FastAPI核心架构Starlette和Pydantic、异步IO与ASGI服务器性能优势、类型提示提升开发效率、自动API文档生成,以及官方文档与源码学习路径,帮助Python开发者快速掌握这一高性能Web框架。

测试与调试:区分业余爱好者与专业工程师的关键技能
测试与调试能力是区分业余爱好者与专业工程师的关键。本文解析为什么职业开发者大部分时间都在排查问题,以及AI时代为何让测试能力变得更加重要。

ChatGPT+Codex零基础教程:AI编程从入门到实战
基于B站教程内容,系统梳理OpenAI Codex的三种使用形态、七大核心能力及工程化设计思想,涵盖规范驱动开发、Agent循环机制、上下文工程优化等关键技术点,为开发者提供从入门到实战的完整认知框架。