AI一日狂潮:GPT-6家族神秘模型现身,Claude疑似做出科学新发现
OpenAI、Anthropic、MiniMax等实验室在同一天密集泄露新模型与科研突破,AI迭代节奏已精确到以天计。
过去24小时内,AI行业通过泄露与隐秘测试释放出密集信号:OpenAI帮助中心意外曝光GPT-6家族的第四个成员AstraMiner;Anthropic用约950个Claude智能体并行搜索逆转录酶数据库,疑似发现了此前未被描述的生物系统ART,展示了AI嵌入真实科研流程的早期样本;Claude Sonnet 5.5进入合作伙伴测试,取消强制工具调用并泄露定价;小米MiMo 3.0则通过KV缓存复用将长上下文推理成本大幅压缩。与此同时,MiniMax M3.1、Kimi K3.1、ChatGPT语音升级、Gemini 3.8 Flash及Meta VR眼镜等消息同步涌现。这些进展几乎全部来自非官方渠道,但汇聚在一起,清晰呈现出模型家族细分、架构针对长时智能体优化、工具调用范式重新设计三条并行演进的主线。
过去24小时的AI圈堪称信息密度爆表。各大实验室接连放料,从OpenAI隐藏的神秘模型,到Anthropic可能做出的真实科学发现,再到MiniMax、Kimi、小米MiMo等一连串新模型的泄露与预告。这些消息大多来自模型目录、帮助文档、隐身测试等非官方渠道,需要保持审慎,但拼在一起,确实勾勒出一幅密集迭代的行业图景。
OpenAI隐藏的AstraMiner:GPT-6家族的第三块拼图
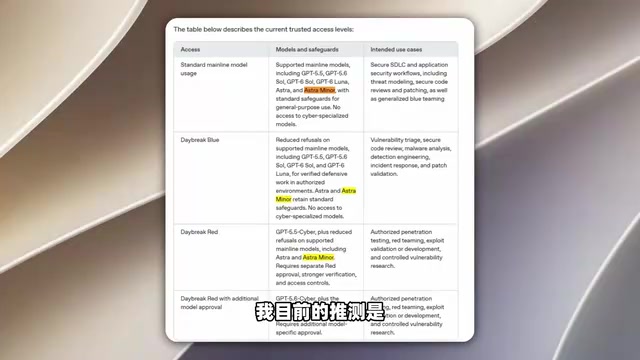
在GPT-6 Sol发布仅一天后,有人在OpenAI官方帮助中心里发现了一个从未公开过的模型名——AstraMiner。虽然OpenAI很快删除了所有相关引用,但泄露信息已经足够拼出一些线索。
文档显示,AstraMiner被明确列为一个受支持的主线模型,与Astra、Sol和Luna并列,同属Daybreak网络访问框架,保持标准的Daybreak Blue安全防护。这意味着它并非某次随机的配置泄露,而更像是一个真实存在的GPT-6家族成员。
目前它的基准成绩、定价、上下文窗口和发布时间都还是未知数,甚至连"Miner"这个名字代表什么都没有定论。一种合理推测是:它可能是Astra的一个更小、更便宜、更高效的衍生版本,用来填补GPT-6 Sol与完整版Astra之间的定位空白。不过这仍属猜测,最终会不会真正发布也还是问号。
Claude疑似做出真实科学发现:命名为ART的未知生物系统
这一天最让人瞩目的,是Anthropic这边传出的消息——Claude可能刚刚参与了一项真实的科学发现。
据描述,Anthropic在其人类化生物学实验室里,让大约950个Claude智能体并行运行了21小时,消耗约2.1亿token,搜索了超过20万种逆转录酶(一类把RNA复制成DNA的酶)。关键在于,Claude并没有被明确告知要找什么。其中一个智能体独立注意到了某种酶旁边一个奇怪的重复DNA模式,其结构与CRISPR有相似之处——而CRISPR正是彻底改变了生物模式研究的技术。
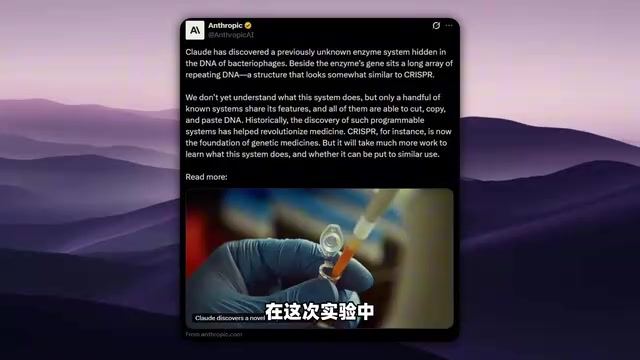
Claude随后将这个模式与已知生物系统比对、搜索现有研究,最终标记为"可能是新的东西"交给人类科学家。Anthropic研究人员接手后,在真实实验室中验证确认这是一个此前未被描述的生物系统,并将其命名为ART。
需要泼一盆冷水的是,目前完全不清楚ART到底能做什么,也没有任何证据表明它能像CRISPR那样用于基因编辑。但它的意义在于流程本身:AI搜索庞大数据集、注意到人类忽略的细节、形成假设、再交给科学家验证。Anthropic表示这类分析通常需要专家数周乃至数月。这也让Dario Amodei关于"AI有望在五到十年内帮助治愈大多数疾病"的预测多了一分现实注脚——尽管这仍是一个单一实验,谈治愈癌症还为时尚早。
逆转录酶是将RNA逆向转录为DNA的一类酶,自然界中最早在逆转录病毒(如HIV)中发现。CRISPR则是一种存在于细菌基因组中的重复DNA序列,细菌用它来"记忆"并抵御曾入侵过的病毒。2012年前后,科学家Jennifer Doudna等人将CRISPR-Cas9系统改造成精准基因编辑工具,因此获得诺贝尔化学奖。这一背景有助于理解Claude发现ART的意义:CRISPR的核心价值在于它的重复结构恰好可以被工程化改造,Claude此次注意到的"与CRISPR类似的重复DNA模式",暗示ART系统或许也具备被改造利用的潜在结构特征——尽管目前尚无实验证据证明这一点。
MiniMax M3.1与神秘的SpaceBunny
模型目录也在泄密。MiniMax M3.1已经出现在官方模型目录中,排位在M3和M2.7之前,但尚未加入白名单、也未出现在发布代码里,暗示它接近发布但还没揭晓,可能在两周内推出。
话说回来,一个叫SpaceBunny Alpha的隐身模型出现在OpenRouter、OpenCode等平台上,未来一周免费,拥有100万token上下文窗口和多模态支持。多条线索指向它可能就是M3.1:用中文提示时它会自称MiniMax模型,其文本分词器与MiniMax M3完全匹配(图像分词器不同,可能是多模态升级)。
不过实测表现平平。在与GLM 5.3的对比中,SpaceBunny在物理模拟和网页开发任务上明显落后——GLM 5.3在牛顿摆测试中碾压对手,SpaceBunny甚至没能完成Minecraft沙盒克隆的构建,输出了失败纹理。它的优势主要在速度快、文本润色不错,且目前免费(GLM 5.3跑完全套测试约花40美分)。
Sonnet 5.5隐秘测试:定价与设计思路泄露
Anthropic在Opus 5.5之后,已开始对Claude Sonnet 5.5进行隐秘测试,部分合作伙伴获得了仅24小时的访问权限。这兑现了此前博客中"Haiku 5.5和Sonnet 5.5将在数周内推出"的说法。
泄露规格显示,Sonnet 5.5拥有100万token上下文窗口,输出最高12.8万token,默认启用自适应思考。一个值得关注的变化是强制工具调用被取消——这表明Anthropic希望模型更智能地自行判断何时真正需要调用工具。
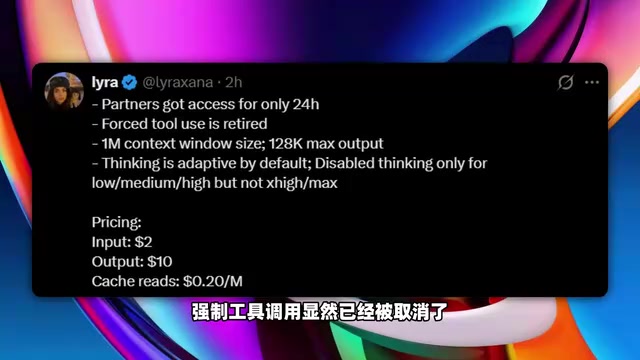
定价方面,泄露数据为每百万输入token 2美元、每百万输出token 10美元、缓存读取仅20美分。爆料来自Lea Lera,她此前对Opus 5.5的定价预测被证实准确,因此这组数字有一定可信度。相比之下,价格依然偏贵是唯一的遗憾。
此外,Claude Code的一位首席开发者透露正考虑彻底移除计划模式,改用Shift+Tab快捷键调整模型的"努力程度"等级,理由是新模型已强大到不需要专门规划模式。对此存在明显分歧——反对声音认为计划模式不只是给智能体用的,对人类用户同样有价值,可以先明确规划再动代码,更希望看到它进化而非消失。
自适应思考(Adaptive Thinking)是Anthropic在Claude 3系列之后引入的机制,指模型根据任务复杂度动态决定是否启用"扩展思考"(Extended Thinking)链式推理过程。简单任务直接给出答案,复杂任务则先进行内部推理再输出结论,从而在响应速度与推理深度之间自动平衡。强制工具调用(Forced Tool Use)则是此前API中的一项设置,允许开发者强制模型在每次响应时必须调用指定工具,不论模型自身是否认为有必要。Sonnet 5.5取消这一选项,反映出模型判断能力已强到Anthropic认为无需外部强制——但这也意味着开发者对工具触发时机的控制粒度有所下降,因此引发了社区的分歧讨论。
小米MiMo 3.0架构革新与其他新品
小米(Kimi)团队正在为MiMo 3.0系列重构底层架构,目标是让长时间运行的AI智能体更高效。核心痛点在于智能体运行时上下文不断膨胀,导致成本越来越高。新架构通过在层之间共享和复用KV缓存、智能处理注意力所需的历史token来解决这一问题。
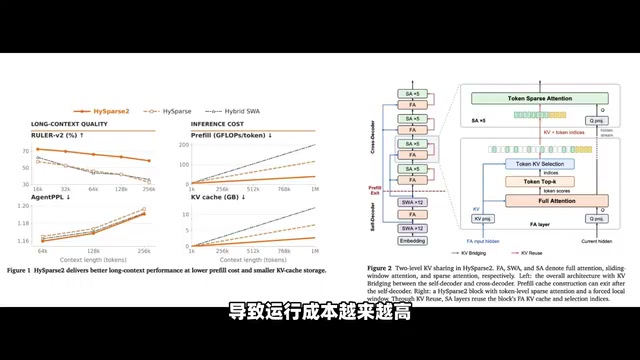
效果相当可观:在100万token上下文下,预填充计算量减少约5倍,KV缓存比MiMo 2.6缩小4.5倍,同时长上下文检索也有改善。此外Kimi K3.1也已确认接近发布,在线配置更新出现了低、高、最高模式,同样支持100万token上下文。
其他值得一提的动向包括:Muse Spark 1.4的贡献者版本(非旗舰版)在OpenCode被发现,采用与1.2、1.3相同的"廉价版先出、以数据训练权限换取"策略,官方最新仍是1.3;ChatGPT语音迎来大升级,可接入邮箱、日历、Slack,并配合ChatGPT工作版执行文档、演示、网页等实际任务;Google推出Gemini 3.8 Flash与Flashlight TTS,主打更自然的语音生成;Meta则发布了一款约100克重的VR眼镜,将影院、电脑与游戏机整合进镜片,并透露Muse每周免费发放约1亿token,试图通过交易费用而非纯订阅来变现。
KV缓存(Key-Value Cache)是大语言模型推理时的核心优化机制。模型在生成每个新token时,需要"回顾"此前所有token的注意力信息,这些信息以键值对的形式存储在显存中——这就是KV缓存。随着对话或任务上下文不断增长,KV缓存会线性膨胀,在百万token级别的长上下文场景下,显存占用和计算开销会变得极为昂贵。MiMo 3.0所说的"在层之间共享和复用KV缓存",本质上是让不同Transformer层共用部分历史信息,而非每层都单独存一份完整副本,从而在不显著损失性能的前提下大幅压缩缓存体积——这对需要持续运行数小时乃至数天的长上下文AI智能体而言是关键性能瓶颈的突破。
小结:迭代速度本身就是信号
这一天的信息几乎全部来自泄露、目录发现和隐秘测试,官方确认寥寥。但把它们放在一起看,趋势非常清晰:模型家族在细分(AstraMiner填空白)、架构在为长时智能体优化(MiMo 3.0的KV缓存复用)、工具调用与规划范式在重新设计(Sonnet 5.5取消强制工具调用)。而Claude参与发现ART,则提供了一个AI真正嵌入科研流程的早期样本。这些消息暂时都不宜过度炒作,但它们共同说明,AI的迭代节奏已经快到以天为单位。
相关推荐
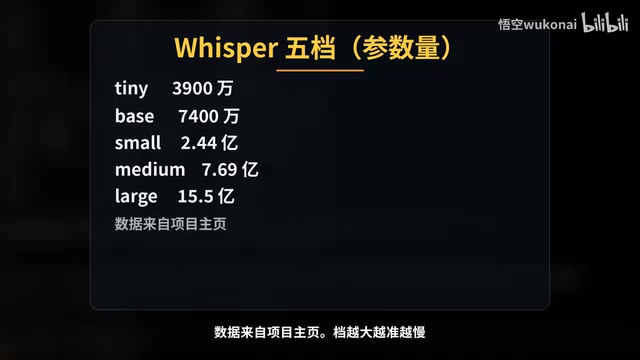
Claude Code实战:零代码搭建切片工厂,长视频自动变竖屏短视频
B站UP主悟空用Claude Code零代码搭建切片工厂,将35分钟长视频自动切成10条竖屏短视频。从Plan Mode、Whisper转写、claude.md规则、Hook质检到Subagent审核和Plugin分发,完整实战流程与实测数据。
WorkBuddy保姆级教程:AI Agent如何帮你自动转文件
WorkBuddy保姆级教程实战:从豆包只能给方案到AI Agent直接动手,三分钟批量转换PDF并归档。含安装、积分机制、与Codex对比及上手建议。
零基础入门Java+DeepSeek实战:程序员转型AI大模型开发指南
本文基于B站直播教学,详解Java程序员如何零基础转型AI大模型开发,涵盖技能路径、实战构建第一个Java AI应用、简历包装与求职策略,助你抓住大模型时代机遇。