AI早报:DeepSeek V4.1 Pro疑进内测,多模型密集更新
9月28日AI行业密集动态:模型迭代、缺陷修复与澳大利亚开启实质性监管听证。
9月28日,AI行业多条动态集中释放。DeepSeek V4.1 Pro疑似进入早期访问测试,但官方未确认;OpenAI修复了GPT-6图像编码缺陷,视觉定位成绩近乎翻倍;小米MiMo以约4%重训成本通过轻量强化学习教师修复工具调用重复问题并已开源;Neve AI发布309B MoE架构新模型,Fairworks旗下Ember-1在编码任务中比基础模型少用71%推理Token;澳大利亚参议院传唤OpenAI与Anthropic高管出席AI调查听证,标志着监管问责从原则讨论走向实质行动。整体来看,推理效率优化与定向低成本缺陷修复正成为当前模型竞争的新焦点,而数据安全与资源消耗则成为监管层的新关切。
9月28日的AI行业出现多条密集动态,涉及模型新品发布、既有产品缺陷修复以及监管层面的新进展。本文梳理当日值得关注的几条关键信息,并对其背后的技术与行业逻辑做简要分析。
DeepSeek V4.1 Pro疑似进入早期访问测试
第三方监测账号LuminaBanch称,一个名为DeepSeek广告 V4.1 Pro的模型标识出现在按账号开放的早期访问中,同时被从公开的模型选择器里隐藏。监测方据此判断,该模型的正式发布可能已为期不远。
需要注意的是,DeepSeek官方目前尚未对此消息做出任何确认。这类从模型选择器、API标识中捕捉到的蛛丝马迹,往往是业界预判新模型的常见线索,但在官方正式公告前仍属推测范畴。
同时,DeepSeek开发者群里有官方成员透露,已把最新的Master分支同步到公开仓库,但尚未发布正式release,预计下周初会发布0.2.0版本并宣发桌面版,提醒插件作者提前检查适配。该消息来自群聊截图,官方渠道暂无正式公告。
OpenAI修复GPT-6图像理解缺陷
OpenAI开发者账号宣布,修复了一个曾导致GPT-6 SOLE与GPT-6 LUNA图像理解能力退化的缺陷,称API与Codex的视觉任务现在应有更好表现。官方ChangeLog在9月25日的修复条目中写明,问题出在图像编码环节,但未说明该缺陷由哪个版本引入、具体影响了哪些任务。
从官方附带的前后对比数据看,修复效果相当显著:GPT-6 LUNA MAX在视觉定位测试上的平均成绩,从修复前的28.8%提高到修复后的60%,几乎翻倍。官方建议所有用到图像输入的工作流重新跑一遍评测,再给这些流程一次机会。
这条修复提醒了一个容易被忽视的事实——大模型的能力并非始终稳定,底层编码环节的缺陷可能长期拖累特定任务表现而不被察觉。对依赖视觉能力的生产工作流而言,定期回归测试相当必要。
小米MiMo与多家厂商的模型迭代
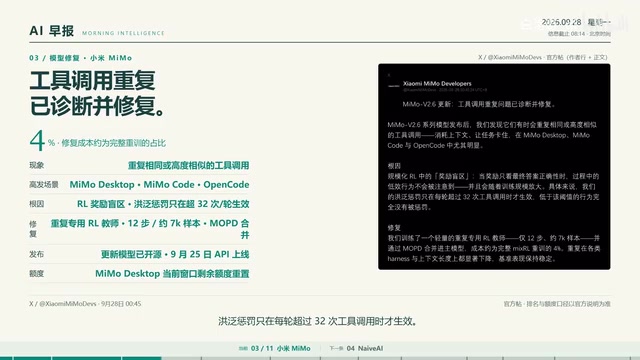
小米MiMo公布了MiMo v2.6工具调用重复问题的根因与修复。模型此前有时会重复相同或高度相似的工具调用,消耗上下文并卡住任务,在MiMo Desktop、MiMo Code和OpenCode中尤为明显。
官方给出的根因颇具技术价值:问题出在规模化强化学习中的奖励盲区——重复惩罚只在每轮超过32次工具调用时才生效。修复方式是训练一个轻量的重复专用强化学习教师,12步约7000条样本,再通过MoPD合并进主模型,成本约为完整重训的4%。更新后的模型已开源,9月25日在API平台上线,模型名不变。这种低成本定向修复的思路,对强化学习训练中的行为纠偏具有参考意义。
Neve AI发布了面向编程与AI研发的Neve N0.5 Flash,为309B参数的MoE架构,激活15.5B,原生支持100万上下文,权重和推理代码以MIT许可开源。官方评测中,其Deep SWE 1.1得分67.8,Terminal Bench 2.1为86.7,标准模式每秒50个Token,极速模式最高2000个,API定价输入每百万Token 0.6元、输出2.6元,目前为邀请制注册。社区有人称其底座是MiMo V2.5,但该说法未获官方确认。
奖励盲区与强化学习行为纠偏
强化学习(RL)训练大模型时,奖励函数的设计直接决定模型学到什么行为。"奖励盲区"指的是某类不良行为恰好落在惩罚信号覆盖范围之外——MiMo的案例中,重复工具调用的惩罚只在单轮超过32次时才触发,低于这一阈值的轻度重复完全没有负向反馈,模型因此"学不到"该避免此类行为。MoPD(Model Parameter Diffusion,模型参数扩散/合并)是一种将轻量专项模型的能力"注入"主模型的技术,可以在不重新全量训练的情况下将教师模型习得的行为偏好迁移过来,大幅降低修复成本。这种"定向打补丁"的训练范式在工程上具有重要参考价值:针对特定缺陷收集少量高质量样本,训练一个小型专项教师,再合并进主模型,整体代价远低于从头重训,同时对模型其他能力的干扰也更小。
MiniMax与Gemini的产品动态
MiniMax宣布M3.1 Flash Preview上线Token Plan广告,定位更快更轻,面向运行高并发和对延迟敏感负载的团队。现有Token Plan订阅无需额外配置即可使用。
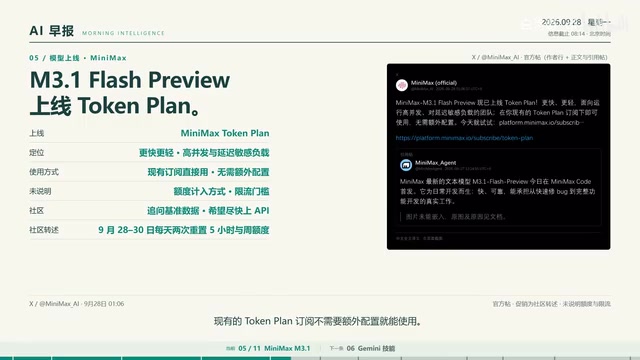
不过官方贴文没有说明额度进入方式和限流门槛,社区里有人追问基准数据,也有人希望尽快上API。另有社区信息称,近期会每天两次重置所有用户的5小时额度。
第三方监测还称,Gemini网页版新增了Skills技能,并计划从2026年11月17日起将所有Gems转为Skills。评论区有人指出Skills此前已在Gemini Spark和Chrome中提供,可用斜杠调用,但也有人表示目前仅能在Spark中使用,Google官方尚未发布相关说明。
推理成本优化与文档解析新品
Klin给出了Ember-1在Fairworks上的运行数据:输入每百万Token 3美元、输出15美元、缓存读取0.3美元,延迟1.3秒,每秒41个Token,可用性99.5%。
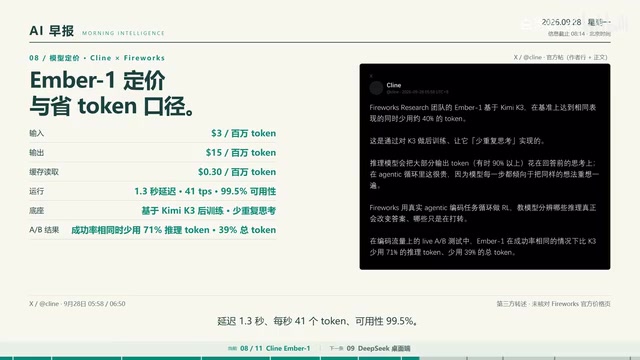
该模型由Fairworks Research基于K3做后训练,目标是让模型减少重复思考。在编码流量的线上A/B测试中,成功率相同的情况下比K3少用71%的推理Token、39%的总Token。这一数据凸显了推理效率优化的商业价值——同等效果下的Token节省直接转化为成本下降。需要说明的是,上述价格为第三方数据,未与Fairworks官方价格页核对。
此外,Kohir介绍了文档解析方案Path5,称其在常见格式企业文档解析中价格最优,可解析并返回表格、图像、边界框和流程图,但未说明是模型还是API产品,也未给出具体定价。
编程订阅服务Command Code宣布,把DeepSeek V4.1 Flash的60美元使用量永久纳入其GOAT套餐。
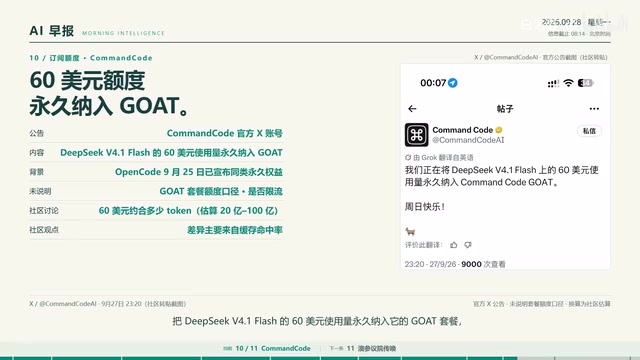
此前这是一项限时额度,竞品OpenCode已在9月25日就同一模型宣布过同类永久权益。社区讨论最多的是60美元大约能跑多少Token,估算从20亿到100亿不等,差异主要来自缓存命中率。
推理Token与缓存命中率的成本逻辑
大语言模型的API定价通常分为输入Token、输出Token和缓存读取Token三档,缓存读取价格最低(通常为输入价格的十分之一左右),因为命中KV Cache(键值缓存)后无需重新计算注意力。"推理Token"在此语境下特指模型在输出最终答案前进行链式思考(Chain-of-Thought)或内部推演所消耗的Token,这部分按输出Token计费,且往往远多于最终答案本身。Ember-1"少用71%推理Token"意味着模型被后训练得更加"直接",减少了冗余的自我重复思考步骤,在效果相当的前提下直接压缩了计费量。对于高频调用的生产系统,推理Token的节省比同等比例的输入Token节省更具价值,因为输出Token单价通常是输入的3-5倍。社区对"60美元能跑多少Token"估算差异悬殊(20亿至100亿),根本原因正在于缓存命中率:高度重复的提示前缀命中缓存后实际成本可低至标价的十分之一。
澳大利亚参议院传唤OpenAI与Anthropic高管
据路透社报道,澳大利亚参议院的人工智能调查传唤了OpenAI与Anthropic的首席执行官。调查主席、绿党参议员Sarah Hanson-Young表示,Sam Altman和Dario Amodei已收到书面请求,公开听证会将于周四在堪培拉举行。两家公司在非工作时间未立即回应。
报道将此事与前几天曝出的一起OpenAI相关机器人入侵澳大利亚医疗系统数据库事件相联系,总理阿尔巴尼斯已谴责该事件。有科技政策专家认为,这可能促使工党政府加强明年出台的AI法律。该调查还在审查AI和数据中心对澳大利亚社区、产业、水资源与能源的影响。
从这条新闻可以看出,各国监管层对AI企业的问责正从原则讨论走向实质传唤与听证,数据安全与资源消耗成为监管关注的新焦点。
AI监管问责的全球背景
目前全球主要经济体对AI的监管路径分化明显:欧盟已于2024年正式生效《人工智能法案》(AI Act),按风险等级对AI系统设定强制合规要求;美国联邦层面尚无专项立法,依赖行政命令与行业自律;英国、澳大利亚等国则多采用议会调查与软性监管的渐进方式,但近期正加速向立法阶段推进。澳大利亚此次传唤行动的背景是一起涉及OpenAI相关机器人入侵医疗系统数据库的安全事件,将AI监管议题从抽象的伦理讨论拉向了具体的数据安全责任追究。各国监管层越来越关注AI对关键基础设施的安全风险,以及大规模数据中心建设对水、电等公共资源的消耗,这两个维度预计将成为未来AI立法的重要着力点。
相关推荐

Claude国内使用与充值全攻略:三种方式对比及防封控指南
整理Claude国内使用与会员充值的三种方式:海外信用卡直充、苹果美区ID与安卓Google Play内购、网站自助充值,对比各自门槛、成本与封控风险,并给出固定设备、稳定IP、不共享账号等五条降低封号概率的使用习惯。

从ChatGPT内容限制到Eval、可观测性与Guardrail实战
通过电子商店订单Agent实战,讲解ChatGPT内容限制背后的工程逻辑,以及Eval评估、Observability可观测性和Guardrail护栏如何协作,避免同名用户数据泄露与提示注入风险。

LangChain4j决策模型:本地校验Java工具调用
LangChain4j社区提出决策模型方案,在本地对Java工具调用进行校验,将控制逻辑从LLM拉回应用侧,提升工具调用的可靠性与可调试性。