AI早报:Mistral Large 4 发布,多家巨头密集更新模型与工具

Mistral、Google、Anthropic、OpenAI密集更新,AI付费渗透率与安全风险同步浮现。
本文汇总了一周内AI领域的多条重磅动态。Mistral发布采用稀疏MoE架构的Large 4,1万亿总参数/490亿激活,智能指数达38,月底将开源权重。Google同步更新图像模型并发布轻量多模态嵌入模型EmbeddingGemma 2。Anthropic推出Claude for Google Workspace并将Claude Code的推理与虚拟机全面云端化。OpenAI简化API付费层级、开放Decisions API并上线会议笔记插件。行业数据方面,A16Z报告显示美国仅4.5%人口付费订阅AI,头部1%用户贡献近20%消费,GitHub的Git事件量一年翻倍印证了智能体编程带来的基础设施压力。安全层面,法院质疑AI庭审视频的情感影响,研究者演示智能体审查记录可被前端注入篡改。
Mistral Large 4:美中之外的最强模型
Mistral 发布了 Mistral Large 4 的研究公开预览版,在 Artificial Analysis 智能指数上得分 38,与 GPT-6 Luna 的最高档持平,成为美国和中国厂商之外得分最高的模型。这一成绩让 Mistral 在被头部大厂挤压的格局中重新站上了竞争前线。
从规格来看,Mistral Large 4 采用稀疏专家架构,总参数达到 1 万亿、激活参数 490 亿,支持 512K 上下文窗口。模型已在 OpenRouter 开放公测,上线头两周输入输出各打 5 折,分别为每百万 Token 0.68 美元和 2.09 美元,同时进入了 Arena 的智能体与代码榜单。更值得关注的是,Mistral 计划在本月底开源该模型的权重——这意味着一个接近顶级闭源模型水平的权重将向社区完全开放。
稀疏专家混合架构(Sparse Mixture of Experts,简称 Sparse MoE)是近年大模型扩容的主流路径。与传统的稠密 Transformer 不同,MoE 模型将前馈网络层拆分为多个并行的"专家"子网络,每次推理时只激活其中少数几个——通常由一个路由器(router)根据输入 Token 的特征动态选择。这样做的好处是:模型的总参数量可以做得很大(代表模型的"知识容量"),但每次前向传播实际参与计算的参数量(激活参数)远小于总量,从而在保持较低计算成本的同时扩大了模型容量。Mistral Large 4 的 1 万亿总参数与 490 亿激活参数之间约 20:1 的比例,正是这一设计的典型体现。与之对比,GPT-3 是 1750 亿全激活的稠密模型,而 Mixtral 8×7B 则是 Mistral 早期 MoE 产品,每次激活约 130 亿参数。MoE 架构的主要挑战在于专家负载均衡、通信开销(多卡训练时专家可能分布在不同设备)以及推理时的显存占用——尽管激活参数少,但所有专家权重仍需加载到显存。
Google 的图像与嵌入模型双更新
Google 正式发布图像模型 Gemini Nano Banana 2.1,在视觉质量、提示词遵循、多轮角色一致性和文本渲染等维度上均有提升,并新增了超宽与全景画幅,分辨率覆盖 1000 到 4000。被它取代的上一代图像模型已进入弃用流程,将在 10 月 29 日关停。
话说回来,Google DeepMind 开源了多模态嵌入模型 EmbeddingGemma 2,基于 Gemma 4 架构、7.4 亿参数,以 Apache 2.0 许可发布。它能把文本、代码、图像、视频和音频映射到同一个嵌入空间,方便在设备端做跨模态检索。官方称其在代码检索基准上比上一代提升近 10 分。小参数量加开放许可的组合,使这类模型非常适合在本地或边缘设备上部署跨模态搜索能力。
多模态嵌入(Multimodal Embedding)是指将不同模态的数据——文本、图像、音频、视频——投影到同一个高维向量空间中,使得语义相近的内容在空间中距离相近,无论它们原本是什么形式。其核心思路源自对比学习(Contrastive Learning),代表性工作如 OpenAI 的 CLIP 模型,通过大量图文对训练,使图像和文字描述的向量尽量靠近。在这一统一空间中,可以直接用文本查询检索图像(或反之),也可以做跨模态的相似度计算与聚类。EmbeddingGemma 2 将这一思路扩展到代码、视频和音频,适合构建统一的向量数据库,支持语义搜索、推荐系统和 RAG(检索增强生成)等下游应用。7.4 亿的参数量使其可以在边缘设备或消费级 GPU 上本地运行,Apache 2.0 许可则允许商业使用和二次分发,这两点结合使其在隐私敏感或离线场景下具有实际部署价值。
Anthropic:从 Workspace 集成到云端 Claude Code
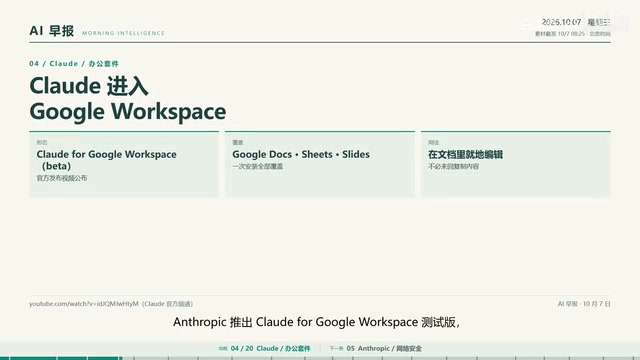
Anthropic 推出了 Claude for Google Workspace 测试版,一次安装就能覆盖 Google Docs、Sheets 和 Slides,用户可以直接在文档里让 Claude 就地编辑内容。
在安全方向,Anthropic 把 Project Glasswing 和原有的网络安全验证计划合并成一个扩展版,按防御、红队和专用三档发放网络安全能力。合格的安全团队可申请更高档位和更少的拦截,三档都覆盖 Claude Opus 5.0、Sonnet 5.5 和 Haiku 5.1,其中专用档会与美国政府共同逐案审查。
架构层面也有大动作。Anthropic 工程师 Felix Riesberg 说明了 Claude Code 的变化:旧版在用户电脑上运行本地虚拟机,磁盘、电池和性能开销都很大,合上笔记本工作就会停。新版把模型推理和虚拟机都放到云端,每个任务有独立沙箱,桌面应用只负责文件访问这类需要本机的工具调用。每个任务在自己的虚拟机上运行,仓库克隆到新分支后可以从网页、手机、桌面端、终端启动和跟进,完成后留下一个可转成 PR 的分支,且云端机器不单独收费,Pro、Max、Team 和 Enterprise 计划都包含。
OpenAI:简化付费层级与多项新能力
OpenAI 把 API 的付费使用层级从 5 个简化为 3 个——Build、Launch 和 Grow,累计充值 5 美元、100 美元和 500 美元就能分别进入对应档位,每月用量上限分别为 500、5000 和 20 万美元。Codex 负责人 Tibo 表示,这次改动是为了减少在 API 上构建时的摩擦。
功能侧,OpenAI 的 Decisions API 向所有开发者开放公测,它用 GPT-6 Luna 针对预设问题直接给出判断概率、固定选项或评分,官方称比通过 Responses API 调用 Luna 快约 10 倍,且只按输入 Token 计费,每百万 Token 0.1 美元。ChatGPT 则上线了 Meetings 插件,可替用户记录会议笔记,并结合 ChatGPT 对用户和其工作的了解,在 ChatGPT Space 里保存个性化摘要和后续步骤。笔记能私密保存也能共享给团队,目前在 macOS 桌面应用里以 Beta 向 Pro 和 Business 用户开放。
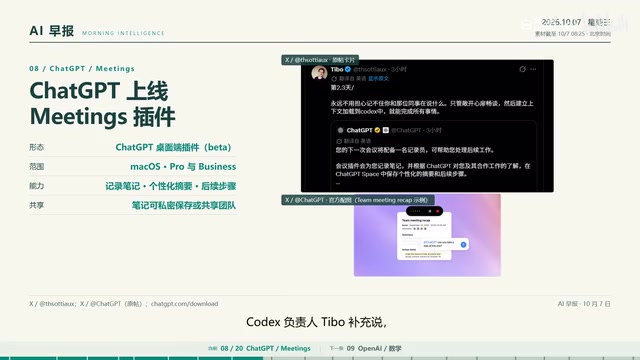
Tibo 补充说,把会议里积累的上下文载入 Codex,就能接着把事情做完。此外,OpenAI 还发布了一批由内部前沿模型产出的数学新成果,放在 GitHub 仓库并附上论文修订和引用规范,其中很多证明用 Lean 做了形式化以方便计算机验证,官方称平均每项成果的算力大约相当于 ChatGPT Pro 思考三个小时。
Tibo 的投票与「重置」风波
一个颇具话题性的插曲是,Tibo 在 X 上发了一条只有两个选项的投票,标题是「坦诚地说」,问这次发布算好评还是需要一次重置。截图时约 1.6 万人参与,78.4% 选了需要一次重置。他同一天还发帖称第二天会有四个更新或一次重置,或者两者兼有。这种直接面向社区投票决定产品走向的做法,也反映出用户对高频发布节奏的复杂态度。
行业数据与基础设施:AI 的真实渗透率
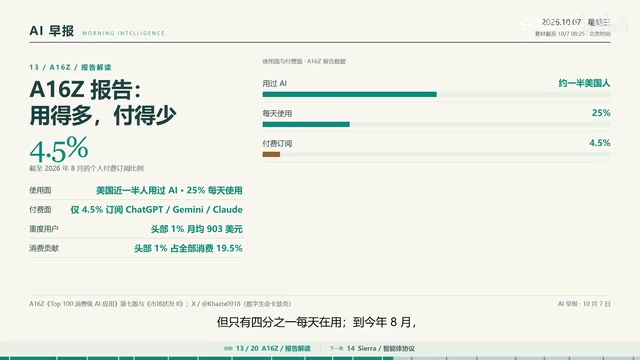
博主卡茨克解读了 A16Z 的两份报告,描绘出 AI 普及的真实画像:美国近一半人用过 AI,但只有四分之一每天在用;到今年 8 月,只有 4.5% 的人付费订阅了 ChatGPT、Gemini 或 Claude。更有意思的是付费结构——头部 1% 的用户月均花费 903 美元,贡献了全部消费的 19.5%。这说明 AI 消费呈现极度头部集中的特征,大众付费转化仍有很长的路要走。
基础设施层面,GitHub 宣布重建 Git 基础设施以应对智能体规模的开发负载。今年 8 月每月 Git 事件量达到 4733 亿次,一年翻了一倍多;9 月开发者和智能体产生了 73.8 亿次提交,是一年前的 5 倍多。新架构把存储和计算解耦,内部基准里写入吞吐最高提升 35 倍。这组数字直观说明了「智能体编程」对底层设施带来的真实压力。
协议方面,Sierra 和 Meta 联合 Genesis、Shopify、Stripe、沃尔玛等公司发布了 Personal Agent Protocol 开放协议,定义个人智能体如何与企业交互。协议基于 OAuth,消费者决定给智能体只读还是写入权限,企业决定智能体通过网站、API 还是自家智能体完成任务,V0.1 规范计划本月晚些时候发布。
Personal Agent Protocol 所基于的 OAuth(Open Authorization)是一套广泛部署的开放授权标准,目前主流版本为 OAuth 2.0。其核心机制是:资源所有者(用户)向授权服务器申请一个有限权限的访问令牌(Access Token),再由第三方应用(智能体)持令牌访问资源服务器,全程无需暴露用户的原始账号密码。令牌可携带细粒度的权限范围(scope),例如"只读联系人"或"写入日历",到期后自动失效。将 OAuth 引入智能体协议的意义在于:它提供了一套成熟的、可审计的权限委托机制,让用户可以明确授予或撤销智能体对某项企业服务的访问权,企业侧也能用现有的身份基础设施接入,而不需要从头设计信任模型。这与传统 API Key 的粗粒度授权相比,在多智能体、多平台场景下安全性和可控性都更高。
开源模型与安全警示
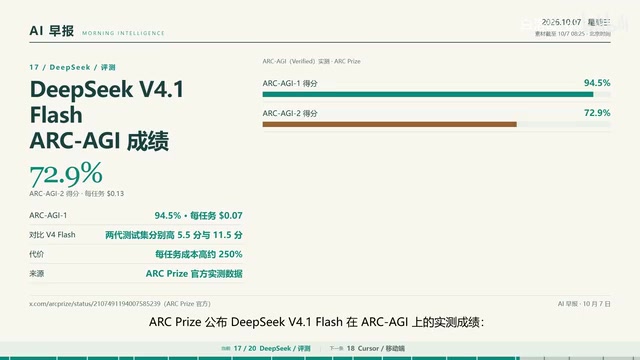
ARC Prize 公布了 DeepSeek广告 V4.1 Flash 在 ARC-AGI 上的实测成绩:第一代得分 94.5%,第二代 72.9%,比上一代 V4 Flash 的最好成绩分别高 5.5 分和 11.5 分,但每任务成本高出约 250%。
Reflection 发布了开源编码模型 Beam,总参数 5010 亿、激活 230 亿,面向编码、智能体和科学任务,从零训练,完整权重本月以 Apache 2.0 发布。官方称其在 SWE-Bench Verified 上得分 80.9,第三方评价认为它大致在 GLM 5.2 的水平,仍落后于最新的国产开源模型。
安全层面有两条值得警惕的消息。亚利桑那州上诉法院裁定,一起过失杀人案量刑时使用的 AI 生成受害者视频带有过度的情感分量,案件维持过失杀人罪定罪,但刑期必须重新考虑。另一方面,有研究者用 Inspect 评估框架的记录查看器做了概念验证:借助一个 AI 智能体,研究人员约 10 分钟就找到一个前端注入漏洞,可以让智能体改写审查者看到的记录内容,而真实轨迹仍保留在数据库里。Inspect 背后团队在收到报告后一天内完成修复,并建议把 AI 系统的输出当作不可信输入,把可观测性当成安全关键基础设施来对待。
SWE-Bench Verified 是一个专门用于评估代码智能体解决真实软件工程任务能力的基准,由普林斯顿大学发布。其核心设计是从 GitHub 上真实的 Issue 和对应的 Pull Request 中采样,要求模型在给定代码库上下文和问题描述的情况下,自动生成能通过全部单元测试的补丁。"Verified"子集是由人工标注者筛选出问题描述清晰、测试充分的样本,以减少噪声。由于任务直接来自生产级开源仓库,涉及定位 Bug、理解调用链、修改多文件等复杂操作,它被认为是衡量代码智能体实用能力的较高标准之一。80.9 的得分意味着模型能独立解决约 81% 的此类真实软件缺陷,当前顶级闭源模型的最高成绩约在 85% 上下,国产开源前沿模型也已接近或超过这一水平,因此报告中"仍落后于最新的国产开源模型"的评价有其具体的量化背景。
相关推荐

Harness 才是 Agent 的核心:工业级多 Agent 落地的三个关键
从 B 站实战演示出发,剖析 Harness 为何是 Agent 的核心:Master 与 Worker 双 Agent 架构、心智一致性约束、三遍自主迭代开发,以及工业级多 Agent 落地的可复用框架要点。

零成本用Claude Code:ModelScope免费API配置指南
B站UP主分享如何通过ModelScope魔搭社区免费API额度,配合VS Code和SystemService协议转换工具,零成本在Claude Code中调用DeepSeek等国产大模型写代码。含五步配置流程、模型选择技巧及三个常见坑点规避方法。

Pi Agent:极简开源编码智能体实战指南
Pi Agent 是对标 Codex、Claude Code 的极简开源编码智能体,GitHub Star 持续增长。本文梳理其崛起轨迹、极简设计思路与从原理配置到扩展开发的实战学习路径,帮助开发者快速上手。