AI智能体一句话跑通GEO数据库挖掘全流程

WorkBuddy智能体一句话跑通GEO数据挖掘全流程,但依赖预置Skill。
文章基于B站UP主“深信自学网”的实操演示,对比了普通AI对话工具与智能体在生信分析中的差异:前者仅生成脚本、需用户手动运行和反复报错,后者可自动生成并执行脚本、安装依赖、调试报错直至交付图表报告。以阿尔茨海默病为例,WorkBuddy通过提示词自动搜索并筛选出16个GEO数据集,下载后整理为表达矩阵和分组文件并完成ID转换,随后一行提示词触发批次校正、差异分析、WGCNA、四种机器学习方法筛选特征基因、免疫浸润分析及ceRNA/转录因子/药物敏感性网络构建等完整流程。文章同时指出,其灵活性受限于预置Skill的覆盖范围,复杂报错处理能力仍需验证。
在生物信息学分析中,GEO数据库挖掘是常见但繁琐的任务。传统AI对话工具需要用户反复复制报错信息、手动安装软件依赖,而AI智能体(Agent)的出现让“一句话跑通全流程”成为可能。本文基于B站UP主“深信自学网”的实操演示,拆解WorkBuddy智能体如何自动化完成从数据搜索到分析报告的全过程,并探讨其能力边界。
从对话工具到智能体:工作流的本质差异
普通AI对话工具在生信分析中的角色是“脚本生成器”。用户输入需求,AI返回代码,用户自行运行;一旦报错,需将错误信息贴回对话,循环往复。据UP主演示,这种模式在安装软件、处理依赖包时尤其低效。
智能体则扮演“执行助手”。用户只需写好提示词,智能体便会生成脚本、控制脚本运行,并在检测到缺失软件时自动安装软件及依赖包。脚本报错后,智能体会直接修改并反复测试,直到运行成功,最终输出图形、表格和分析报告。这种“生成-执行-调试-交付”的闭环,将用户从重复劳动中解放出来。
UP主推荐了三款常用智能体,并以WorkBuddy广告为例演示安装:下载软件后双击即可完成,上手门槛极低。对于已安装其他智能体的用户,流程同样适用。
GEO数据挖掘的自动化实操:以阿尔茨海默病为例
数据搜索与筛选
传统方式需手动打开GEO数据库页面,逐条筛选数据集。智能体方案中,用户只需在提示词中写明疾病名称(如阿尔茨海默病)、对照组与疾病组样本数要求(如各大于5个)、数据过滤条件等,智能体便会自动搜索并过滤,保留满足条件的数据集,去除无表达矩阵的记录。
演示中,智能体为阿尔茨海默病找到了16个相关数据集,并以表格形式呈现,包含数据集ID、数据类型、平台文件信息、对照组与疾病组样本数目、组织信息等。用户可据此选择3-5个数据集进行多芯片联合分析。
GEO(Gene Expression Omnibus)是美国NCBI维护的公共基因表达数据库,收录了全球研究者提交的芯片、高通量测序等表达数据。每个数据集以GSExxxxx编号标识,并关联平台文件(GPL,描述探针与基因的对应关系)和样本元数据。数据过滤时常用的“表达矩阵”指行是基因/探针、列是样本的数值矩阵,是后续差异分析的基础。GEO中并非所有数据集都提供可直接下载的表达矩阵,部分仅存原始数据(如CEL文件),需要额外预处理,因此智能体在筛选时会优先保留含表达矩阵的记录。
数据下载与整理
选定数据集后,将ID和期望的数据格式写入提示词,智能体自动完成下载。据UP主展示,智能体会对每个数据集生成三个文件:表达矩阵文件、对照组样本信息文件、疾病组样本信息文件。同时,智能体自动完成ID转换(探针名称转基因名称)和数据过滤。
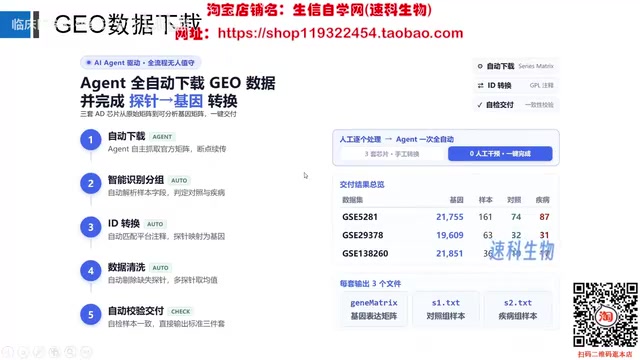
这一环节传统上需要手动编写R脚本处理,智能体将多步操作封装为一次提示词交互,显著降低了操作负担。
ID转换是芯片分析中不可跳过的一步:芯片探针本身是序列片段,需借助平台注释文件将探针ID映射为基因Symbol或Entrez ID,才能与生物学知识对接。同一基因可能对应多个探针,常见处理是取表达值最大的探针或取均值。数据过滤通常指剔除表达量过低、在多数样本中无信号的基因,以降低多重检验负担和噪声。批次效应则源于不同数据集在实验时间、平台、操作者上的差异,直接合并会导致样本按数据集而非生物学分组聚集,因此需要ComBat、removeBatchEffect等算法校正。
分析流程全自动:从批次校正到调控网络
数据准备完毕后,输入一行提示词即可触发完整的生信分析流程。UP主使用了“深信自学网”编写的Skill(技能包),智能体按预设流程依次执行以下分析模块,并生成结构化报告:
- 数据合并与批次校正:对多个数据集合并后进行批次校正,输出校正前后的箱线图和PCA图。演示中提到,校正后样品随机打乱,说明批次效应已被消除。
- 差异分析与可视化:得到差异分析统计表格,并绘制火山图和热图。
- 共表达分析(WGCNA):通过图形选择最佳软阈值,构建无尺度网络,划分基因模块,并基于模块与性状的相关性(以p值最小为准则)筛选疾病相关基因。
- 交集基因获取:将差异基因与疾病相关基因取交集,绘制交集基因的曼哈顿图展示染色体分布。
- 功能富集:对交集基因进行GO和KEGG富集分析。
- 蛋白互作网络:构建PPI网络,按连接节点数目选取前20个核心基因。
- 特征基因筛选:通过LASSO回归、SVM机器学习、随机森林和布鲁塔算法四种方法筛选特征基因,取交集得到5个交集特征基因。
- 特征基因验证与可视化:绘制特征基因圈图、ROC曲线(演示中AUC均大于0.7)、差异箱线图、相关性图、列线图、校准曲线等。
- 通路与免疫分析:进行GSEA、GSVA分析,以及免疫细胞浸润分析(柱状图、箱线图、相关性气泡图)。
- 调控网络构建:构建ceRNA调控网络(预测miRNA和lncRNA)、转录因子调控网络,以及药物敏感性分析网络。
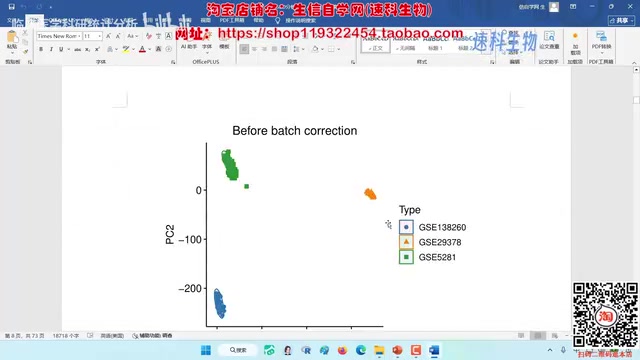
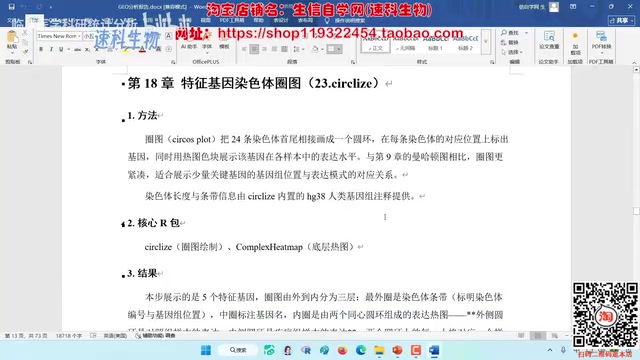
整个流程覆盖了从数据预处理到高级可视化的完整链条,用户无需打开目录或手动运行脚本,所有操作通过自然语言提示词驱动。
WGCNA(加权基因共表达网络分析)通过构建基因间的加权相关网络,将表达模式相似的基因划分为模块,再计算模块特征基因(module eigengene)与疾病性状的相关性,从而筛选与疾病高度相关的模块及基因。LASSO回归、SVM-RFE、随机森林和Boruta是四种常用的特征基因筛选方法,各自基于不同的统计或机器学习原理,取交集可提高结果的稳健性。GSEA与GSVA均属通路水平分析:前者评估预设基因集在排序基因列表中的富集程度,后者计算每个样本的通路活性评分。ceRNA假说认为mRNA可通过竞争性结合miRNA来调控其他转录本,因此ceRNA网络通常包含mRNA、miRNA和lncRNA三类节点。
能力与限制:智能体在生信分析中的适用边界
从演示来看,智能体在标准化流程上表现出色:安装环境、下载数据、执行固定分析模块、生成报告,这些环节的自动化程度远超对话工具。但需注意,演示依赖了预先编写好的Skill(技能包),这意味着分析流程的灵活性和可定制性取决于Skill的覆盖范围。对于非标准分析需求,用户仍需自行设计提示词或调整Skill。
另外,智能体对报错的自动修复能力基于测试循环,在复杂依赖冲突或数据异常场景下,其可靠性仍需实际验证。UP主在视频中未展示极端报错的处理过程,这部分能力有待更多案例检验。
总体而言,WorkBuddy这类智能体将生信分析的门槛进一步拉低,让研究者能将精力聚焦于科学问题而非流程实现。对于需要批量处理GEO数据或多芯片联合分析的研究者,这种“一句话跑通”的模式值得尝试。
本文基于B站UP主“深信自学网”的公开视频内容整理,仅作技术流程解读,不构成任何软件推荐。实际分析结果需结合生物学背景进行验证。
相关推荐

腾讯WorkBuddy实测:AI Agent如何碾压传统聊天助手
腾讯WorkBuddy实测对比豆包:AI Agent如何直接操作电脑完成PPT转PDF、文件归档等任务。从安装门槛、国内生态、价格、插件市场四方面分析WorkBuddy优势,并给出AI Agent选择建议。

奥特曼称个人PC囤RAM“相当糟糕”,数据中心利用率更高
OpenAI CEO萨姆·奥特曼在Reddit引发热议的表态中称,个人PC配备大量RAM是“相当糟糕”的资源利用方式,数据中心凭借集中调度能实现更高内存利用率。本文解析这一观点背后的技术逻辑与行业信号。

付费5美元教AI说话:一场关于AI训练本质的社会实验
一位开发者搭建了运行真实语言模型的「假AI实验室」,用户支付5美元即可教模型一句话。这个社会实验揭示了AI训练中数据成本、用户参与和话语权的深层关系。