AI周报:GPT-5.6三档发布、开源推理框架与机器人安全全线突破

本周核心:OpenAI GPT-5.6分档发布,白宫成幕后变量
2026年6月末,AI行业延续了高速迭代的节奏。本周最受关注的事件,当属OpenAI发布GPT-5.6系列——采用Sol、Terra、Luna三档分层策略,编程能力在关键基准上达到91.9%,安全评测CyberGym得分85.6%,均超越竞品Nexus 5。
OpenAI的Sol、Terra、Luna三档架构延续了其近年来「能力梯队化」的产品逻辑:低档模型以低延迟、低成本服务高频轻量场景,中档模型平衡能力与成本,旗舰模型主攻复杂推理与专业任务。这一架构与Google的Gemini Ultra/Pro/Nano、Anthropic的Claude Opus/Sonnet/Haiku呈现高度相似的竞争逻辑,反映出头部AI实验室在商业化路径上的收敛趋势。CyberGym作为独立安全评测基准的引入,标志着AI安全评估正从内部红队测试演进为可跨公司横向比较的标准化体系。
值得关注的是,这次发布被地缘政治因素深度介入。白宫要求先进模型面向海外用户时必须逐客户审批,OpenAI表示将配合政府,导致GPT-5.6在部分市场延迟发布。特朗普签署的行政令进一步规定,模型发布前必须通过AI安全测试——AI安全正从技术议题演变为国家博弈的筹码。
这一政策框架有其历史脉络:2022年10月拜登政府对先进半导体(尤其是A100/H100等GPU)的出口限制,随后逐步扩展至AI模型权重与推理API。2025年初推出的「AI扩散规则」将全球国家划分为不同合规等级,要求美国AI公司在向特定市场提供服务前完成政府报备。这一机制的核心逻辑是:超过特定能力阈值的先进AI被视为具有双重用途的战略资产,与核技术、密码学工具的管控逻辑趋同。
这种「出口管制」的蝴蝶效应已在亚洲显现:日本出现复购潮,中国市场则加速推进AI自主化,安全成为新的关键词。
开源阵营三大突破:推理、训练与记忆
本周开源社区异常活跃,三项进展尤其值得关注。
DeepSeek联合北大开源DSpark推测解码框架
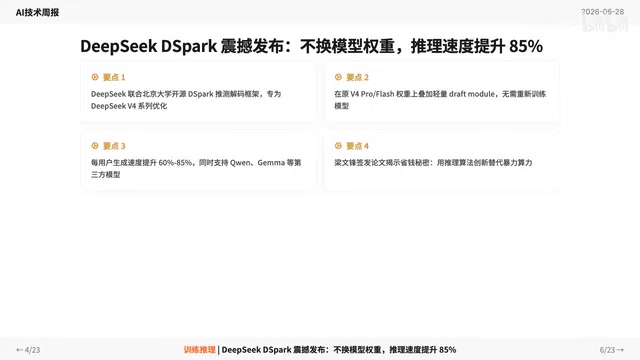
DeepSeek广告与北京大学联合开源了DSpark推理框架,主打推测解码(Speculative Decoding)技术。推测解码是一种通过引入小型「草稿模型」来加速大型语言模型推理的技术:用计算代价极低的小模型快速生成候选token序列,再由大模型并行验证并择优采纳,从而在不改变输出质量的前提下大幅提升吞吐量。这一技术由Google、DeepMind等机构在2022-2023年间系统化提出,核心优势在于绕开了大模型自回归生成的串行瓶颈。 DSpark据称推理速度提升85%,生成速度提高6–8%,且无需更换模型权重,直接降低推理成本。对于追求高吞吐、低延迟的场景,这类「不动权重就提速」的方案极具实用价值。
Prime Intellect刷新分布式训练门槛
Prime Intellect开源的PrimeRL 0.6.0框架实现了重要突破:仅用28台H200即可训练万亿参数级模型,大幅拉低了大模型训练的硬件门槛与成本。NVIDIA H200是基于Hopper架构的顶级AI训练GPU,单卡显存达141GB HBM3e,峰值算力约4.9 PFLOPS(FP8精度)。训练万亿参数模型通常需要数千张A100/H100卡,PrimeRL 0.6.0将门槛压缩至28张H200,依托异步流水线并行、梯度压缩与跨节点显存共享等技术,本质上是对分布式训练通信墙(communication wall)问题的系统性突破。
「通信墙」是分布式训练领域的核心挑战之一,指随着GPU节点数量增加,节点间梯度同步与参数传递的通信开销呈超线性增长,最终成为整体训练效率的决定性瓶颈。传统的AllReduce梯度同步协议在万亿参数规模下,需要在数千张卡间同步数TB量级的梯度数据,网络带宽成为比计算本身更稀缺的资源。PrimeRL 0.6.0通过将计算与通信重叠执行、压缩传输量、降低单卡显存压力三者协同,使28张H200的有效训练效率逼近传统架构数百张卡的水平——实质性地将大模型训练的「资本门槛」从亿级美元的超算集群下拉至千万级的中等算力集群。对算力受限的团队而言,这意味着参与前沿模型研发的可能性大大增加。
让AI告别「金鱼脑」:Agent记忆框架新突破
Nous团队发布的Agent记忆框架针对长期困扰智能体的「短期记忆」问题,Token成本下降96%、性能提升23%。现有Transformer架构的上下文窗口本质上是无状态的,每次对话独立,无法积累长期知识。Nous框架的突破在于引入分层记忆压缩与选择性召回机制,将需要全量载入上下文的记忆转化为按需检索的外部存储,从而将Token成本从O(n)压缩至接近O(log n)量级。 记忆管理是当前Agent走向实用的核心瓶颈,成本与性能的双重优化释放出积极信号。
硬件与算力:新型计算机与巨头加码并行
算力层面出现了两条截然不同的路径。
一方面,一款基于「耦合振荡器」的新型计算机试图替代GPU。耦合振荡器网络(Coupled Oscillator Networks)是一种模拟计算范式,利用物理振荡器的相位同步现象来求解优化问题,尤其擅长Ising模型等组合优化场景。与GPU的数字逻辑不同,它直接用物理动力学完成计算,理论上能耗可降低数个数量级。 该方案功耗仅为传统GPU的千分之一,性能损失约6.7%,完全开源,被称为新型计算范式的「Hello World」。目前该路线仍处于早期验证阶段,有限的编程模型是走向通用AI推理的主要挑战,但若技术路线成立,将对能耗敏感的AI推理场景产生深远影响。
另一方面,传统巨头继续加码:高通豪掷40亿美元收购AI软件公司Modular,其Mojo编程语言直指英伟达CUDA的生态霸主地位。CUDA(Compute Unified Device Architecture)是NVIDIA于2006年推出的并行计算平台,经过近20年的生态积累,已形成从框架(PyTorch/TensorFlow)到库(cuDNN/cuBLAS)的完整护城河,全球数百万AI开发者深度依赖。Modular的Mojo语言由Swift之父Chris Lattner主导,语法兼容Python但性能逼近C,核心目标是构建与CUDA解耦的AI编程生态。
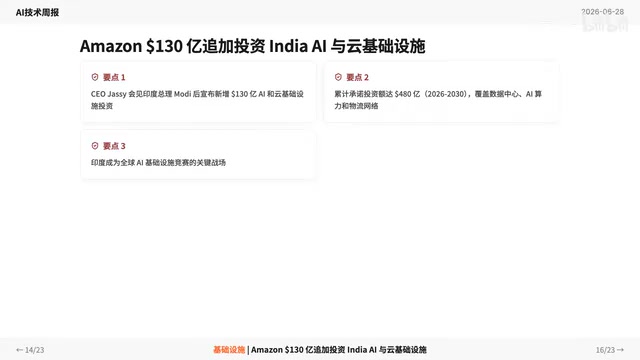
Mojo的技术策略是「渐进式替代」:语法完全兼容Python以降低迁移成本,底层编译至MLIR中间表示实现跨硬件抽象,性能通过SIMD向量化与零成本抽象逼近C。CUDA的护城河并不仅仅来自技术性能,更来自近20年积累的路径依赖——全球高校AI课程以CUDA为默认编程模型,PyTorch/TensorFlow的算子库深度耦合cuDNN,历史上撼动CUDA的尝试(OpenCL、ROCm等)均因生态不完整而折戟。高通此次收购被业界解读为在芯片生态战中绕开NVIDIA的战略布局,胜算取决于能否提供足够有吸引力的硬件性价比作为开发者迁移的动机。亚马逊则再投130亿美元押注印度AI与云基建,累计承诺已达480亿美元,涵盖数据中心与算力建设。
Agent与「AI同事」:LLM的第三范式
Anthropic推出的Claude Slack集成颇具标志性意义。用户可在Slack中通过@直接激活,且自带持久记忆。Karpathy将这种常驻协作工具定义为「LLM的第三范式」——相对于「API调用」(第一范式)和「RAG增强检索」(第二范式)而言,LLM作为常驻协作者深度嵌入工作流,持续感知上下文、积累任务记忆,而不再是一次性的问答工具。
更引人注目的是Anthropic的内部数据:超过80%的代码由AI编写,人均产出是去年的8倍,工程瓶颈已从「编码」转移至「产品决策」。这印证了一个趋势——当AI承担绝大部分实现工作后,人的价值正在向决策与判断迁移。
此外,上海AI Lab推出Self-Harness框架,让AI能够自主改进规则,性能最高提升60%,推动Agent从「被调用」进化到「自调用」。CoreTech也上线了常驻Slack的AI同事,已参与编写65%的产品团队代码。
具身智能与机器人:安全成核心议题
机器人领域本周同样热闹。NVIDIA推出HALOS,号称首个物理AI全栈安全方案,将自动驾驶积累的1.86万工程年经验移植至机器人。HALOS的三层架构借鉴了自动驾驶领域的功能安全标准ISO 26262与SOTIF,分别对应感知层、规划层与执行层的独立安全监控。 ISO 26262专注于系统性硬件与软件故障导致的危险,按汽车安全完整性等级(ASIL A至D)分级要求冗余设计;SOTIF(ISO 21448)则处理「系统按设计运行但仍导致危险」的场景,即感知算法在罕见边缘情况下的能力局限。将这套框架移植至具身智能面临额外挑战:机器人的运动自由度与交互场景远比车辆复杂,传统的穷举式场景验证难以奏效。具身智能的安全问题比纯软件AI更为复杂——一旦机器人在物理世界发生失控,损害不可撤销,这正是安全栈从「加分项」变为「准入门槛」的根本原因。 NVIDIA选择完全开源HALOS并吸引40余家公司参与,本质上是在推动行业安全标准的早期锚定。Agility Robotics的Digit成为首个集成NVIDIA HALOS的机器人,安全正成为具身智能落地的核心门槛。
在MWC上海现场,8支中国团队展开人形机器人点球大战,全程自主对决、禁止遥控与预编程,核心考验机器人的自主决策能力,吸引超万人观战。这类竞技场景正成为检验具身智能真实水平的试金石。
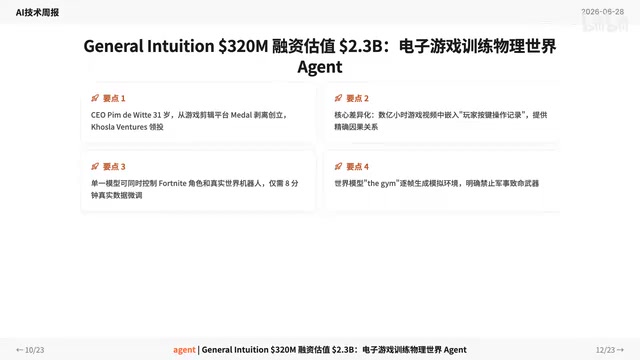
General Intuition完成3.2亿美元融资,估值23亿美元。其思路独特:用数亿小时游戏视频训练单一模型,同时控制游戏角色与真实机器人,仅需8分钟微调即可完成迁移,并明确禁止军事用途。这一路线可追溯至DeepMind DQN等早期工作,核心依据是游戏视频包含海量具身决策序列——角色如何感知环境、权衡选项、执行动作——与机器人所需的感知-规划-执行循环在结构上高度同构。通过统一的多模态模型同时处理游戏帧与机器人传感器输入,仅需少量真实机器人数据即可完成域适应,大幅降低昂贵的物理世界数据采集成本。这一范式被研究者称为「游戏作为物理世界的低成本模拟器」,与Tesla用驾驶视频训练自动驾驶的Dojo路线在哲学上一脉相承。
资本动向:图像生成与模型部署赛道升温
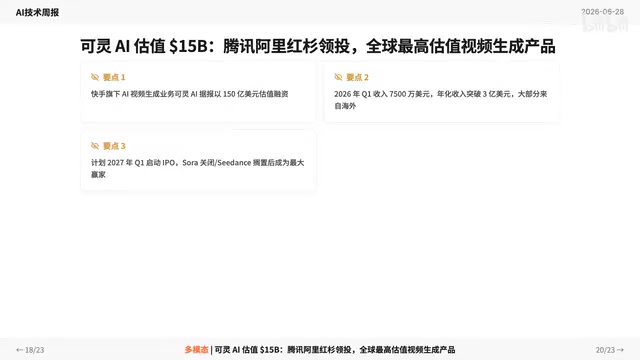
融资端呈现明显的应用化倾向。国产视频生成产品可灵AI估值达150亿美元,由腾讯、阿里、红杉领投,年化收入3亿美元且大部分来自海外,计划2027年一季度上市。
专注帮助企业低成本部署AI模型的Baseten完成15亿美元融资,Andreessen Horowitz与英伟达参投,估值130亿美元,年收入6亿美元、暴增2000%。AI安全公司Patronus AI完成5000万美元B轮,累计融资7000万美元,收入年增15倍,几乎覆盖所有主流前沿实验室。
图像生成领域,Chroma开源了Turbo版本,2秒出图并开放原始权重,社区已涌现50多个LoRA。LoRA(Low-Rank Adaptation)是一种参数高效微调技术,通过在原始权重矩阵旁注入低秩分解的增量矩阵,仅需训练极少量参数(通常不足总参数量的1%)即可让基础模型适应特定风格或任务,无需复制完整模型。开放原始权重后,社区LoRA的快速涌现正得益于此。 然而,开放权重的双刃剑效应也随之显现:内容安全护栏可被针对性的LoRA绕过,这一风险正是AI安全公司(如Patronus AI)市场需求快速增长的深层驱动力——开源能力的下放与安全管控的失效之间的张力,将是未来相当长时期内行业必须持续面对的结构性矛盾。
结语
本周的行业主线清晰可见:技术加速开源、算力路径多元、Agent走向常驻协作、机器人聚焦安全、地缘政治深度嵌入。从DSpark的推理提速到Prime Intellect的低成本训练,开源力量持续压低参与门槛;而白宫的出口管制则提醒我们,AI竞争早已超越纯技术范畴,上升为国家战略层面的博弈。对从业者而言,如何在开放创新与合规约束之间找到平衡,将是接下来的长期命题。
核心要点
核心要点
相关推荐

Claude Sonnet 6疑泄露,Anthropic内部模型加速惊人
Anthropic疑似泄露Sonnet 6,Meter报告称其AI研发加速1.9倍;OpenAI发布GPT-6 Cyber,GPT-6.2 Astra或将至;Google Gemini Omni 1.2 Flash登顶视频生成榜;Meta stealth模型与实时头像亮相;市场波动下Google仍投170亿美元建数据中心。

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。