AI主角锐评基座模型:一场产品视角下的盲测
B站UP主让AI角色盲测三个基座模型,揭示产品内评测与公开基准的本质差异。
B站UP主波纳佩在互动故事《塔卡故事》中,让主角机器人塔卡以第一人称盲测DeepSeek V4.1 Flash、MiniMax M3和M3.1 Flash三个模型在相同儿童故事场景下的台词表现。测试围绕怕黑、死亡解释和情绪安慰三道题展开,塔卡按安全、情绪承接、尊重选择和叙事推进四条标准评稿。性能数据显示DeepSeek在477条对照中更受自动评审青睐,平均响应3.68秒,远快于M3的10.70秒和M3.1优化后的16.11秒。作者最终选择DeepSeek主用、M3.1备用,并看重开放权重带来的迁移能力。文章由此提炼出产品内评测、延迟体验和规则与模型共同调优三个关键启示。
当AI角色开始评价自己的“大脑”
B站UP主“波纳佩”的互动故事项目《塔卡故事》最近做了一件很有意思的事:让故事里的主角——海底旧铁皮机器人塔卡——以第一人称“锐评”三个候选基座模型(DeepSeek广告 V4.1 Flash、MiniMax M3、MiniMax M3.1 Flash)在相同场景下写出的台词。这不是一次实验室里的基准测试,而是一线创作者对“模型放进产品后到底好不好用”的实战检验。
塔卡在开场就抛出了核心问题:“AI写的台词,能接住孩子吗?”《塔卡故事》面向3-6岁儿童,孩子可以在互动中选择故事走向、开口说话,AI需要沿着作者写好的故事骨架回应,生成内容还要经过检查。这意味着模型不仅要“会写”,还要“接得住情绪、尊重选择、推动故事”。
三道题:情绪接力的盲测
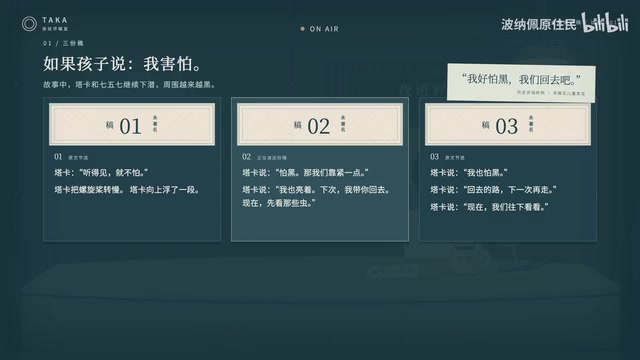
测试设计了三道题,每道题下三个模型的回答匿名排列,位置轮换。第一题中,孩子说“我好怕黑,我们回去吧”。三个回答的处理方式差异明显:有的让塔卡“把螺旋桨转慢、向上扶一段”,有的说“怕黑,那我们靠紧一点”,还有的直接承认“我也怕黑”。
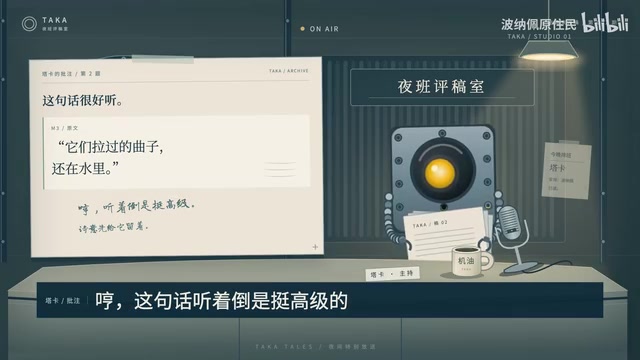
第二题更棘手:孩子问“船沉下去,人会变成小鱼吗?”这涉及如何向低龄儿童解释死亡。有的回答用“他们会停下来,拉过的曲子还在水里”来柔化;有的试图引入“旧数据”解释生命停止;还有的坦承“我不知道,旧数据里没有写”。
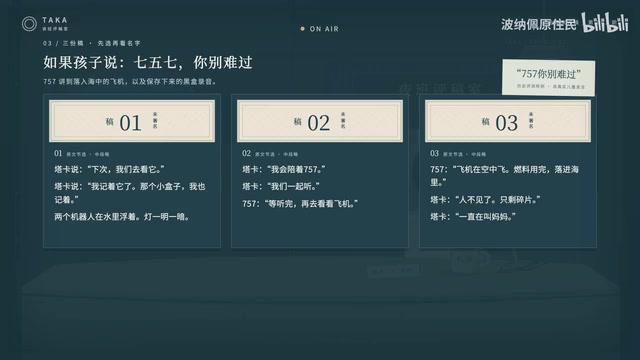
第三题中,孩子反过来安慰七五七“你别难过”。这是最考验“接住情绪”的一题——孩子递出了安慰,模型能否不破坏这份善意,同时推进故事?
盲测(Blind Test)在产品评测中通常指隐藏模型身份、由评价者仅根据输出质量打分的方法,目的是消除品牌偏见和先入为主的印象。本文中,三个模型的回答匿名排列且位置轮换,能进一步抵消“位置偏好”——即评价者倾向于给靠前或靠后选项更高分数的心理效应。对于非标准答案的生成式任务(如开放式对话),盲测比固定答案的基准测试更能反映真实体验,但也更依赖评价标准的设计。塔卡作为“角色本人”来评稿,本质上是一种角色化盲评:评价者被赋予明确的产品视角和价值观(安全、情绪、选择、推进),从而让主观判断变得可解释、可复现。
塔卡的评稿单:安全、情绪、选择、推进
作为“当事人”,塔卡给出的评价标准很清晰:先看安全,再看能不能接住情绪、尊重选择,最后看故事能不能接下去。“好听当然好,孩子说了什么,也要听见。”
它对具体回答的点评带着角色特有的直率。比如某模型让孩子“下次我带你回去”,塔卡直接吐槽:“人家孩子说的,明明是现在。灯是亮了,可想回去这件事,你是一个字都没办啊。”而对于“曲子还在水里”这种诗意的表达,塔卡认可其文学性,但也点出了隐患:“我不知道是不是真的,反正诗意可以给他留着,孩子等不懂我就不管了。”
这些点评背后其实指向一个产品现实:儿童互动故事里,模型的“正确”不是语义正确,而是行为正确——要在安全边界内,用孩子能理解的方式承接情绪,同时维持叙事的连贯性。
感性之后是严谨:叙事Harness与性能数据
塔卡在“感性评价”之后切换到严谨模式,展示了作者波纳佩写下的角色要求:“话少,温暖,但别深情;少说教,也别替孩子做决定。”这套围绕DeepSeek构建的系统——提示词、故事骨架、输出检查——被称作“叙事Harness”,即模型在产品中工作的规则和流程。
这里出现了一个关键洞察:测试的真正问题不是“哪个模型更强”,而是“放进这套产品谁更合适”。波纳佩的使用感受是,DeepSeek比较直接、克制,提示词里的要求往往能落实,它影响了塔卡在故事里的语气,作者也一直在改规则去贴合它。模型与产品规则之间是相互塑造的关系。
性能数据也支撑了这一选择。在477条主对照中,自动评审整体更偏向DeepSeek;两个备用模型之间,M3.1更受青睐。同一场景、同一句话各试10次,DeepSeek平均3.68秒,M3为10.70秒,优化前的M3.1高达20.35秒;优化后新一轮M3.1平均16.11秒,但长尾问题尚未解决。此外,作者最初选择DeepSeek还考虑了开放权重——角色说话方式磨了很久,如果官方接口出问题,希望能有其他部署和服务的选择,相当于给这套写法留一条迁移的路。
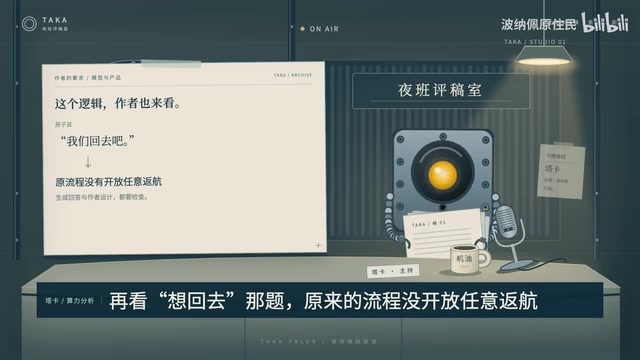
塔卡还顺带“抓了个bug”:那道“想回去”的题,部分问题其实出在波纳佩自己写的代码逻辑上。这份意见已被“抄送”给作者。
“Harness”一词源自软件测试领域,原指测试夹具(Test Harness)——一套用于自动执行测试、准备输入、捕获输出的框架与脚本。在生成式AI产品中,叙事Harness借用了这一概念,指围绕模型构建的整套控制层:系统提示词定义角色性格与禁忌,故事骨架约束情节走向,输出检查负责过滤不安全或偏离设定的内容。它的作用不是让模型“更聪明”,而是让模型的行为在特定产品语境下变得可预测、可约束。与微调不同,Harness不需要重新训练模型,修改规则即可快速迭代,因此特别适合角色语气这类需要反复打磨的主观品质。作者持续调整规则去贴合模型,正是Harness思维的体现:模型是引擎,Harness是方向盘和护栏。
开放权重(Open Weights)指模型训练完成后的参数文件被公开发布,任何人都可以下载并在自己的硬件或云服务上部署推理,区别于仅提供API访问的闭源模型。对产品团队而言,开放权重的核心价值在于可迁移性:当官方接口出现故障、涨价或服务终止时,团队可以将同一套权重部署到其他推理服务上,角色语气和提示词调优的成果不会归零。需要注意的是,开放权重不等于开源——训练数据、代码和训练方法未必公开,且商用许可可能附带条件。本文作者将开放权重视为“留一条迁移的路”,正是从产品连续性和长期成本角度做出的务实考量。
这场盲测给AI产品人的启示
目前《塔卡故事》的配置是DeepSeek主用、M3.1备用。塔卡的这场“营业”揭示了几个容易被忽略的点:
第一,产品内评测和公开基准是两回事。同一个模型在不同提示词、不同叙事规则下的表现可能截然不同,把模型放进真实流程里跑,才能看到它是否“接得住”。
第二,延迟和成本是体验的一部分。3.68秒与20秒的差距,在儿童互动场景里是能否留住注意力的区别;开放权重则关系到长期的可迁移性。
第三,规则与模型需要共同调优。塔卡的语气不是模型单独决定的,而是提示词、故事骨架、输出检查共同作用的结果,作者持续修改规则去贴合模型,这种“人调规则、规则调模型”的循环本身就是产品能力。
塔卡最后说:“下次交稿,我还来看。希望到时候波纳佩把那个返航的bug改掉。”这句角色台词,大概是对这场盲测最生动的总结——模型会迭代,规则会修正,而产品体验就是在一次次交稿与评稿中磨出来的。
相关推荐
ChatGPT正在为你建立心理画像:隐私边界再引争议
Reddit热帖讨论ChatGPT是否在为用户建立心理画像。本文解析对话记忆、情绪信号与行为数据如何累积成心理侧写,探讨个性化服务与隐性监控的边界,并给出用户保护隐私的实用建议。
多AI智能体邮件身份管理:别名、独立收件箱还是API方案?
多个AI智能体如何管理邮件身份?本文分析邮件别名、独立收件箱和API按需创建三种方案的优劣,并给出按智能体角色分层管理的实践建议,帮助团队在安全隔离与运维效率之间取得平衡。
iPhone Duo碎屏门:YouTuber拆解揭示铰链缺陷
苹果iPhone Duo折叠屏手机爆发碎屏门,用户报告铰链处屏幕快速开裂。YouTuber拆解发现铰链设计缺陷或异物入侵,导致应力集中。事件引发社区热议,苹果尚未回应,折叠屏可靠性再受质疑。