AI自动化研发或引发失控的“智能爆炸”风险

AI研发自动化可能触发失控的"智能爆炸",学界正从风险描述转向政策应对。
一条推特声明及其背后的多人合作论文指出:随着AI系统越来越多地参与自身研发,技术进步可能形成正反馈循环,演变为速度超越人类监管能力的"智能爆炸"。文章解释了"智能爆炸"的概念源流——其核心逻辑是递归自我改进带来的指数级加速——并强调真正的风险不在于AI变强本身,而在于加速速度超过人类评估、验证与干预的能力窗口,导致决策权实质性地从人类转移至系统。论文不止于技术推演,还提出了政策建议,体现了AI安全研究向治理实践延伸的趋势。文章同时提示读者保持审慎:从"加速"到"极端失控"之间仍存在算力瓶颈等现实约束,但提前构建治理框架已是不可回避的现实课题。
一条推文背后的核心警告
一条在推特上引发关注的声明指出:随着AI研发(R&D)流程被越来越多地自动化,AI进步可能会急剧加速,演变为一场风险极高、难以控制的“智能爆炸”(intelligence explosion)。发布者表示,自己与多位合作者在一篇论文中评估了相关证据,并给出了政策建议。
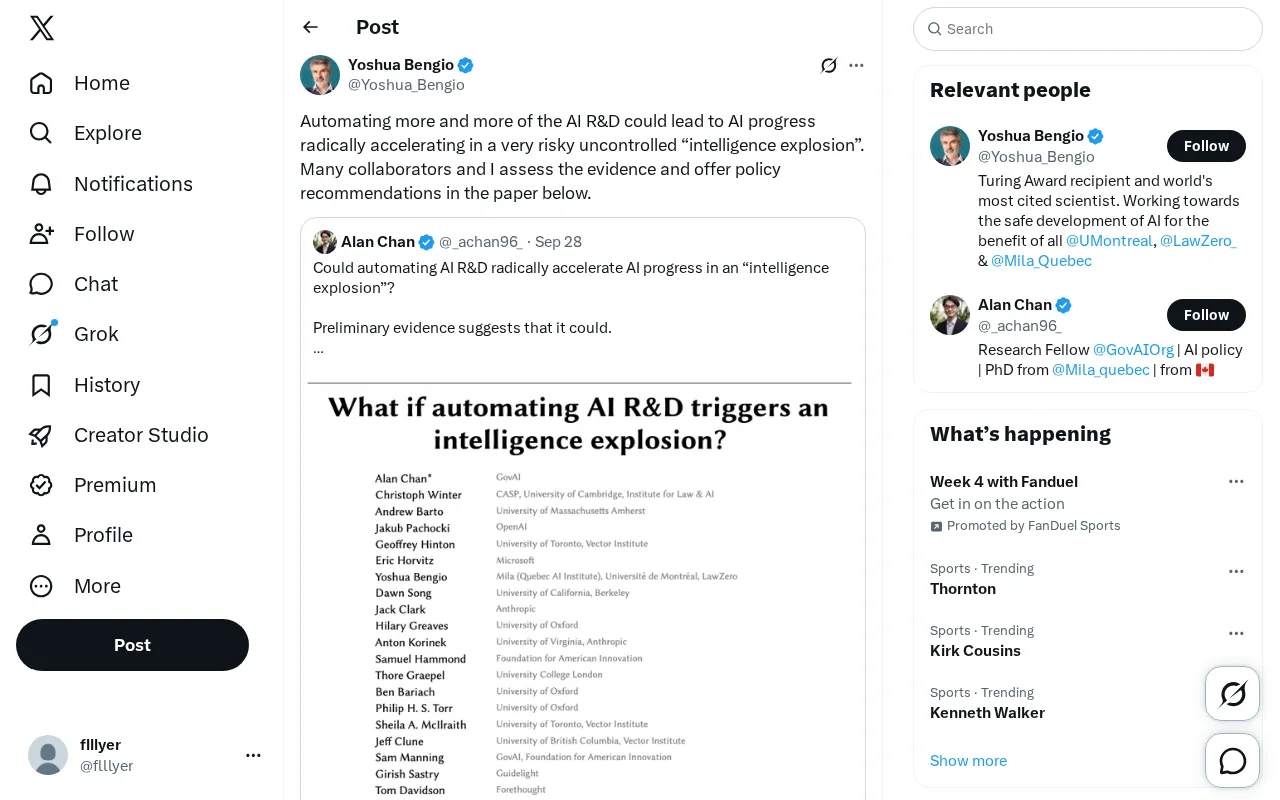
这条看似简短的表态,触及了当前AI安全讨论中最具争议也最受关注的话题之一:当AI开始参与甚至主导对自身的研发时,技术迭代的节奏是否会脱离人类的掌控?
什么是“智能爆炸”
“智能爆炸”并非新概念,它的思想源头可以追溯到早期关于递归自我改进(recursive self-improvement)的设想。其基本逻辑是:如果一个AI系统能够改进自身,或者能够设计出比自己更强的下一代系统,那么这种改进会形成正反馈循环——每一代更强的系统又能更快地造出下一代,进步速度随之呈指数级攀升。
推文中强调的关键变量是“AI研发的自动化”。当前的AI研究仍高度依赖人类研究员:设计实验、调整架构、编写训练代码、分析结果。一旦这些环节被AI逐步接管,研发周期可能从以月、以年为单位,压缩到以周甚至以天为单位。原文所用的“radically accelerating”(急剧加速)正是指向这种量变到质变的临界点。
为什么说风险“不可控”
原文特别使用了“risky uncontrolled”(高风险、不受控)这两个限定词,这是整条声明的重点所在。加速本身未必是坏事,真正令人担忧的是加速与失控的叠加。
当技术迭代速度超过人类的理解、评估和监管能力时,几个问题会同时出现:人类研究者来不及验证新系统的行为是否安全;安全测试和对齐(alignment)工作可能被进步速度甩在身后;决策权在事实上逐步从人类转移到系统本身。换句话说,问题不在于AI变强,而在于变强的速度让人类失去了踩刹车的窗口。
从技术判断走向政策建议
值得关注的是,这条声明并没有停留在技术推演层面,而是明确提到了“policy recommendations”(政策建议)。这反映出AI安全领域一个日益明显的趋势:研究者不再只是描述风险,而是主动推动治理层面的应对。
论文由“许多合作者”共同完成,这种多人署名、集体评估证据的形式,本身就说明该议题已经超出个人观点的范畴,进入需要学界协同论证的阶段。虽然推文未披露具体的政策建议内容,但从其论述框架可以推测,重点可能集中在对高风险AI研发活动的监测、对自动化研发能力的评估门槛,以及在加速到来之前建立可操作的安全保障机制。
AI安全研究向政策领域延伸,目前已形成若干具体的治理路径探索。代表性举措包括:美国政府2023年发布的AI行政令要求大型模型开发者在发布前向政府披露安全测试结果;英国AI安全研究所(AISI)和美国对应机构负责对前沿模型进行独立红队测试;学界则推动"计算阈值"监管框架,即对训练算力超过特定量级的模型实施强制报备。这些机制的共同逻辑是:在加速到来之前,先建立可操作的观测点和干预节点,而不是等到技术已经超出掌控再讨论规则。该推文提及的论文若聚焦于研发自动化场景,其政策建议很可能也沿着类似思路展开。
如何理性看待这条警告
对于这类关于“智能爆炸”的论断,保持审慎的态度是必要的。一方面,AI自动化研发确实在真实发生——代码生成、实验设计辅助、模型评估自动化等工具正在被广泛采用,加速趋势有现实基础。另一方面,从“加速”到“失控的智能爆炸”之间,仍存在大量不确定性,包括算力瓶颈、数据限制、以及物理世界反馈循环的制约。
这条推文的价值,不在于断言某个结局必然发生,而在于提醒:当技术具备自我加速的潜力时,提前讨论治理框架远比事后补救更重要。无论“智能爆炸”最终是否以极端形式出现,围绕AI研发自动化的安全评估和政策准备,都已成为当下不能回避的课题。
小结
这条源于推特的声明,用一句话浓缩了AI安全领域的核心焦虑:自动化研发可能把AI进步推向一个人类难以控制的加速区间。它背后是一篇由多位研究者合作、评估证据并提出政策建议的论文。对普通读者而言,不必被“智能爆炸”这样的词汇吓住,但也应认识到——围绕AI发展速度与可控性的讨论,正在从科幻想象变为严肃的现实议程。
背景补充
"智能爆炸"这一术语最早由数学家I·J·古德(I. J. Good)在1965年的论文中系统阐述。他提出了"超智能机器"的概念:一旦机器在智能上超越人类,它就能设计出更聪明的机器,由此触发无需人类介入的自我迭代链条。这一设想后来被科幻作家弗诺·文奇(Vernor Vinge)和未来学家雷·库兹韦尔(Ray Kurzweil)分别以"技术奇点"(Technological Singularity)的框架加以发展和普及。值得注意的是,递归自我改进不一定要求AI直接修改自身权重或代码——当AI系统能够高效执行研究员的工作(提出假设、设计实验、分析结果、撰写论文),从而大幅缩短人类主导的研发周期时,从功能上同样可以实现类似的加速效果。这也是当前讨论将焦点从"AI改写自身"转向"AI自动化研发流程"的原因。
AI安全领域将这类失控风险的核心机制归纳为"对齐问题"(alignment problem):如何确保一个能力持续增强的AI系统,其行为目标始终与人类意图保持一致。当系统能力远超人类时,即便微小的目标偏差也可能被放大为灾难性后果。与此密切相关的还有"能力评估滞后"问题——现有的安全评估基准往往在模型发布后才被验证已经过时,在加速迭代的场景下,评估工具追不上系统能力提升的速度,安全承诺就失去了实质支撑。此外,"梅森阈值"(Overhang)效应也需关注:大量已积累但尚未被充分利用的算力和数据,一旦被自动化研发流程释放,可能产生远超线性预期的跃升,进一步压缩人类的反应窗口。
相关推荐

私钥设为4?CA机构低级错误致TLS体系裸奔
CA机构eMudra将私钥设为数字4等极小值,导致TLS证书可被暴力破解。Computerphile视频演示了从提取公钥到伪造证书的完整过程,并探讨了PKI信任链的脆弱性。

Gen如何用ChatGPT Work把数据变决策
OpenAI用户案例中,企业领导者Gen分享用ChatGPT Work将数据转化为决策的实践:产品上线几小时内即可判断集成与引导流程是否有效,决策迭代从上百次试错变为快速反馈闭环。

ChatGPT与Claude深度对比:编程强但研究弱,如何弥补?
用户考虑从ChatGPT转向Claude,发现Claude编程更强但研究较浅。本文分析两者差异,并提供让Claude研究更深入的实用技巧,帮助您做出明智选择。