Amazon Quick 实时数据:AI 应用直连受治理数据集

Amazon QuickSight新功能让AI生成的应用从静态快照升级为实时查询,并按查看者身份自动执行行列级安全策略。
Amazon QuickSight 推出的 Live Data in Apps 功能,解决了 AI 构建应用长期依赖静态数据快照的两大核心痛点:数据新鲜度不足与权限隔离缺失。新功能让 AI 生成的应用在每次用户访问时实时查询受治理的 QuickSight 数据集,而非读取构建时的历史副本。更关键的是,每次查询以当前查看者的身份执行,行级安全与列级安全规则自动按读者生效,无需为不同角色单独构建应用。结合自然语言构建与发布能力,业务人员无需编写代码即可独立创建可共享的实时数据应用,数据治理规则在数据集层面统一定义后由所有应用自动继承。在高并发场景下的性能表现及复杂逻辑的自然语言边界,仍有待实际部署验证。
从静态快照到实时查询的转变
Amazon Quick 推出的 Live Data in Apps 功能,改变了 AI 构建应用获取数据的方式。过去,AI 生成的应用往往依赖构建时的静态数据快照(build-time snapshots)——也就是说,应用在创建那一刻把数据"拍照"固定下来,之后展示的内容始终停留在那个时间点。这种模式对于演示和原型足够,但在真实业务场景中很快就会暴露问题:数据过期、决策滞后、用户看到的永远不是最新状态。
Live Data in Apps 的核心变化在于,AI 构建的应用会实时查询你在 QuickSight 中受治理的数据集,而不是读取固定的历史切片。每一次用户打开或刷新应用,看到的都是当前的真实数据。这让 AI 应用从"展示工具"升级为"可用于日常运营的数据产品"。
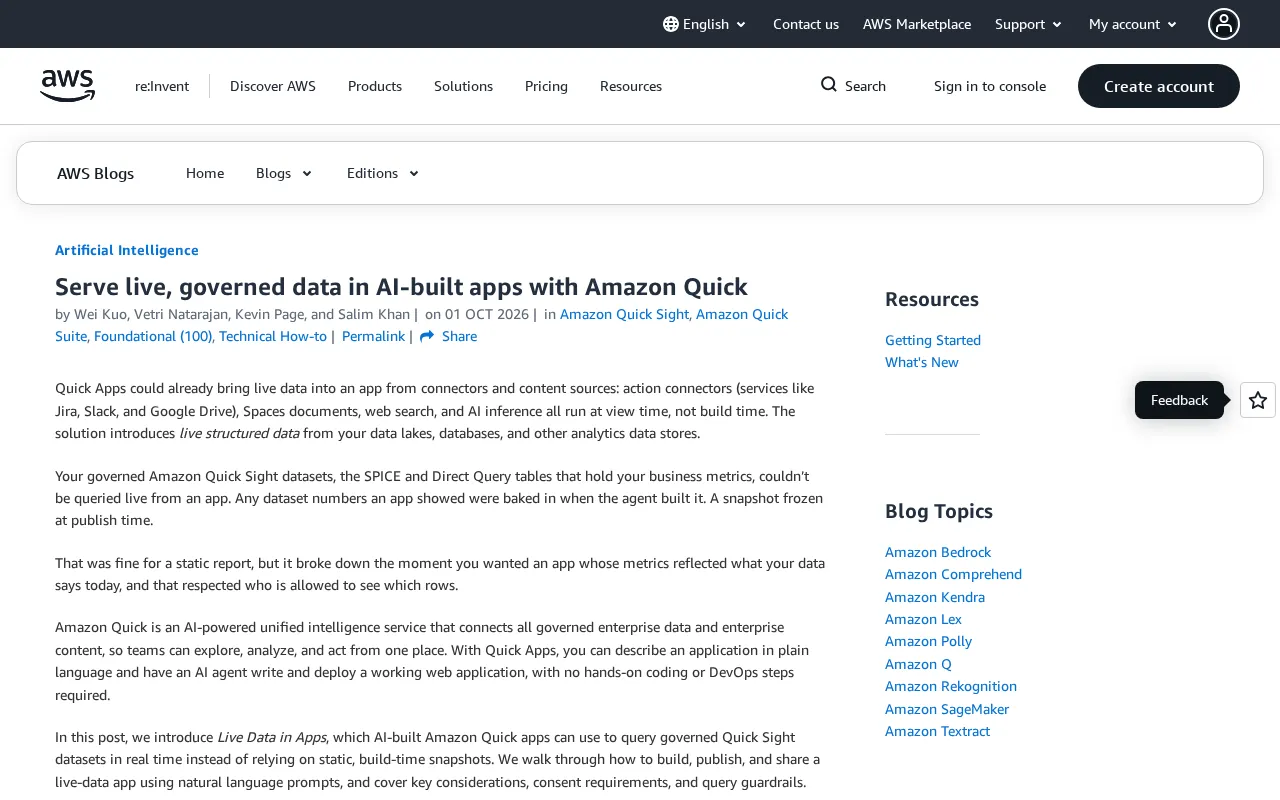
静态数据快照(build-time snapshot)本质上是一种"数据物化"策略:在应用构建或部署时,将查询结果缓存为固定副本,后续访问直接读取该副本而不回源。这种做法的优点是响应快、不依赖实时数据库连接,但代价是数据时效性受限于快照刷新频率。对于日更新的报表尚可接受,而对于库存余量、实时收益或风控指标等需要分钟级甚至秒级精度的场景,快照模式会让业务决策基于"过去的现实"。实时查询(live query)则绕过缓存层,每次请求都向数据源发起实际查询,保证结果与源头同步,但对数据库并发处理能力和查询优化提出了更高要求——这也是文末"性能与成本影响"值得持续关注的根本原因。
按读者身份执行的安全模型
这项功能最值得关注的设计,是它的权限执行机制。每一次查询都以当前查看应用的人的身份运行(runs as the person viewing the app),而不是以应用创建者的身份统一执行。
这意味着行级安全(row-level security)和列级安全(column-level security)会针对每一位读者分别生效。举例来说,同一个销售仪表盘应用,华东区的经理只能看到华东区的数据,财务人员可能看不到某些敏感薪资列,而这一切不需要为每个角色单独构建应用。治理规则在数据层统一定义,应用自动继承。
为什么这对企业很关键
在企业环境中,"谁能看到什么数据"从来不是小问题。传统做法常常面临两难:要么为了安全而限制 AI 应用访问真实数据,要么为了灵活而牺牲数据治理。Live Data in Apps 把安全边界下沉到数据集层面,让 AI 应用既能直连生产数据,又不会绕过已有的合规与权限体系。对于受监管行业,这种"治理一次、处处生效"的模式尤其有价值。
行级安全(Row-Level Security,RLS)和列级安全(Column-Level Security,CLS)是数据仓库与BI系统中的两种主流访问控制机制。RLS通过在查询层附加过滤条件,使不同用户在访问同一张表时只能看到属于自己权限范围内的行——例如销售人员只能看到自己负责区域的订单记录。CLS则在列维度上做限制,特定字段(如薪资、身份证号)对无权限用户完全不可见,查询结果中该列直接缺失。两种机制通常在数据库或数据集层面集中配置,由安全策略引擎在运行时动态注入到每条查询中。QuickSight 的 RLS 支持通过"权限数据集"将用户标识映射到允许查看的维度值,这套规则一旦定义,所有连接该数据集的可视化与应用均自动受约束,无需在每个消费端重复实现访问控制逻辑。
用自然语言构建、发布与共享
另一个实用维度是构建门槛的降低。根据官方描述,用户可以通过自然语言来构建、发布和共享一个实时数据应用。你不需要写复杂的查询逻辑或前端代码,而是用接近日常语言的方式描述需求,由 Amazon Quick 生成对应的应用。
这延续了当下 AI 工具"降低技术门槛"的整体趋势——把数据分析的能力交到业务人员手中。配合实时数据和自动继承的安全策略,一个业务负责人理论上可以独立完成从想法到可共享应用的全过程,而无需每次都排队等待数据工程团队支持。
价值与待观察的问题
整体来看,Live Data in Apps 解决了 AI 构建应用长期以来的两个痛点:数据新鲜度和权限隔离。把实时查询与逐读者执行的安全模型结合,是一个思路清晰的产品设计。
不过从公开信息来看,仍有一些细节值得在实际使用中验证:实时查询对底层数据集的性能与成本影响如何?在高并发场景下逐读者执行安全策略的延迟表现怎样?自然语言构建的应用在复杂逻辑上的边界在哪里?这些都需要结合具体部署规模来评估。对于已经在使用 QuickSight 并积累了数据治理规则的团队来说,这项功能的迁移成本相对较低,值得优先试用。
相关推荐

LLaMA-Factory实战:零代码微调大模型全流程
本文介绍LLaMA-Factory开源微调工具,涵盖其60.1K Star项目背景、支持的模型与算法、本地与云服务器部署选择,以及CUDA环境安装步骤,帮助零基础开发者快速上手大模型微调。

曾鸣深度复盘:OpenAI为何难成终局赢家?公司制度将消亡
曾鸣在张晓骏商业访谈录中深度复盘AI终局:模型公司只是基础设施,OpenAI、Anthropic难成最终赢家;下一战役是Agent入口标准之争;公司制度将因AI重构而消亡,只有使命驱动的企业能穿越周期。

OpenHands v1.28.0:OpenCode与PI成内置Agent,密钥可对话申请
OpenHands 21天连推5个版本,v1.27.0将OpenCode与PI写入内置Agent列表,v1.28.0支持对话内申请密钥。本文梳理ACP协议接入方式、凭证复用规则、模型列表变更及升级建议。