AMD新款256核EPYC登场:16通道DDR5-12800逼近RTX 5090内存带宽

AMD 256核EPYC以16通道DDR5-12800逼近RTX 5090带宽,但高昂成本与有限推理速度让其仍属极客专属。
AMD最新曝光的EPYC处理器凭借256个物理核心与16通道DDR5-12800内存,将CPU平台的理论内存带宽推至逼近NVIDIA RTX 5090的91%,在LocalLLaMA社区引发广泛讨论。这一规格为希望以大容量系统内存承载超大参数模型、绕开GPU显存限制的本地推理用户提供了新思路。然而社区讨论也揭示了两大现实约束:其一,带宽接近并不等同于推理性能对等,GPU在并行浮点算力和访存延迟上仍具本质优势,纯CPU推理的实际token吞吐依然有限;其二,配齐TB级高频RDIMM内存所需的成本极其高昂,"两个肾"的玩笑折射出真实的价格门槛。该产品更多代表服务器CPU向AI工作负载靠拢的行业趋势,是面向企业与顶级发烧友的标杆,而非普通用户的实用选择。
AMD再度刷新服务器CPU极限
AMD最新曝光的EPYC处理器带来了一组令人咋舌的规格:256个物理核心、16通道DDR5-12800内存支持,其内存带宽据称达到了NVIDIA RTX 5090的91%。这一数字对于一颗CPU平台而言相当罕见,也是本次讨论在Reddit的LocalLLaMA社区引发热议的核心原因。
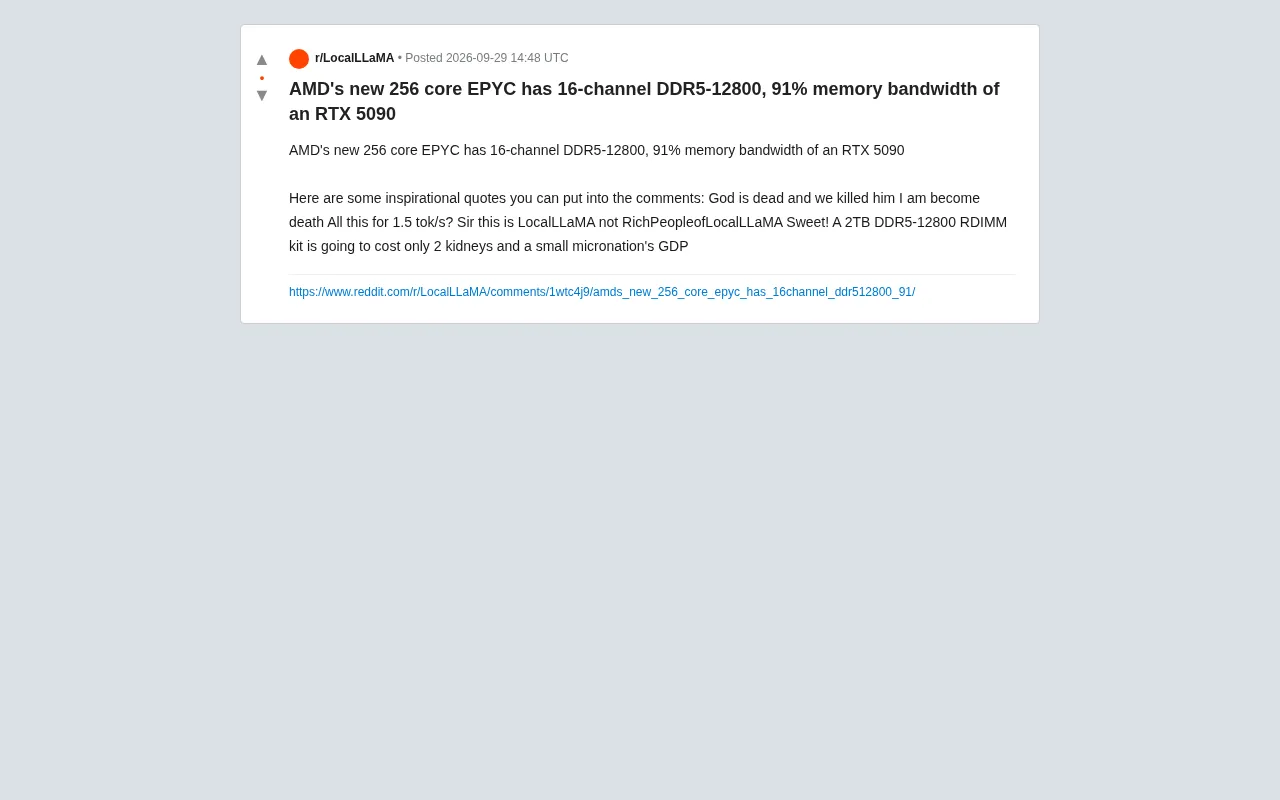
对于长期依赖GPU显存带宽运行大模型的本地推理玩家来说,CPU平台能够接近旗舰消费级显卡的带宽水平,意味着一种全新的部署思路——用海量系统内存承载超大规模模型,绕开GPU显存容量的硬性天花板。
16通道DDR5-12800意味着什么
传统消费级平台通常只有双通道内存,而这款EPYC直接跳到了16通道,配合DDR5-12800的高频率,理论带宽被推到了一个前所未有的高度。带宽是大语言模型推理的关键瓶颈之一:模型参数需要在每次前向计算时被反复读取,带宽越高,token生成速度往往越快。
达到RTX 5090约91%的带宽,意味着这套平台在纯带宽指标上已经能与顶级消费显卡掰手腕。不过需要强调的是,CPU与GPU在计算架构上存在本质差异,GPU拥有远超CPU的并行浮点算力,因此带宽接近并不等于实际推理性能对等。
DDR5-12800中的"12800"指的是内存模块的传输速率,即每秒12800 MT/s(兆次传输),对应的内存时钟频率约为6400 MHz。相比之下,主流消费级DDR5通常运行在4800–6400 MT/s,而服务器平台通过更高的供电设计和更严格的信号完整性标准,得以将频率推至更高区间。16通道意味着处理器与内存控制器之间有16条独立的数据通路同时工作,总带宽约等于单通道带宽乘以16。以DDR5-12800为例,单通道理论峰值带宽约为102.4 GB/s,16通道叠加后理论总带宽可突破1.6 TB/s,这一数字远超普通消费级四通道平台(通常在150–200 GB/s区间),也是其能与RTX 5090显存带宽相提并论的根本原因。这类高通道数设计通常出现在Intel Xeon或AMD EPYC等企业级多路平台上,需要配套使用RDIMM或LRDIMM规格的注册式内存,而非普通消费级DIMM。
社区的调侃背后是真实的成本焦虑
Reddit评论区一如既往地充满黑色幽默。有人调侃“全部这些配置只为了1.5 tok/s?”,也有人打趣“先生,这里是LocalLLaMA,不是RichPeopleofLocalLLaMA(本地大模型富人区)”。
最扎心的一条评论直指成本:“一套2TB的DDR5-12800 RDIMM内存,只需要两个肾和一个小型微型国家的GDP。”
这些玩笑背后是本地大模型爱好者的真实痛点。要真正发挥256核EPYC的能力,需要配齐大容量、高频率的RDIMM内存条,而这类企业级高频内存的价格极其高昂。理论带宽再漂亮,如果内存配置无法拉满,实际能跑出的性能和体验也会大打折扣。
高核心数不等于高推理速度
评论中“1.5 tok/s”的吐槽点出了一个常被忽视的现实:即便拥有256核和惊人的内存带宽,纯CPU推理超大模型的实际token吞吐往往仍不理想。核心数带来的并行度、内存带宽、以及模型本身对算力的需求之间需要精细平衡,堆料并不能线性转化为速度。
大语言模型的推理过程可以拆解为两个主要阶段:prefill(预填充)和decode(解码)。prefill阶段需要处理输入的所有token,计算密集度高,能够充分利用大量并行核心;而decode阶段每次只生成一个新token,属于典型的"内存带宽受限"(memory-bandwidth-bound)操作,因为每生成一个token都必须将模型全部权重从内存加载一遍,核心数再多也无法掩盖带宽不足带来的等待时间。这也是为何即便CPU拥有256核,token/s速度依然可能不理想——瓶颈在于单次decode所需的数据搬运量,而非计算能力本身。GPU之所以在推理上占优,不仅因为其带宽更高,还因为GPU的内存(HBM)在物理上与计算单元的距离极短,访存延迟远低于CPU平台通过多级总线访问的系统内存。
对本地大模型玩家的现实意义
这颗EPYC代表了服务器级平台向AI工作负载靠拢的趋势。对于追求超大参数模型、又不愿或无法堆砌多张高端GPU的用户,高带宽CPU平台提供了另一种可能性——尤其是在需要海量内存容纳完整模型权重的场景下。
但从消费和实用角度看,这仍是一套面向企业和极客发烧友的方案。高昂的CPU、动辄TB级的高频内存成本,让绝大多数个人用户望而却步。它更像是一个展示行业硬件极限的标杆产品,而非普罗大众的本地部署首选。
结语
256核、16通道DDR5-12800、逼近RTX 5090的内存带宽——这些数字本身足够震撼,勾勒出AMD在服务器CPU领域持续加码AI相关能力的野心。但正如社区评论所提醒的,规格的光鲜与落地的成本、实际推理体验之间,仍存在不小的落差。对本地大模型社区而言,这既是一次令人兴奋的技术展示,也是一次关于“堆料是否值得”的冷静讨论。
相关推荐
《珠峰:另一面》预告释出:滑雪登山者挑战北壁滑雪下降
国家地理《珠峰:另一面》预告发布,记录职业滑雪登山者挑战珠峰直北壁并首次滑雪下降的惊险历程,包含罕见北壁影像与雪崩生死瞬间。
用NVIDIA PhysicsNeMo构建汽车碰撞AI代理模型
解析NVIDIA PhysicsNeMo碰撞分析工作流:如何用仿真数据集训练Transolver代理模型,并通过NIM封装为推理API,覆盖几何参数化、数据切分与误差验证的完整四步流程。
LangGraph生产环境:API静默变更之痛
探讨LangGraph Agent在生产环境中遇到外部API静默变更的挑战,分析现有监控与测试的局限性,并提出语义验证、回归测试等防御策略,帮助开发者提升系统稳定性。