Anifer开源推理引擎实测:单卡5090狂飙150 token/s
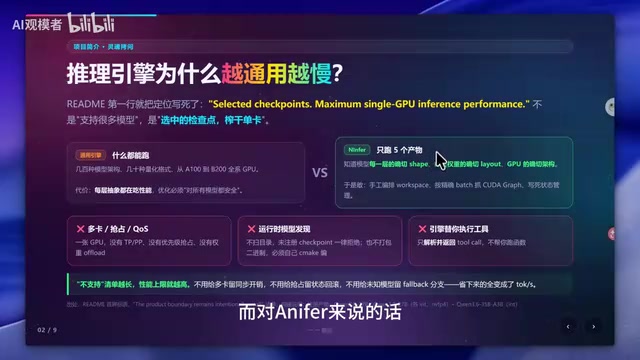
Anifer 是专为极少数模型和特定显卡深度优化的C++/CUDA推理引擎,以牺牲通用性换取极致速度。
Anifer 是一款由独立开发者用 C++ 和 CUDA 编写的开源本地推理引擎,与 vLLM、llama.cpp 等追求广泛兼容的主流框架不同,它只针对五个 Qwen 系列模型和 RTX 5090 做极致优化,将所有开发资源集中于性能榨取。官方数据显示 Qwen3.6 27B 在 8 并发下可达 1147 token/s,博主实测 Qwen3.8 27B 单并发稳定 144~150 token/s,四并发长时运行不衰减。速度提升来自两方面:一是放弃通用抽象、直接针对固定硬件写最优 CUDA Kernel;二是支持 MTP 投机解码,接受率约 46%~49%。模型采用 .enifer 单文件格式打包,下载即用,但无法直接加载 GGUF 文件。官方仅支持 Linux + RTX 5090,但社区已扩展至 4090、2080Ti 及 Windows 原生环境。
一个专为极致速度而生的推理引擎
在本地大模型部署领域,推理速度一直是绕不开的痛点。最近一个在 GitHub 上开源、被UP主戏称为「疾风之狼」的推理引擎 Anifer,把这件事推到了一个新的高度。它由独立开发者用 C++ 和 CUDA 编写,直接贴近底层硬件,专注于把有限的几款模型和显卡榨出极致性能。
用 C++ 和 CUDA 这类底层语言写推理引擎,对开发者是不小的挑战,代码复杂度高、维护成本大。但换来的回报是硬件层面的深度优化——对最终用户而言,这意味着更快的解码速度和更低的延迟。
Anifer 的官方项目最初只支持单张 RTX 5090,且仅针对少数几个模型做优化。它注册的官方模型只有五个,聚焦于 Qwen3.8 27B、上一代 Qwen3.6 27B 以及 Qwen3.6 35B 的抽稀(MoE)模型。这种「少而精」的策略,正是它速度惊人的核心原因。
为什么它比 vLLM、SGLang 更快
要理解 Anifer 的速度优势,得先看主流推理框架的困境。vLLM、SGLang、llama.cpp 是目前最常用的三大推理框架,它们的共同特点是「大而全」——需要适配几百种模型架构(Qwen、Gemma、Llama 等),兼容各种量化格式(NVFP4、AWQ 等),还要照顾从英伟达 A 系列、B 系列商用卡到各类家用零售卡的不同硬件。
这种全面兼容的代价,是架构越来越臃肿。维护者只能给出一个「折中」的性能方案——什么模型都能跑、什么卡都能用,但没法针对某张特定显卡做深度优化,性能自然要打折扣。
UP主用了一个贴切的比喻:Anifer 就像 PS4 Pro 这类专用游戏机,而 vLLM、llama.cpp 则是五花八门的 PC 市场。PS4 Pro 的内核性能大概只相当于 RTX 5070 的水平,但因为只有一款固定硬件,游戏厂商能把优化做到极致,实际跑游戏的流畅度反而像 5090。Anifer 只针对五个模型、一款显卡优化,把开发者的全部精力都投入到速度上,这就是它「快」的底层逻辑。
vLLM 和 SGLang 都属于「服务型推理框架」,设计目标是在生产环境中高效调度大量并发请求,支持连续批处理(Continuous Batching)、PagedAttention 等技术,能在多用户场景下最大化吞吐量。llama.cpp 则走另一条路,用纯 C/C++ 实现,主打跨平台兼容性,可以在 CPU、Apple Silicon、各种消费级 GPU 上运行量化模型。这三者的共同代价是抽象层厚重——为了让同一套代码驱动数百种模型和硬件,必须引入大量条件分支、通用内核(Kernel)和运行时判断逻辑,无法对特定硬件的寄存器数量、共享内存布局、Tensor Core 利用率做针对性调优。CUDA Kernel 的性能极度依赖「对齐」——矩阵维度、线程块大小、内存访问模式稍有不匹配,吞吐量就会大幅下滑。Anifer 因为只服务固定的模型形状和固定的显卡架构,可以把每一个 Kernel 都写成「恰好最优」的形态,这是通用框架结构上做不到的事。
官方跑分:从 200 到 1147 token/s
Anifer 的并发上限是 8,对普通用户完全够用——单张 5090 开 8 并发,显存也基本撑到极限。以下是官方给出的部分跑分数据(理想环境下):
Qwen3.6 27B 稠密模型
采用 NVFP4 量化时,单并发(C=1)可达 202 token/s,双并发(C=2)翻倍到 400 token/s,几乎没有损失。并发到 4 时约 700 token/s(理论应为 800,略有折损),8 并发时冲到惊人的 1147 token/s。
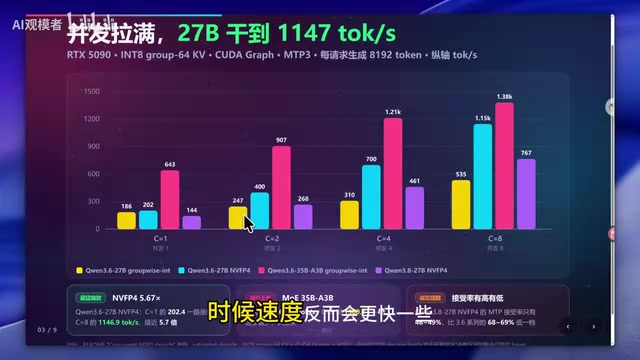
另一种 GGUF 量化格式下,双并发时最高达到 247 token/s,反而比单并发更快。
Qwen3.6 35B MoE 模型
这个 MoE 模型的速度更夸张,8 并发直接冲到 1.38k token/s。不过 UP主也提醒,如果真开到 8 并发还要维持这个速度,上下文长度基本所剩无几,实用性有限。
亲测:Qwen3.8 27B 单并发稳定 144 token/s
UP主用自己的 5090 实测了 Qwen3.8 27B,数据经得起推敲:
- 单并发:官方标称 144 token/s,实测完全可达,有时甚至能到 150
- 双并发:268 token/s,平均每并发约 130 token/s
- 四并发:实测 4 路并行加起来约 400 token/s,且长时间不衰减——在跑到六七分钟、七八分钟时仍能维持 94~112 token/s
测试时上下文拉到 120k,5090 的 32G 显存基本顶满,速度依然坚挺。这说明官方数据在 Qwen3.8 27B 上至少是靠得住的。
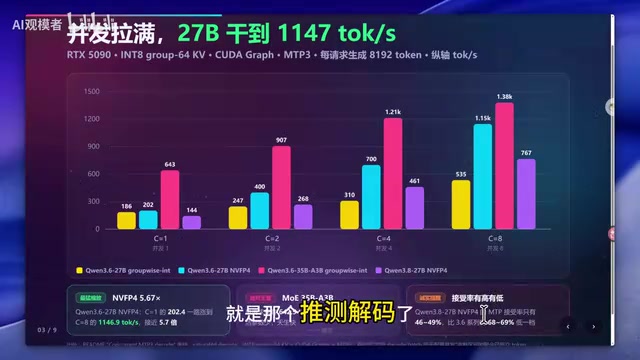
速度飞快的另一个原因是投机解码。Anifer 支持 MTP(多 Token 预测),接收率在 46%~49% 之间,实测确实接近这个水平。此外它还支持 D Flash 投机解码,但显存占用更高。UP主使用 MTP 开到 3,速度与官方展示一致。
投机解码(Speculative Decoding)是一种利用小模型辅助大模型加速生成的技术:先用一个轻量级「草稿模型」快速生成若干候选 Token,再让主模型一次性并行验证这批候选——若接受,则相当于一次前向传播完成了多步解码,整体吞吐显著提升。MTP(Multi-Token Prediction)是其中一种变体,不依赖独立的小模型,而是在主模型内部附加额外的预测头,直接预测后续多个 Token,结构更紧凑、显存开销更小。接受率(Acceptance Rate)是衡量投机解码效果的核心指标:46%~49% 的接受率意味着草稿 Token 中约有一半被主模型采纳,在实践中已属较高水平,能带来可观的速度提升而不影响输出质量——被拒绝的 Token 会被丢弃并回退,最终生成结果与纯自回归解码在数学上等价。
.enifer 单文件:是优点也是缺点
Anifer 使用一种名为 .enifer 的单文件格式,把模型权重、chat template(系统提示词)以及多模态相关内容全部打包成一个文件。
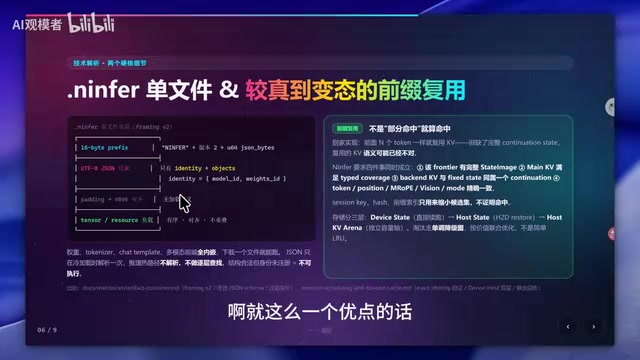
这个设计有两面性。缺点是你必须专门下载 .enifer 文件,普通的 GGUF 文件无法直接加载。优点是省心——大家都知道 Qwen 开源模型的系统提示词需要手动替换,而这个格式直接打包好,下载即可运行,免去了折腾提示词的麻烦。
GGUF 是 llama.cpp 生态主导的模型文件格式,全称 GPT-Generated Unified Format,设计目标是将模型权重、量化参数、词表、元数据等全部存入单一文件,已成为社区分发量化模型的事实标准,HuggingFace 上绝大多数社区量化版本都以此格式发布。Chat Template 则是嵌入模型配置中的对话格式模板,规定了系统提示词、用户轮次、助手回复应如何拼接成最终输入序列。不同模型家族(Llama、Qwen、Gemma)的 Chat Template 格式差异较大,手动配置错误会直接影响模型的指令遵循能力。.enifer 格式将权重与 Chat Template 捆绑打包,牺牲了与通用生态的互操作性,但对普通用户来说确实降低了上手门槛,避免了因模板配置错误导致效果变差的常见坑。
硬件门槛与显卡支持范围
官方项目仅支持 RTX 5090,系统方面只支持 Linux 或 WSL/Docker(Docker 同样需要 Linux 环境)。但因为项目开源,社区已经涌现出大量分支:
- 显卡:4090 已支持,甚至有人做了 RTX 2080Ti、20 系显卡的适配,主要集中在英伟达阵营
- 系统:有人做了 Windows 原生版本,无需安装虚拟机
CUDA 版本这类环境配置确实需要动手,但把项目页面丢给 AI 智能体(如 CUDAX),让它帮你适配显卡、改配置,难度也不算大。前提是你的显卡硬件本身要达标——12G 显存的卡连 Qwen3 27B 都跑得吃力,就别指望改配置硬上了。一般玩本地部署的用户,16G 甚至魔改版 20 多G 显存的卡跑这个框架问题不大。
值不值得一试
只要你的显卡在 Anifer 的支持列表里,它就非常值得尝试——速度实测靠谱,长时间运行不衰减,prefill 速度也够快,几乎不用等太久就开始吐 Token。
它的取舍很清晰:牺牲通用性,换取极致速度。这与 vLLM、llama.cpp 追求的「万金油」路线截然不同,但对于手握 5090、只想快速跑几个主流 Qwen 模型的用户来说,Anifer 提供了一个近乎完美的解决方案。
相关推荐
Automattic高管在Mullenweg短暂离任期间签署互惠离职协议
Automattic公司CFO Mark Davies与法务负责人Andy Missan在Matt Mullenweg短暂离任期间相互签署离职补偿协议,包含一年薪资与额外股权归属,引发公司治理透明度关注。
H3 Singularity优化技巧:加速40%还能提升画质
Reddit社区分享的Minimax Singularity工作流优化技巧:在H3 Latent前插入RTX上采样器,实现40%加速同时提升画质,附参数取舍与12bit输出实践经验。
X上线Cashtags股票交易功能,社交与市场界限消融
X(原Twitter)宣布向美国用户开放通过Cashtags直接交易的功能,打通市场讨论与实际交易的通道。本文解析这一功能的运作逻辑、社交交易的机遇与风险,以及平台边界扩张背后的趋势。