Anima用GPT-6与GPT-Live将诊所电话等待缩短75%
Anima 用 GPT-6 与 GPT-Live 将诊所电话等待时间缩短 75%,探索医疗实时语音 AI 落地。
Anima 将 OpenAI 的 GPT-6 与 GPT-Live 接入诊所电话与患者沟通链路,宣称把电话等待时间缩短了 75%。其思路不是做独立外呼机器人或完全替代人工,而是扩展护理团队的响应容量:GPT-Live 负责实时交互,GPT-6 负责复杂语境理解与回复生成,使模型参与到通话中的实时决策而非事后生成文本。文章认为,等待时间这类可量化运营指标比抽象智能程度更易打动诊所管理者,但 75% 仍是厂商侧数据,实际效果受诊所规模、来电类型与部署方式影响;医疗实时 AI 的真正门槛在于语音质量、术语准确性、安全可控与合规适配,人机协作仍是当前主要落地形态。
诊所电话长时间占线,一直是患者体验中最难改善的环节之一。Anima 正在尝试用 OpenAI 的最新模型——GPT-6 和 GPT-Live——来解决这个问题,并宣称已将电话等待时间缩短了 75%。这个数字背后,是医疗场景对 AI 响应能力和实时性的双重考验。
Anima 做了什么:把模型能力嵌入诊疗流程
根据官方信息,Anima 扩展了护理团队使用 OpenAI 模型的方式,核心目标是提升团队响应患者的能力。简单来说,它不是做一个独立的外呼机器人,而是把模型能力接入诊所日常的电话与患者沟通链路中。
GPT-6 负责理解复杂语境与生成回复,GPT-Live 则承担实时交互的部分。两者的组合让系统能够在通话过程中快速给出有意义的回应,而不是让患者听着一遍遍的等待音乐。这种分工也解释了为什么等待时间能有明显的下降——模型不再只是事后生成文本,而是参与到实时对话的决策中。
Anima expands what care teams can do with OpenAI models, giving them more capacity to respond to patients.
GPT-Live 与实时语音交互
GPT-Live 是面向实时对话场景优化的模型形态,与传统的“语音转文字→大模型生成→文字转语音”串行管线不同,它强调在通话进行中持续接收音频流并低延迟地产出回应。实时语音交互的核心指标不只是准确率,还包括端到端延迟、打断处理(barge-in)、轮次判断(何时该说、何时该听)以及噪声鲁棒性。这些能力决定了患者是否会感到“对面有人在听”,而不是在跟一个反应迟钝的系统对话。对于电话这种纯语音、无视觉线索的媒介,延迟超过数百毫秒就会明显损害自然感,因此实时模型通常需要在推理速度与回复质量之间做专门权衡。
75% 的等待缩减意味着什么
75% 是一个值得拆解的指标。电话等待时间直接关系到患者满意度、放弃率以及诊所前台的工作压力。等待时间大幅下降,通常意味着更多来电能在更短时间内被接起或得到有效回应。
对诊所而言,这不仅是体验层面的改善,也是运营层面的释放:护理团队可以把精力从重复的接听和转接中抽出来,投入到真正需要人工判断的环节。Anima 强调的“扩展护理团队能做的事”,正是指这种容量上的变化——不是替代人,而是让同样的人力覆盖更多患者需求。
弃呼率(Abandonment Rate)与电话等待指标
在呼叫中心与患者服务语境中,等待时间通常与几个配套指标一起衡量:弃呼率指来电者在被接起前主动挂断的比例;服务水平(Service Level)常以“X% 的来电在 Y 秒内被接起”表述;平均处理时长(AHT)则反映单次通话占用的坐席资源。等待时间下降 75% 若同时伴随弃呼率下降,说明更多患者真正完成了预约、问询等目标动作;若只是把通话更快地转接到人工,则运营收益有限。因此评估这类宣称时,需要区分“被系统接起”与“患者问题被有效解决”这两种不同的成功定义。
医疗场景里,实时 AI 的门槛在哪
把实时模型用在医疗沟通中,难点不只在模型本身。电话语音的噪声、患者表达的不确定性、医学术语的准确性,都会直接影响系统表现。GPT-Live 这类面向实时交互的模型之所以关键,是因为它需要在不牺牲响应速度的前提下维持对话质量。
另一个隐含要求是可控性。诊所场景对错误信息的容忍度很低,系统必须在模型能力与安全边界之间找到平衡。Anima 没有披露具体的技术架构细节,但从其强调“扩展能力”而非“全自动替代”的表述看,人机协作仍是当前落地的主要形态。
医疗语音 AI 的合规与安全边界
医疗沟通场景受 HIPAA 等法规约束,涉及患者身份、病情、预约信息等受保护健康信息(PHI),系统在语音链路上需要做到传输加密、访问审计与最小化留存。此外,实时语音 AI 若涉及分诊建议或用药提示,还可能触及医疗器械软件(SaMD)与临床决策支持的监管边界。实践中常见的做法是让模型承担信息收集、预约调度与常见问题应答,把涉及临床判断的环节交由人工确认,并为通话保留转人工通道与完整记录。这也解释了为什么厂商更愿意强调“扩展护理团队能力”而非“全自动接诊”。
对医疗 AI 落地的一点判断
Anima 的案例说明,医疗领域的 AI 应用正在从后台文档处理走向前台实时交互。等候时间这类可量化的运营指标,比抽象的“智能程度”更容易打动诊所管理者,也更容易被验证。
不过,75% 的降幅目前仍是厂商侧的说法,实际效果会受诊所规模、来电类型和部署方式影响。实时语音 AI 在医疗场景的规模化,接下来要看的是长期稳定性与合规适配,而不仅是单点指标的漂亮数字。
对于关注 AI 应用落地的团队来说,Anima 提供了一个值得观察的样本:把最强模型用在最具体的痛点上,往往比做通用平台更容易讲清楚价值。
相关推荐
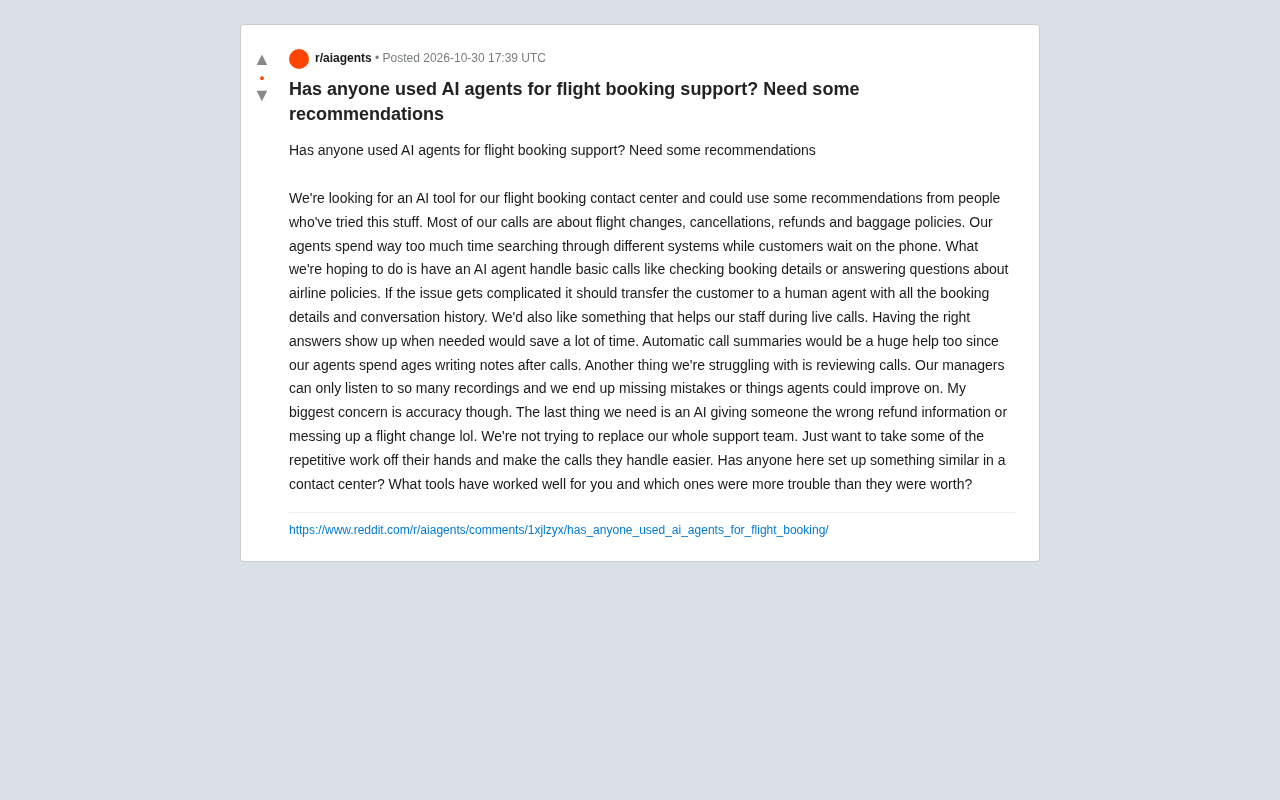
机票预订客服引入AI Agent:真实需求与落地难点
从Reddit真实提问出发,拆解机票预订呼叫中心引入AI Agent的四类需求:基础问答、座席辅助、通话摘要与质检,并分析准确性顾虑与转人工边界的设计要点。

Vercel 统一运行时缓存:Data Cache 并入 Runtime Cache
Vercel 将 Data Cache 并入 Runtime Cache,统一 Next.js fetch 缓存、unstable_cache、getCache 与 use cache: remote 的存储配额与计费,Pro 和 Enterprise 项目获得更大存储空间,缓存读写开始按 Runtime Cache 定价计费。

谷歌卫星AI服务器升空:Gemma模型在轨生成首条回复
谷歌宣布其搭载TPU的卫星成功启动,板载Gemma 4模型从太空生成首条回复,完成在轨AI推理验证。本文分析太空AI服务器的技术路径、现实约束及对边缘计算与卫星遥感的意义。