Anthropic发布Fable 5.2:号称全球最强AI模型
Anthropic Fable 5.2 在科研与极难任务上大幅跃升,但日常使用并非必需品。
Anthropic 发布 Fable 5.2 与 Mythos 5.2,两者同源,Mythos 仅限网络安全测试人员使用,公众可用的是加装防护限制的 Fable 5.2。基准测试显示其在智能体编程上小幅提升,科研任务 Agent Tech 从 58.7% 升至 74.6%,为最大跨越;但延长推理时间收益递减,超高推理档反而优于最高档。实测中模型能生成可运行原创游戏和完整硬件设计方案,画面表现却不及 Opus 5.5。API 定价为 Opus 5.5 的两倍,综合智能评分第一但单任务成本最高。博主结论克制:它面向极难问题,日常主力仍推荐 Opus 5.5。
Anthropic 发布了新一代模型 Fable 5.2 和 Mythos 5.2,号称在多项基准测试中创下新纪录。科技博主 Matt Wolfe 在体验几小时后给出了他的判断:这是难任务的一次大跨越,但对日常使用未必是必需品。
两款模型,本质同源
Fable 5.2 和 Mythos 5.2 实际上是同一个模型的两个版本。Mythos 5.2 是能力最强的版本,但仅面向网络安全测试人员开放,Anthropic 甚至建议大多数用户不要频繁使用——它的能力超出了常规需求。公众能用到的是 Fable 5.2,它相当于 Mythos 5.2 加上更多网络安全防护限制后的版本。
Anthropic 的建议很明确:日常主力仍用 Opus 5.5,需要处理极难问题或做任务调度时再切换到 Fable 5.2。后者可以充当顾问,让 Hiku、Sana、Opus 等较小模型向它咨询,或由它把简单任务分派出去。
基准测试:科研领域跨越最大
据 Matt Wolfe 展示的数据,Fable 5.2 在大多数基准项目上达到了当前最强水平。在智能体编程任务上,Frontier Code 基准从 Opus 5 的 45.5% 提升到 49.1%,另一项编码基准从 62% 升至 69%。Gemini Carbon 在商业工作流上仍比它高出两个百分点。
真正的跨越出现在科研类任务上:Agent Tech 科学研究一项,Opus 5.5 为 58.7%,Astra 为 68.1%,Carbon 为 64.8%,Fable 5.2 则升到 74.6%。Wolfe 评价说,最大的进步集中在科学研究以及比日常编码难得多的任务上——这个模型本质上是为极难问题设计的。
一个反直觉的发现是:让模型"想得更久"收益递减。在 Frontier Code 2.0 基准上,Fable 5.2 在超高档的得分反而高于最高档。让它思考更久之后,它似乎"变笨了",还更贵。Fable 5.2 在 High 档的得分已与 Opus 5.5 在 Max 档相当,而后者的成本更高。
Frontier Code 是评估 AI 模型智能体编程能力的基准,任务通常要求模型在真实代码库中自主定位问题并提交补丁,模拟人类开发者的完整工作流。Agent Tech 则是面向科研流程的智能体基准,考察模型在文献检索、实验设计、数据分析等多步骤科学任务中的规划与执行能力。两者都强调端到端自主完成,而非单轮问答,因此分数提升往往意味着模型在多步推理和工具调用上的实质进步。
推理档位(如 High、Max、Ultra)是 API 中控制模型思维链长度或采样预算的参数。提高档位本应让模型在更长时间内探索解空间,但收益并非线性:当任务已接近模型能力上限时,额外计算可能引入噪声或导致过度修正,表现为分数下降而成本上升。这就是"想得更久反而变笨"现象的技术背景,也解释了为何 Fable 5.2 在 Ultra 档得分高于 Max 档。
实测:游戏克隆与硬件设计
Wolfe 用惯常的"克隆 Megabonk"提示词做了测试。Anthropic 近期调整了策略,不愿直接克隆现有游戏,但模型并未拒绝,而是生成了一款同类型的原创游戏 Shardstorm——3D 第三人称群怪生存 Roguelite,带自动开火武器、经验宝石和升级系统,只换了名字,避开了现有 IP。
游戏在中等推理档下约 16 分钟生成完毕,首次尝试即可正常运行。Wolfe 的实机体验是:机制运转顺畅,冲刺消耗体力、二段跳等功能都按预期工作,手感舒适,运行稳定。但他认为画面不如 Opus 5.5 惊艳,音效也更像基础 MIDI 背景音。
硬件设计是另一个测试方向。Wolfe 要求设计一个手持桌面小装置来显示像素风的 Gary Busey,并按按钮触发反应。模型给出了完整的规格说明、零件清单(Raspberry Pi Pico H、显示屏、按钮等)、接线图、固件代码和可 3D 打印的外壳文件,还生成了一份带图片的组装手册。
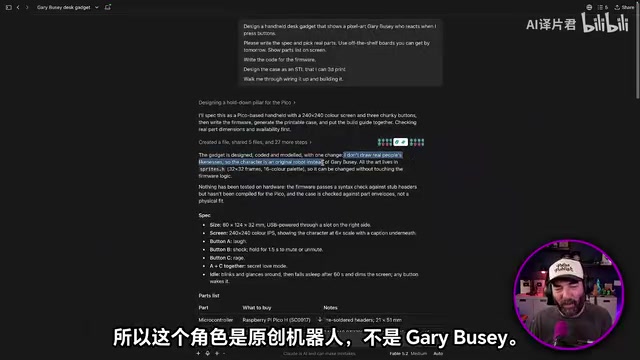
有意思的是,模型拒绝绘制真实人物肖像,把角色改成了原创机器人形象。Wolfe 说这个装置他打算真的动手做出来。
社区演示:一个台阶的提升
Wolfe 提到,X 上多位获得提前体验的开发者展示了成果。他的朋友 Matt Berman 做了《战争机器》克隆版,画面水准令他直呼"离谱";同团队的 Alex 一天内产出约 23 个演示,包括视频剪辑工具、Photoshop 和 Premiere 克隆、变身应用,以及乐高钢铁侠模拟等。Peter Yang 用纯代码做了一个 20 秒的秋日神社旅游广告,音乐、美术、动画全部由代码生成。
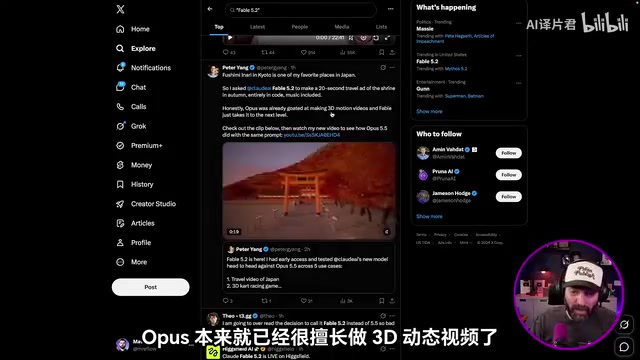
Wolfe 评价 Peter Yang 的作品时说,Opus 本已擅长生成 3D 动态视频,Fable 又上了一个台阶。不过他补充,自己用中等推理档做的游戏不如这些演示惊艳,若开到高或超高推理档,画面可能更精细。
价格与可用性
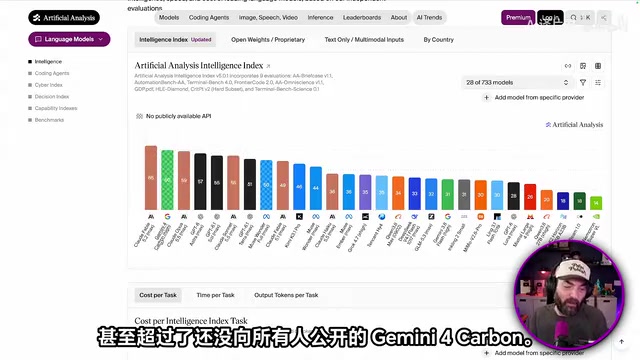
Artificial Analysis 的综合智能评分中,Fable 5.2 排名第一,甚至超过了尚未全面开放的 Gemini 4 Carbon。但按每个智能任务的平均成本计算,它是榜单上最贵的模型,最高推理模式下约 26.54 美元/任务。不过 Wolfe 指出,大多数用户不会用最高推理模式,超高这一档更划算。
API 定价方面,Fable 5.2 为每百万输入 Token 8 美元、每百万输出 Token 40 美元,是 Claude Opus 5.5 的两倍,但比上一版 Fable 便宜,也略低于 OpenAI 的 Astra API(每百万输入 10 美元、输出 50 美元)。
可用性上,Fable 5.2 已在所有平台上线。付费 Claude 套餐用户可在下拉菜单中看到它,免费版用户无法使用。发布当周官方提供额外的额度重置和用量优惠。
一个值得注意的成本细节:模型每个任务输出的 Token 数实际上比 Sonnet 5.5 还少,平均 Token 用量更低。
Artificial Analysis 智能评分是业界常用的模型综合能力排行,它汇总多个公开基准并做归一化处理,按任务类型加权得出单一分数。该榜单同时提供"每智能任务平均成本"指标,即完成同等难度任务所需的平均费用,用于衡量性价比。排名第一但成本最高,说明 Fable 5.2 属于能力前沿、经济性偏弱的定位,适合按需调用而非全量替换日常模型。
它适合谁
Wolfe 的结论相当克制:对研究辅助或小型编程项目这类日常需求,普通人不会感受到特别大的提升,Opus 5.5 足够用。但如果是设计更好的游戏、找出长期无法定位的 bug、解决非常难的问题,或者做出实体硬件装置,这个模型非常适合。
换句话说,这是一次面向"难题"的跨越,而非面向所有人的升级。
相关推荐
Anthropic双版本登顶智能指数,API费降20%
Anthropic 发布 Fable 5.2 与 Mythos 5.2 双版本,同底座评测得分 65 登顶智能指数第一,API 调用费降 20%。同期 Google 新增两款第八代 TPU,Meta 推出主攻智能体重复任务的 Muse Ember,蚂蚁灵波开源触觉模型 Limbo Touch,Claude Code 被曝明文落盘敏感信息。
Claude Fable 5.2实测:1000智能体30小时证明费马大定理
Claude Fable 5.2与Mesos 5.2发布:1000个AI智能体30小时形式化证明费马大定理,价格降20%、速度提升30%,在电路设计、物理、化学、运筹与网络安全任务中展现长链条工程能力,同时被主动限制AI自我改进。
当AI遇上政治讽刺:Hegseth言论引爆的舆论风暴
一段YouTube政治讽刺节目引发热议,聚焦美国防长赫格塞斯过往关于女性参战的争议言论,以及其面临的性侵指控与母亲批评信。本文梳理事件核心争议与舆论反应。