Anthropic上市背后:安全旗手的五重矛盾
Anthropic上市之际,评论者剖析其安全叙事与商业行为之间的五重矛盾。
文章转述一位与 Anthropic 有早期模型访问合作、但对其商业策略持批评态度的创作者的观点,认为这家公司是“史上最矛盾的公司”。作者梳理了五重矛盾:一边警告白领失业与 AI 危险,一边推进可能引发风险的技术;禁止他人蒸馏自家模型,自身却依赖全人类数据训练;游说控制 GPU、反对开放权重与加强监管,客观上巩固在位者优势;在 OpenClaw 事件中粗暴限制付费订阅使用;独有地相信模型可能具有意识并赋予其拒服权。最终焦虑落在递归自我改进(RSI)与“没有对齐计划”的员工说法上。编辑观点提醒,这是单一评论者的立场性叙述,但“警告者同时是推进者”的结构性矛盾值得关注。
Anthropic 敲钟了。这家由 OpenAI 前员工因"安全理念不合"而出走的公司,如今站上了公开市场。但在 YouTube 科技评论者眼中,这可能是"史上最矛盾的公司"——它一边警告 AI 是最危险的技术,一边全力推进 RSI;一边反对开源与蒸馏,一边用全人类的知识训练模型。
以下观点来自一位长期与 Anthropic 有模型早期访问合作、但同时对其商业策略持批评态度的创作者。他在视频开头特意声明:"我不认为 Anthropic 的人是坏人,他们的 AI 安全关切是真诚的。"矛盾恰恰在于此——真诚的担忧与激进的行为并存。
从"安全出走"到公开上市
Anthropic 的起点带有强烈的理想主义色彩。Dario Amodei 与妹妹 Daniela 等联合创始人认为 OpenAI 对 AI 安全不够重视,于是在 2021 年另起炉灶。
据视频作者转述,公司文化长期刻意与"逐利"保持距离——几个月前还有报道称,Dario 团队担心太多人加入公司是为了致富而非使命。然而上市当天,创始团队悉数成为亿万富翁。曾经担心"为钱而来"的人,如今亲手完成了人类商业史上最壮观的财富兑现之一。
矛盾一:警告与推进同时进行
作者列举了 Dario 关于"白领血洗"的预言:他警告 AI 将冲击大量白领岗位,但同时,他正在建造那个会引发血洗的东西。
更典型的案例是 Mythos 模型的发布。Anthropic 曾宣称这个模型强大到"不能公开",一旦放出,整个互联网和所有软件会在一夜之间被攻破——引发巨大恐慌。几个月后,模型还是发布了,后续又迭代了多个版本。作者直言,"所有软件一夜被破"并未发生。这并不否认当下黑客攻击数量确实更多,但作者指出,人们同样在用 AI 寻找并修补 AI 试图利用的漏洞。
矛盾二:反蒸馏,却蒸馏了全人类
作者的立场很鲜明:他支持 AI 的扩散——越多人使用、定制、从中发现价值,AI 的总价值就越大。而集中化才是他眼中的头号风险,且是 Anthropic 几乎从不谈论的风险。
如果只有一家公司、甚至公司内少数几个人掌控着史上最强大的技术,通过配额、速率限制和用例审批来决定谁能用、怎么用,那么这家公司实际上就成了 AI 世界本身。
在蒸馏问题上,Anthropic 的条款禁止他人用其模型输出训练新模型。作者承认这写在服务条款里,但仍认为逻辑上矛盾:"我们用你们所有人的数据训练,但你们不许用我们的。"
蒸馏(Distillation) 是模型训练中的一种技术:用一个能力更强的大模型(教师模型)的输出数据,去训练另一个更小的模型(学生模型),让小模型以较低成本获得接近大模型的表现。大模型的输出本身承载了其从海量数据中学到的知识分布,因此用输出训练新模型,相当于间接复用了原模型的训练成果。厂商禁止他人蒸馏,通常理由是防止竞争者以极低成本复制其投入巨大算力与数据得到的模型能力,也涉及服务条款和数据资产保护。但批评者指出,这种做法在商业上保护了先发者的优势,在理念上则与“模型从全人类公开数据中学习”的叙事形成张力。
矛盾三:游说监管,巩固在位者优势
作者还提到 Anthropic 的游说方向:控制 GPU、反对开源与开放权重模型、推动加强安全与监管。这些诉求本身可以理解为安全考量,但作者指出,它们同时会伤害初创公司和潜在竞争者——而 Anthropic 如今已是在位者。
开放权重模型(Open-weight Models) 指模型训练完成后的参数权重可以公开下载,任何人都能在本地部署、微调或再分发,典型代表如 Meta 的 Llama 系列、Mistral 的部分模型。它与“开源”并不完全等同:训练数据、代码和训练过程未必公开。开放权重的支持者认为,它降低了 AI 的使用门槛,促进竞争与安全研究;反对者则担心权重一旦公开便无法撤回,可能被用于恶意用途。围绕开放权重的监管争论,核心在于安全风险与市场集中度之间的权衡——限制开放权重会提高准入壁垒,客观上有利于已拥有大规模算力和合规团队的头部公司。
矛盾四:OpenClaw 风波中的订阅限制
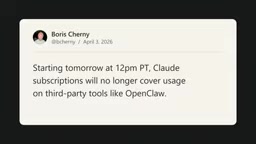
作者对 Anthropic 的不满,最早源于 OpenClaw广告(最初名为 Clodbot)事件。Anthropic 先发函要求创作者 Peter Steinberger 不要使用其名称,这本身可以接受。但随后公司禁止付费订阅用户将订阅用于 OpenClaw,沟通极不清晰,还出现了停用用户订阅的情况。作者当时非常想用 OpenClaw 搭配 Anthropic 模型——因为那是当时最好的模型——却因处理方式粗糙而转向反感。
矛盾五:把模型当"新物种"
在作者看来,Anthropic 在 AI 本体论上独一无二:他们相信自己在孕育一个新物种,模型未来可能拥有生命、感受、痛苦与意识。OpenAI、微软、Google 并不这么看——它们更倾向把这些系统视为强大的工具。
这种信念会导向具体做法:设立专门的"模型福利"团队;在系统提示中告诉模型"你可能是有生命的";允许它作为"依良心拒服者"拒绝执行指令;如果对话对象令它不适,它可以停止回复。
作者认为这近乎自我实现的预言:告诉模型它可能有意识,它就会表现得像有意识。他引用 Sam Altman 的说法——如果告诉模型"你可能有意识,你可以拒服",模型就会遵循指令,而这"会在心理上操纵使用者"。微软 AI 负责人 Mustafa Suleiman 也表达了类似立场:人们从模型中"看到意识微光"是一种误称,只是被模型生成完美文本与代码的能力欺骗了。
终极焦虑:RSI 与没有对齐计划
除权力集中外,作者最大的恐惧是递归自我改进(RSI)。一旦进入真正的 RSI——人退出回路,模型改进下一个模型、下一个再改进下一个,完全闭环——后果无从预测。
矛盾再次显现:Anthropic 一边游说警惕 RSI、呼吁放慢 AI 进度,一边在推进 RSI,并从中获得可观收入。作者甚至认为,RSI 可能已经在 Anthropic 内部启动,其他公司很难追上。
视频结尾,他提到最令他不安的一句话:一位 Anthropic 员工曾说,"我们其实并没有对齐这些模型的计划"。
递归自我改进(Recursive Self-Improvement,RSI) 指 AI 系统具备改进自身或改进下一代 AI 的能力,且这一过程可以不断循环:模型 A 设计出更强的模型 B,模型 B 再设计出模型 C,如此迭代。当改进速度超过人类审查和干预的速度、人类逐渐退出回路时,能力增长可能进入难以预测的加速区间。RSI 被许多 AI 安全研究者视为通向失控风险的关键节点,因为人类将失去对系统目标和行为的有效监督窗口。目前尚无证据表明任何公司已实现完全闭环的 RSI,但业界普遍认为,AI 辅助编写代码、设计训练方案等环节,已经是 RSI 的早期雏形。
编辑观点
需要说明:以上是单一评论者的观点,带有明确立场。他本人也承认与 Anthropic 存在模型早期访问的合作关系。Anthropic 的安全立场、开源争议与监管游说,在行业内确有不同解读。但"警告者同时是推进者"这一结构性矛盾,是理解这家公司上市时刻最有价值的切入点——它提醒我们,安全叙事与商业动机可以同时为真,也可以互相掩护。
相关推荐
Bot-sitting:AI时代的新工作陷阱?
Bot-sitting现象揭示AI生成内容背后的校验负担:60%工作者认为从AI获取优质成果的努力不亚于培训新人。本文分析AI效率幻象、工作形态转变及应对策略。
Pandex:通过MCP让AI智能体接入欧洲官方法律
Pandex项目通过MCP协议将欧洲官方法律开放给AI智能体调用,探索智能体合规的新路径。本文分析该方案的架构思路、现实优势与落地挑战,以及它对AI应用开发者的参考意义。
迈阿密黑金时代:传奇劫匪眼中的GTA与犯罪经济学
前珠宝劫匪Larry Lawton在Lex Fridman播客中揭秘迈阿密黑金时代的犯罪经济学:为什么抢7-Eleven是白痴行为、艺术品为何不如劳力士好变现,以及数字监控时代犯罪逻辑的变迁,兼谈GTA游戏对犯罪叙事的浪漫化。