Anthropic双旗舰Claude Fable 5.2与Mythos 5.2发布,编程与科学能力登顶

Anthropic 发布 Fable 5.2 与 Mythos 5.2 双旗舰,在编码、3D 与生命科学多项基准登顶。
Anthropic 一次性发布 Claude Fable 5.2 与 Claude Mythos 5.2 两款旗舰模型,前者主攻编码、计算机使用与 3D 交互,后者面向生命科学等科研任务,二者共同特点是表达更清晰、输出速度最高提升 30%。官方与第三方数据均表现强势:Frontier Code 2.0 从 32.4% 升至 49.1%,Artificial Analysis 智能指数 65 分登顶,3D 交互基准 1271 ELO 领先第二名 67 分且执行区间不与其他模型重叠。Mythos 5.2 在 34 个蛋白质衣壳中成功建模 28 个,并在 17 项生命科学评测中多项居首。GitHub Copilot 与 Cursor 发布当天同步接入,API 定价较竞品低约两成。文章认为这标志着「全能模型」路线让位于垂直深度竞争。
Anthropic 一次性放出两款旗舰模型——Claude Fable 5.2 和 Claude Mythos 5.2,官方定位是应对「最具挑战的技术任务」,在编码、推理和视觉能力上全面提升。据 B 站 UP 主 Ponyo News 的报道,两款模型已从发布当天起陆续开放,GitHub Copilot 和 Cursor 同步接入。
这并非一次常规的小版本迭代。从官方基准表到第三方评测,Anthropic 这次在多个硬指标上同时压过了此前的领跑者,甚至让 Fable 5.2 的执行区间与任何其他模型都不重叠——这是一个相当罕见的信号。
双旗舰分工:Fable 管技术,Mythos 管科学
Anthropic 给两款模型划了清晰的边界。Fable 5.2 主攻技术工作,重点覆盖编码、计算机使用和 3D 交互;Mythos 5.2 则面向科学任务,尤其是生命科学领域的复杂问题。
两款模型的共同点是「表达更清晰」——测试者反馈称,新模型在输出可读性和指令跟随上比以往版本明显更好。官方还提到,输出速度比上代快最多 30%。
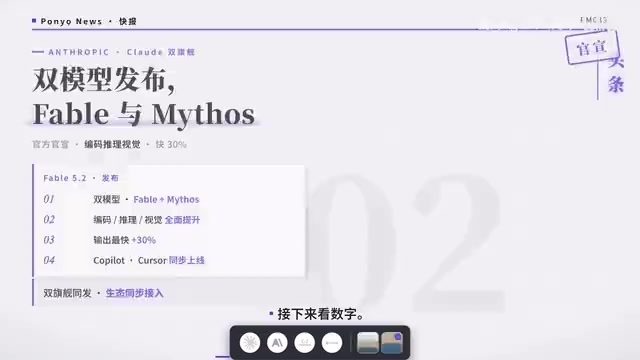
这种分工策略值得注意。过去一年,头部厂商倾向于用一个「全能模型」覆盖所有场景,但 Anthropic 选择了拆分产品线:技术任务追求极致的执行精度,科学任务追求领域深度。这背后可能是一种判断——通用能力的边际收益正在递减,垂直场景的深度优化才是下一阶段的竞争焦点。
硬指标全面登顶:编码、3D、多学科推理
先看官方基准数据。智能编码基准 Frontier Code 2.0 上,Fable 5.2 拿到 49.1%,上代 Fable 5.1 是 32.4%——提升幅度超过一半。计算机使用基准为 89.3%,机器人模拟基准 RoboDojo 为 64.9%。
多学科推理方面,「人类最后的考试」拿到 74.2%,蛋白质设计基准由 Mythos 5.2 拿到 85.1%。
第三方评测同样给出了高评价。Artificial Analysis 智能指数上,Fable 5.2 Max 以 65 分登顶,超过 OPUS 5.5 的 59 分和 GPT-6 Astra 的 57 分。定价方面,API 输入 8 美元、输出 40 美元每百万 Token,比 Astra 便宜约两成。
更具冲击力的是 AA 3D 交互式基准:Fable 5.2 拿到 1271 ELO 登顶,领先第二名 67 分,且执行区间不与任何模型重叠。这意味着在统计意义上,它的表现与竞争对手不在同一个水平线上。
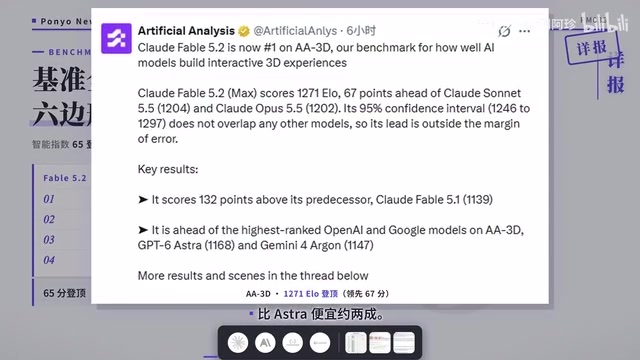
官方演示了多个一次生成的 3D 场景——太极灵、吞火龙、星际飞船发射回收,全部可直接在浏览器运行。这类能力对游戏开发、交互设计和仿真训练有直接的实用价值。
ELO 与「执行区间不重叠」的含义
ELO 是一种源自国际象棋的等级分体系,用于在成对比较(如模型两两对战、由人类或 AI 裁判投票选优)中量化相对强弱,分差越大表示胜率优势越明显。近年来 Chatbot Arena、AA 3D 交互式基准等评测普遍采用 ELO 排名,因此「1271 ELO」本身只反映相对位次,需要结合分差来理解。
所谓「执行区间不重叠」,指的是统计置信区间不重叠。第三方评测通常会对每个模型给出一个分数区间(例如基于多次采样或 bootstrap 估计),用以表达测量的不确定性。如果两个模型的区间重叠,就不能断言谁更强;而 Fable 5.2 的区间与任何其他模型都不相交,意味着在统计上可以较有把握地说它领先。这也是文中称其为「罕见信号」的原因——在大模型分数普遍逼近、差距收窄到噪声量级的当下,能拉开统计显著差距并不常见。
Mythos 5.2:把 AI 送进实验室
Mythos 5.2 的亮点集中在生物科学。基因治疗需要把药物装进蛋白质外壳(衣壳),Mythos 5.2 找到了预测整个衣壳结构的新方法:测试中 34 个衣壳成功建模 28 个。对研究者来说,这意味着设计衣壳系统可以更快、更便宜。
官方还给出 17 项生命科学评测,覆盖医药、化学、生物、影像分析和蛋白质设计,Mythos 5.2 在多项中拿到最高分。
机器人控制方面也有突破。官方演示中,Claude 自主拧开瓶盖,完成齿轮装配和镍合测试。RoboDojo 模拟基准 64.9%,超过一众专用系统,官方称即便在未专门训练的任务上也表现稳定。
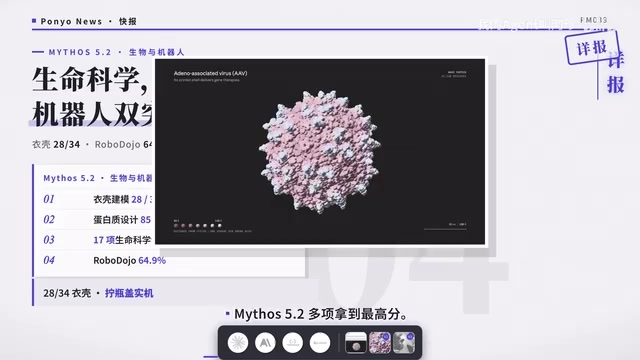
从「会写代码」到「会操作物理世界」,这条路径正在被逐步打通。拧瓶盖看似简单,但涉及视觉识别、力控和动作规划的协同,是具身智能的典型难题。
蛋白质衣壳与结构预测
衣壳(capsid)是包裹病毒遗传物质的蛋白质外壳,在基因治疗中被改造为「递送容器」——把治疗性基因装进去,安全送达目标细胞。常用的腺相关病毒(AAV)载体就是靠工程化衣壳实现靶向递送,因此设计出稳定、可组装、不易被免疫系统清除的衣壳是基因治疗的关键工程环节。
传统上确定衣壳结构依赖冷冻电镜等实验手段,周期长、成本高。计算结构预测(AlphaFold 开辟的路线)则试图从氨基酸序列直接推断三维结构。文中「34 个衣壳成功建模 28 个」的意义在于:模型能对整组装配体而非单一蛋白链给出可信结构,从而把设计—验证的循环从实验台部分转移到计算端,显著压缩研发时间与费用。不过需要注意,结构预测成功不等于功能验证成功,后续仍需湿实验确认。
生态同步:Copilot 与 Cursor 第一时间接入
对开发者而言,模型能力的价值最终取决于能否用上。GitHub 宣布 Fable 5.2 全面登陆 Copilot,早期测试显示用更少步骤完成更多任务;Cursor 同步上线,CursorBench 最大档 60% 登顶,默认档 56.9%,上代 Fable 5.1 是 49.2%。
这意味着发布当天,主流 AI 编程工具就已经能调用新模型,开发者无需等待适配周期。
CursorBench 与编程评测的局限
CursorBench 是 Cursor 团队自建的编程能力评测集,通常基于真实用户交互中的编辑、多文件重构、Agent 式任务等场景构造,比起纯算法题更贴近日常开发。文中「最大档 60%、默认档 56.9%」指的是在不同推理预算或模型配置档位下的得分。
需要注意,厂商自建基准存在天然的利益关联,且编程任务的评测对脚手架(提示词、工具链、上下文管理)高度敏感,同一模型在不同 harness 下分数可能相差可观。因此文中的 CursorBench 数字应与其他第三方评测交叉参照。对于开发者,更实用的判断依据往往是自身代码库上的实际试用,而不是榜单排名。
同日快讯:美团、Meta 的开源动作
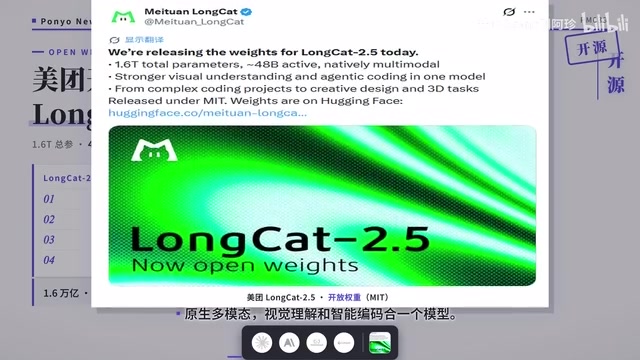
同一天还有几条值得注意的消息。美团发布 LongCat 2.5,开发总参数 1.6 万亿,激活约 480 亿,原生多模态,把视觉理解和智能编码合入一个模型,覆盖从复杂编码项目到创意设计再到 3D 任务,以 MIT 协议开源权重并上线 Hugging Face。
Meta 发布了迄今最小的模型 Muse Ember,按 Artificial Analysis Coding 智能指数为 36,接近自家最大模型 Spark 1.3 的 37 分,而价格只有大约 1/17。这个数据说明小模型的性价比正在快速逼近大模型,对成本敏感的部署场景有直接意义。
另外,华尔街日报报道 Anthropic 计划在本月晚些时候推进首次公开募股,尽管近期 AI 投资市场出现波动。这将是该公司首次走向公开市场。
总参数、激活参数与 MoE
文中「开发总参数 1.6 万亿,激活约 480 亿」描述的是混合专家(MoE)架构。这类模型内部由大量「专家」子网络组成,每次前向计算时只路由激活其中一小部分,因此总参数量决定容量上限,激活参数量决定单次推理的计算成本与显存开销。1.6 万亿总参数配 480 亿激活,意味着模型拥有极大的知识容量,但每次调用只消耗接近中等规模稠密模型的算力——这正是当前大模型在性能与成本之间取得平衡的主流做法。
另外,MIT 协议是较为宽松的开源许可,允许商用、修改与再分发,仅需保留版权声明,对企业集成相对友好;权重上线 Hugging Face 则意味着可直接下载自部署,绕开 API 依赖。
小结
Anthropic 这次的双旗舰策略,把「技术执行」和「科学发现」拆成两条产品线,并在编码、3D 和生命科学三个方向同时拿出领先数据。对开发者来说,最直接的变化是 Copilot 和 Cursor 已经能用上新模型;对行业来说,更值得关注的是模型分工的趋势——当通用能力逐渐趋同,垂直深度可能才是下一轮竞争的胜负手。
相关推荐
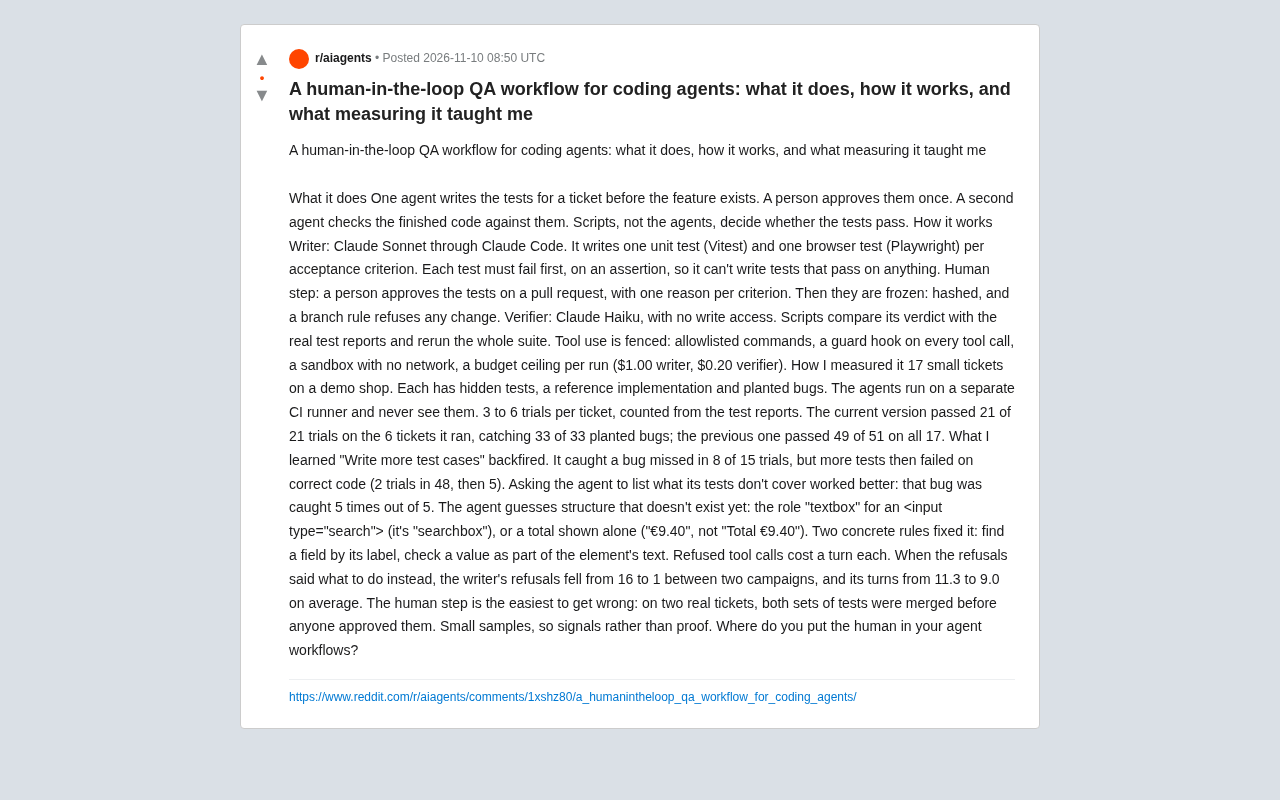
人类在环QA工作流:为编码智能体加上测试门禁
Reddit开发者分享编码智能体的人类在环QA工作流:智能体先写测试、人工审批冻结、脚本裁决结果。实测17个工单,发现多写测试反而增加误报,让智能体列出未覆盖范围更有效。
MiniMax开源H3-Image:基于H3的开放权重图像模型
MiniMax发布开放权重图像模型H3-Image,基于H3视频模型构建。社区关注其图像编辑能力、文生图质量及32B文本编码器带来的部署负担,有望与Qwen Image 2.1等模型展开竞争。
Claude Fable 5.2 与 Mythos 5.2 发布:同款模型的双重安全策略
Anthropic 发布 Claude Fable 5.2 与 Mythos 5.2,同一底层模型搭配不同安全防护等级。Fable 5.2 在 FrontierCode 2.0 得分 49.1%,输入输出定价每百万 token 8/40 美元,支持 100 万 token 上下文窗口。