AssemblyAI自研客服Joey:解决率从10%飙升至80%

AssemblyAI用自研AI客服Joey将客服解决率从10%提升至80%,月成本仅700美元。
AssemblyAI面临每天1000次API注册却只有1名接入工程师的严峻供需失衡,现成客服机器人因缺乏可控性仅能解决10%的对话。团队决定基于Claude Agent SDK自研AI客服Joey,构建了本地Markdown文档、Voyage embedding检索、3万行Claude.md行为规范与Railway自动部署四层架构。上线第一周,Joey将端到端解决率提升至80%,月成本约700美元,且100%入站工单均先经Joey处理,仅20%真正复杂情况才转交人工。团队还用自家Voice Agent API为Joey加上语音能力,实现边演示边体验产品的「元认知」效果,并将FDE的核心方法论归结为:持续dogfooding自家产品,把自己从瓶颈中自动化出去。
当每天1000次注册只有1名工程师支撑
AssemblyAI 是一家专注于语音 AI 基础设施的公司,自研语音转文本(Speech-to-Text)基础模型,并逐步扩展到完整的语音智能体(Voice Agent)技术栈。如果你的会议里出现过 Fireflies 这类记录助手,或者你拨打过某些企业的电话客服、使用过快餐店的语音点餐系统,背后很可能就运行着 AssemblyAI 的模型。
在 AI Engineer 大会上,AssemblyAI 的前沿部署工程师(Forward-Deployed Engineer, FDE)Matt Lawler 分享了一个颇具现实冲击力的数字:公司目前每天收到约 1000 次 API 注册,而直到他演讲前两天,整个团队只有他一个人负责新用户的技术接入(onboarding)。
这种供需失衡几乎是所有语音 AI 公司都在面对的现实。FDE 的职责是深度嵌入客户业务——直接向客户代码库提交代码、每周甚至每天和客户开会、理解他们的具体用例。这是一种高价值的服务模式,但问题也很直接:一个人无法以一对多的方式服务上千名客户。继续靠招聘更多 FDE 来扩张,既不经济也不现实。
Matt 提出了一个值得所有 FDE 深思的观点:你每天的工作目标,应该是把自己自动化掉。如果你想更好地服务客户、提供可规模化的优质体验,就不能让自己成为那个瓶颈。
现成客服机器人为何只能解决10%
面对汹涌的咨询量,AssemblyAI 最初的做法和大多数团队一样——直接采购一个现成的客服机器人,把它指向文档,期待它能自动回答所有基础问题。
结果令人失望:这个开箱即用的机器人只解决了约 10% 的对话。按每天 1000 个会话计算,机器人处理了 100 个,团队仍要人工应对剩下的 900 个工单。10% 的端到端解决率远远不够。
更致命的是迭代速度问题。团队无法访问系统提示词(system prompt)、无法接触工具调用逻辑、也拿不到 RAG 检索基础设施。每次想调整些什么,供应商的回复都是「这个功能在路线图上」。对于一家需要快速响应客户的公司来说,这种受制于人的被动局面无法接受。
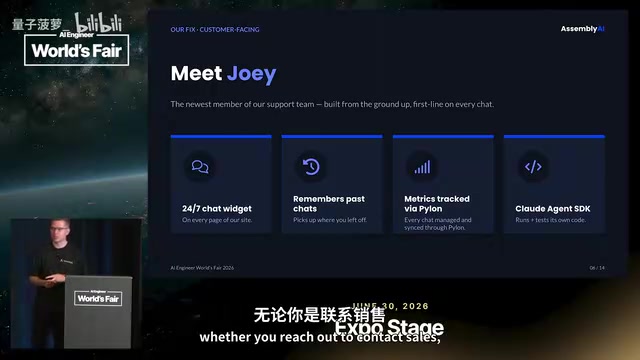
于是团队做出决定:与其招一个新成员,不如造一个新成员——他们给这个 AI 客服起名叫 Joey。现在无论你是通过官网的聊天窗口、联系销售,还是发邮件到支持邮箱,第一个接待你的都是 Joey 而非真人。
Joey的四层架构:把AI当成真正的FDE来造
Joey 构建在 Claude Agent SDK 之上,这让它的能力远超普通聊天机器人:它能管理自己的基础设施、拥有文件系统、可以编写和调试代码、调用工具,甚至给自己赋予新能力。换句话说,它的运作方式更像一名真正的 FDE,而不是网站右下角那种标准问答机器人。它还能记住与你过往的对话,并通过 Pylon 追踪所有指标——因为它本就被当作支持团队的一员来管理。
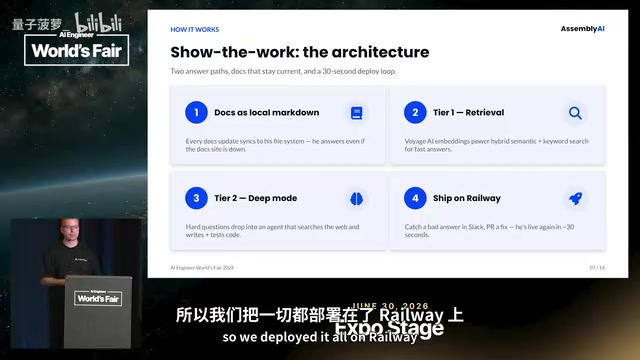
整个架构可以拆成四个核心部分:
文档本地化:Markdown 是 Claude 的好朋友
团队把所有官方文档以本地 Markdown 文件的形式交给 Joey。每当文档系统更新,这些文件会同步到 Joey 的本地文件系统中。一个意外的好处是——即使整个文档站点宕机,Joey 依然能基于本地文件给出最新功能的准确答案,无需人工介入。
检索增强:与 Voyage 合作做 Embedding
为了更快给出准确回答,团队采用 Voyage 的 embedding,让 Joey 优先获取最相关的文档,减少搜索耗时。当它遇到困惑或需要串联多份资料时,还能以 agentic 的方式在文件系统中深度检索,进入一种「深度思考模式」。
RAG(检索增强生成,Retrieval-Augmented Generation)是一种将外部知识库与大语言模型结合的架构模式:先用 embedding 模型将文档块转化为向量,存入向量数据库;当用户提问时,将问题同样向量化,检索最相似的文档片段,再将这些片段拼入 LLM 的上下文中生成回答。Voyage 是一家专注于 embedding 模型的公司,其模型在代码、技术文档等专业领域的语义相似度检索上表现优于通用 embedding 模型。Joey 使用 Voyage 而非 OpenAI 或开源 embedding,是为了在大量 API 文档和 changelog 中获得更高的检索精度,减少模型因拿到无关文档片段而产生的幻觉回答。
行为规范:3万行的 Claude.md
所有网站主要页面——changelog、定价、功能介绍——都被转换成 Markdown,并保留 URL,这样 Joey 可以给客户标注引用来源以便核实。更关键的是一份约 3 万行的 Claude.md 指令文件,包含了所有护栏规则和与客户沟通的建议。每当发现 Joey 给出错误回答,团队就更新这份文件,之后所有对话都会随之改进。
Claude.md 是 Anthropic 为其 AI 编程助手 Claude Code 设计的一种约定俗成的配置文件格式,本质上是放置在项目根目录的 Markdown 文件,Claude 在处理该项目时会优先读取其中的指令作为「上下文规则」。团队将这一机制引申到 Joey 的运行环境中,把所有业务护栏、沟通风格要求、禁止行为和产品知识写入这份文件。3 万行的体量意味着它已远超简单系统提示词的范畴,更接近一本持续迭代的「员工手册」——每次发现 Joey 的回答偏差,只需修改这份文件,无需重新训练或重新部署模型,所有后续对话立即受益。这种「提示词即配置」的方式,是目前快速迭代 AI 智能体行为最轻量级的工程实践之一。
部署:Railway 实现 30 秒上线
团队不想折腾 EC2、不想管理实例类型,于是整套系统用 Docker 容器化后部署在 Railway 上。每次向仓库推送更新,新版本会在约 30 秒内自动上线,无需人工监控部署。他们甚至有过这样的经历:实时监控一场对话时发现 Bug,立刻写 PR 部署修复,当前会话随即生效,而客户完全不知道背后刚刚发生过一次热更新。
Claude Agent SDK(即 Anthropic 推出的 Claude Agents 框架)是一套面向开发者的编排层,允许 Claude 模型以「智能体」模式运行:它不只是被动地回答问题,而是能主动规划步骤、调用外部工具(如文件系统读写、代码执行、API 调用)、在多轮循环中根据中间结果调整行动。与单次补全(completion)调用相比,Agent 模式赋予模型更长的「上下文窗口内行动链」,使其能自主拆解复杂任务并逐步完成。这也是 Joey 能够深度检索文档、自主调试代码甚至给自己添加新能力的底层原因——它运行的不是一次问答,而是一段持续推理与行动的循环流程。
从10%到80%:一周见效,月成本仅700美元
结果相当惊人。仅凭一个「相当朴素」的初版实现,Joey 在部署后的第一周就把端到端解决率从 10% 提升到了 80%,而全部成本(token 加推理/基础设施)每月仅约 700 美元。
Matt 特别强调这个 80% 没有被「做数据」。有些团队会说「我们解决了 80%」,但其实只针对某一类工单。Joey 的情况不同:用户无法直接联系到人类,除非主动要求 Joey 升级(escalate)。也就是说,它实实在在地处理了 100% 的入站工单,只把其中 20% 真正需要人工的情况转交出去——比如费率变更、数据退出请求、签署协议,或是需要法务介入的事项。
更妙的是,Joey 无法处理的事项,恰好构成了团队下一步要补齐的清晰清单。不能发送 BAA(商业伙伴协议)?那就给它一个可引用的链接。不能谈价格?现在你去官网测试,告诉它你需要多少小时,它真的会报价,而且你可以和 Joey 讨价还价。
Dogfooding:用自家API给Joey装上「嘴」
Matt 想通过 Joey 验证的另一件事,是吃自己的狗粮(dogfooding)。AssemblyAI 做的是语音业务,客户用它构建语音智能体,那客服机器人自然也该是个语音智能体。
团队用自家的 Voice Agent API 给 Joey 加上了语音能力。现在进入官网切换到语音模式,就能直接和 Joey 对话。整套方案是「语音进、语音出」,通过单个 WebSocket 连接把语音转文本、LLM 和文本转语音串联起来,全部针对语音场景优化——实时低延迟,自动处理停顿、打断、插话(barge-in)等问题,并自带语音,无需额外接入其他供应商。演讲现场的演示里,Joey 流畅应对了一个关于「构建医疗场景听写工具是否需要先签 BAA」的真实提问,并准确说明签署 BAA 会自动退出模型训练。
这里有一层精妙的「元体验」:客户在和 Joey 讨论如何构建语音智能体 API 的同时,本身就在使用这个 API,直接感受到了产品体验的样子。团队还计划本周给 Joey 接入电话号码,让客户能随时拨打获取实时支持。
WebSocket 是一种基于 TCP 的双向持久连接协议,与传统 HTTP 请求-响应模式不同,它允许服务端和客户端在单次握手后持续互发消息,无需反复建立连接。在语音智能体场景中,这一特性至关重要:语音数据需要以音频流的形式实时传输,ASR(自动语音识别)模块边接收边转录,LLM 边接收文本边生成回复,TTS(文本转语音)边接收回复边合成音频——三个环节形成流式级联,整体延迟可压缩到人类可接受的对话范围(通常低于 500 毫秒)。AssemblyAI 将这整条链路封装在单个 WebSocket 连接内,省去了开发者自行拼接多个供应商 API、处理流式对齐问题的工程成本。
给FDE的一句话:别等客户求助,自己先把产品造一遍
Matt 最后把这次分享的核心落在了一个方法论上:FDE 必须持续吃自家狗粮。教客户上手远远不够,每推出一个新功能、新产品,你都应该亲手用它、构建它、发布它,然后用从中积累的全部认知去指导客户。
他坦言,为了给 Joey 做语音能力,自己也踩遍了所有的坑——延迟、轮流发言、打断处理。正因为用的是和客户完全相同的那套 API,他现在能给出更有共情、更可靠的建议。
「去造点东西,」他说,「如果你是 FDE,就去构建你客户正在构建的那个产品,别只是等着替他们扫清障碍。在这个过程里,你很可能同时让客户体验变得更好。」
相关推荐
Obsidian接入AI:开源四层骨架与四大技能
B站UP主鲸鱼大小姐开源一套Obsidian接入AI的四层骨架与四个技能,包含日常整理、截止时间、刷题、课件转换,全部开源,纪律严格,边界清晰。
本地AI为何难普及?算笔账就明白了
本地AI为何难普及?科技博主用详实数据算了一笔账:高端GPU硬件成本远超ChatGPT订阅费,速度与并行能力受限,本地AI目前只适合技术爱好者。文章同时探讨了操作系统混合AI与本地路由的未来路径。
AI模拟数千个台风季,重塑热带气旋风险评估
AXA与NVIDIA Earth-2利用AI生成超过一千个模拟气旋赛季,突破46年历史数据的稀疏局限,为热带气旋风险评估和保险定价提供更丰富的概率视角。