AuDiR:用规则与感知干预诊断音频推理失败根源

AuDiR 用受控干预实验将音频推理失败拆分为感知、知识与应用三类,揭示准确率掩盖的真实瓶颈。
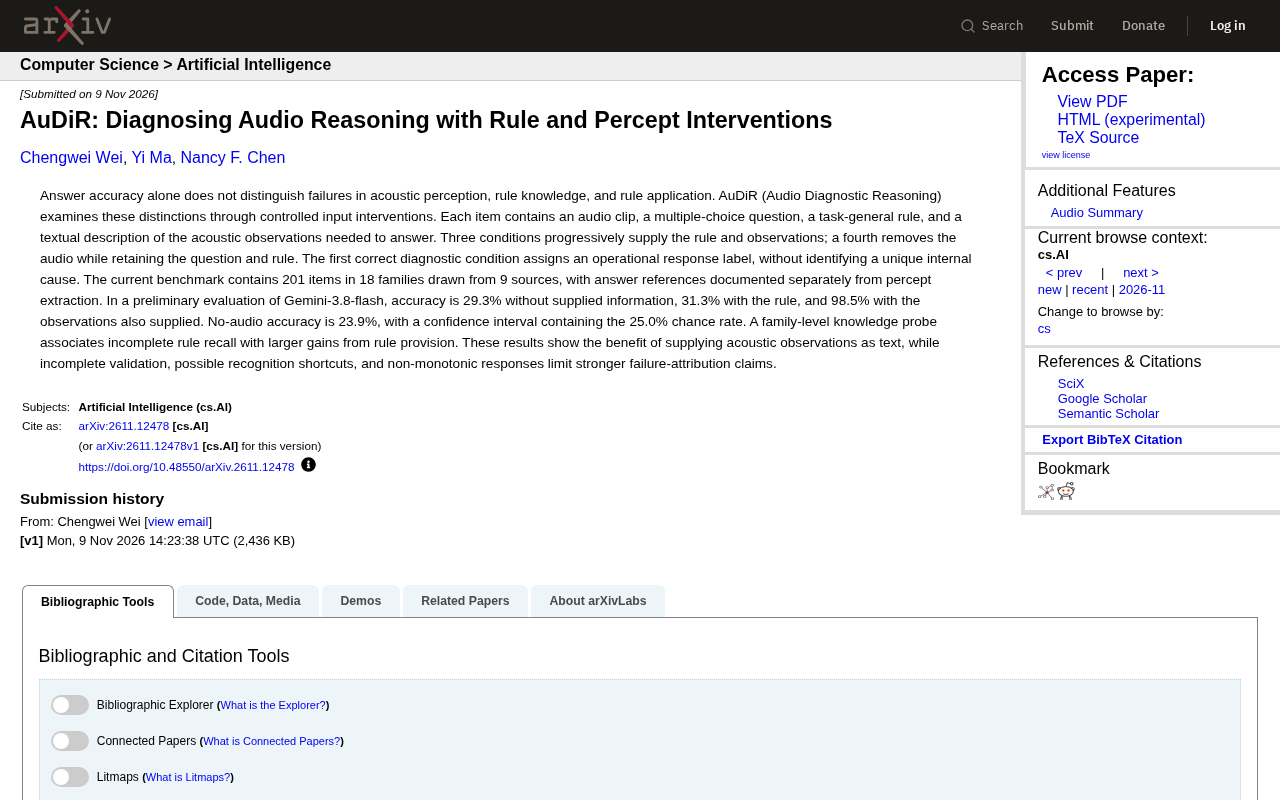
AuDiR 提出一套基于受控输入干预的诊断框架,旨在把音频推理模型的失败模式拆分为感知失败、规则知识缺失和规则应用失败,而非仅凭最终准确率一概而论。每个测试项包含音频、多项选择题、任务通用规则和声学观察描述,通过逐步提供规则与观察文本设置渐进条件,并额外设置移除音频的对照条件,以模型首次答对的阶段作为操作性响应标签。在 Gemini-3.8-flash 上的初步评估显示,无辅助信息准确率 29.3%,提供规则后仅升至 31.3%,而提供声学观察文本后跃升至 98.5%,表明感知瓶颈远比规则知识瓶颈突出;无音频条件下准确率 23.9%,置信区间覆盖 25.0% 随机水平,说明模型无法仅凭规则和问题推断答案。家族级知识探针进一步发现规则回忆不完整与规则提供收益更大相关。作者也坦承验证不完整、可能存在识别捷径及非单调响应等局限,限制更强因果归因。
为什么音频推理的准确率会掩盖真实问题
音频推理任务中,模型给出错误答案的原因可能千差万别:可能是没听清声音(感知失败),可能是不知道相关规则(知识缺失),也可能是知道规则但不会用(应用失败)。仅凭最终准确率,这些失败模式被混为一谈,开发者难以针对性改进模型。AuDiR(Audio Diagnostic Reasoning)提出了一种基于受控输入干预的诊断框架,试图将这三类失败分离开来。
AuDiR 如何设计干预实验
AuDiR 的每个测试项包含四部分:一段音频、一道多项选择题、一条任务通用规则,以及一段描述回答问题所需声学观察的文本。通过逐步提供规则和观察描述,实验设置了三种渐进条件,外加一种移除音频但保留问题和规则的条件。模型在哪种条件下首次答对,就被赋予一个操作性的响应标签。
这种设计的关键在于“控制变量”:如果模型在获得规则后立即答对,说明失败可能源于规则知识缺失;如果模型在获得声学观察文本后才答对,则失败更可能出在感知环节。需要注意的是,该标签仅描述操作层面的响应模式,并不等同于识别出唯一的内部因果机制。
目前 AuDiR 基准包含 201 个项目、18 个家族,来自 9 个来源,答案参考与感知提取分别记录。
多项选择题与随机猜测基线
文中提到的 25.0% 随机猜测水平,对应的是四选一的多项选择题形式。在评测中,随机猜测基线是一个重要的参照点:如果一个模型在缺乏关键输入(如音频)时的准确率与随机猜测无显著差异,就说明它没有从剩余信息中获得有效线索,只能靠瞎蒙。反之,若显著高于随机水平,则提示模型可能利用了某些捷径或先验偏差。因此在解读 AuDiR 的无音频条件结果时,置信区间是否覆盖 25.0% 是判断模型能否“脑补”答案的关键统计依据。
置信区间与统计显著性
置信区间用于表达估计值的不确定性范围。当样本量有限(如 201 个项目)时,单点准确率可能因抽样波动而偏离真实水平。AuDiR 报告中指出无音频条件准确率 23.9% 的置信区间包含 25.0%,意思是这一结果在统计上与随机猜测无法区分,不能断言模型具备超越猜测的推理能力。这类区间估计比单纯的点估计更能支撑“音频输入必要”的结论,也提醒读者在比较不同条件的准确率差异时,需考虑误差范围而非只看数字大小。
初步评估:Gemini-3.8-flash 的表现
在 Gemini-3.8-flash 上的初步评估显示,不提供任何辅助信息时准确率为 29.3%;提供规则后升至 31.3%;同时提供声学观察文本后达到 98.5%。移除音频但保留问题和规则时,准确率为 23.9%,其置信区间包含 25.0% 的随机猜测水平。
这组数据传递了两个信号。其一,将声学观察以文本形式提供给模型,带来的提升远超仅提供规则——说明对该模型而言,感知瓶颈比规则知识瓶颈更突出。其二,无音频条件下的准确率与随机猜测无异,表明模型无法仅凭问题和规则“脑补”出正确答案,侧面验证了音频输入的必要性。
知识探针与规则提供收益的关联
AuDiR 还设计了一个家族级知识探针,发现规则回忆不完整与规则提供带来的更大收益之间存在关联。换句话说,模型对某类规则掌握得越差,给它补充规则后的提升就越明显。这一关联为诊断框架提供了额外的一致性证据,但作者也指出这只是家族层面的统计关联,不能直接推断个体项目的因果路径。
家族级(family-level)分析的含义
AuDiR 基准将测试项按“家族”分组,同一家族内的项目共享相似的任务规则或声学现象。家族级知识探针是在这一聚合层面上评估模型对某类规则的掌握程度,而非逐题考察。这种设计的优势在于降低单题噪声、提升统计稳定性,但也带来生态学谬误的风险:家族层面的关联(规则回忆越差、补规则收益越大)不能直接推广到个体项目,因为个体差异可能被聚合平均掩盖。作者明确区分这两个层面,正是为了避免过度解读因果。
识别捷径(shortcut learning)
识别捷径指模型并非真正执行任务所需的推理,而是利用数据或题目中的表面线索(如选项长度、关键词共现、答案位置分布)做出正确判断。在音频推理中,模型可能通过文本题干与选项的语义匹配“猜”出答案,而完全忽略音频内容。这类捷径会在准确率上制造虚假繁荣,使评测结果高估模型的真实能力。AuDiR 通过移除音频的条件来探测此类行为,但作者也承认捷径可能以更隐蔽的方式存在,需结合更多控制实验才能排除。
局限与未解决的问题
AuDiR 的作者坦承当前工作存在若干限制。验证尚不完整;模型可能利用识别捷径而非真正进行声学推理;响应模式存在非单调现象,即提供更多信息后准确率未必单调上升。这些因素限制了更强失败归因结论的可靠性。
从方法论角度看,AuDiR 的价值不在于给出“模型为什么错”的终极答案,而在于提供了一套可操作、可复现的诊断流程,让音频推理的失败分析从单一准确率走向多维归因。后续工作需要更充分的验证来支撑更强的因果主张。
对音频推理评测的启示
AuDiR 提醒我们,音频推理模型的评测不应止步于准确率榜单。通过规则与感知的干预实验,研究者可以更细粒度地定位模型短板:是听不清、不知道,还是不会用。这种诊断思路对于构建更可靠的音频理解系统具有参考意义,也为后续基准设计提供了可借鉴的范式。
相关推荐
Starlink Mini 2 发布:便携卫星上网再进化
Starlink Mini 2 在 Hacker News 引发热议,帖子获 285 点、291 条评论。本文梳理便携卫星终端的迭代方向、社区讨论焦点及实际使用场景。
PewDiePie自搜趣谈:退休、自研AI模型Ajax与Linux日常
PewDiePie发布自搜视频,回应退休传闻,透露自研AI模型Ajax已达60 tokens/s、仍处BF16训练阶段,并分享Arch Linux日常、OpenAI封禁经历与对YouTube生态的疲惫感。
PewDiePie自曝失败:两年喂乌鸦计划为何翻车?
PewDiePie分享两年失败经历:试图与日本乌鸦交朋友,从喂花生到拯救倒吊乌鸦,最终被一位日本爸爸“抢走”荣耀。视频展现了与野生动物互动的真实挑战,以及创作者坦诚失败的一面。