AVID:首个5T fMRI听觉诱导视觉想象解码基准数据集

AVID发布首个听觉诱导VMI解码的5.0T fMRI训练级数据集,并给出解耦评估协议。
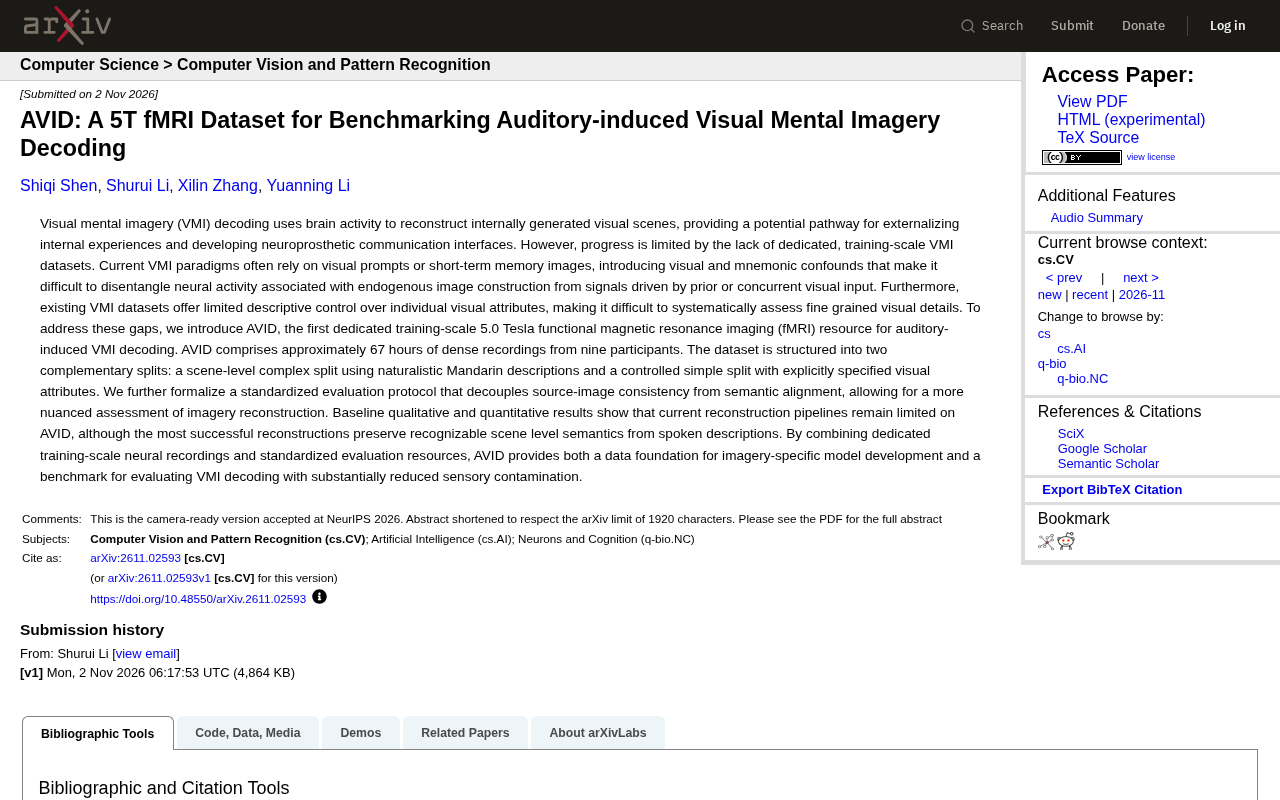
AVID针对视觉心理想象(VMI)解码缺乏专用训练级数据集的问题,构建了约67小时、来自九名参与者的5.0特斯拉fMRI数据集。它用听觉描述而非视觉提示诱导想象,以减少视觉和记忆混杂因素,并分为自然主义场景级子集与明确指定视觉属性的受控子集,兼顾生态效度与可控性。论文还提出标准化评估协议,将源图像一致性与语义对齐解耦,以便细致判断模型学到的是像素细节还是场景语义。基线显示重建仍有限,但能保留可识别的场景级语义。
视觉心理想象(Visual Mental Imagery, VMI)解码试图从大脑活动中重建内部生成的视觉场景,为外化内在体验和开发神经假体通讯接口提供了潜在路径。然而,这一领域长期受限于缺乏专用的、达到训练规模的数据集。现有范式多依赖视觉提示或短期记忆图像,引入了视觉与记忆的混杂因素,使得研究者难以区分内源性图像构建相关的神经活动与由先前或并发视觉输入驱动的信号。此外,现有数据集对个体视觉属性的描述控制有限,难以系统评估细粒度视觉细节。
为什么需要专门的VMI数据集
VMI解码的核心挑战在于如何将“内部生成”的视觉体验与外部感官输入分开。如果被试在想象时眼前仍有视觉提示,或者需要依赖短期记忆维持图像,那么记录到的脑活动就不可避免地带上了视觉编码和记忆维持的成分。这会让解码模型学到捷径,而非真正捕捉想象构建的神经机制。
AVID的出发点正是消除这种感官污染。它采用听觉描述诱导想象,而非视觉提示,从源头上减少了视觉输入对脑信号的干扰。同时,数据集在规模上达到了训练级——约67小时的密集记录来自九名参与者,这在VMI研究中属于显著的资源投入。
视觉心理想象(VMI) 指在没有外部视觉输入的情况下,在“心灵之眼”中主动构建视觉场景的认知过程,它区别于被动回忆刚刚看过的图像(那样会引入短期记忆成分)。VMI依赖顶叶、枕叶等皮层的自上而下激活,与真实视觉共享部分神经表征,因此诱发的脑活动很容易与视觉编码信号混淆。这正是AVID强调“听觉诱导、无视觉提示”的原因:只有排除外部视觉输入,才能更纯粹地分离内源性想象构建的信号。
数据集结构与设计
AVID被组织为两个互补的子集,分别对应不同的研究需求。
场景级复杂子集
该子集使用自然主义的普通话描述来诱导想象。被试听到一段对场景的口语描述后,在脑中构建相应的视觉画面。这种设计更接近真实世界中想象发生的场景——我们通常通过语言或内部独白来触发想象,而非盯着图片看。
受控简单子集
另一个子集则明确指定视觉属性,对想象内容进行更精细的描述控制。这使得研究者可以系统地考察颜色、形状、空间布局等具体视觉维度在解码中的表现,而不必担心自然场景中多个属性纠缠在一起。
这种“自然+受控”的双轨结构,兼顾了生态效度和实验可控性,是AVID在数据设计上的一个务实取舍。
标准化评估协议
仅有数据还不够。VMI解码领域此前缺乏统一的评估标准,不同研究之间的结果难以直接比较。AVID提出了一个标准化评估协议,将源图像一致性(source-image consistency)与语义对齐(semantic alignment)解耦。
这一区分的意义在于:重建结果可能在像素层面与原始图像并不吻合,但在语义层面正确捕捉了描述中的场景内容。把两者分开评估,能更细致地判断模型究竟学到了什么——是逐像素的视觉细节,还是场景级的语义结构。对于听觉诱导想象这种本身就不存在唯一“正确图像”的任务而言,这种评估思路尤其合理。
源图像一致性(source-image consistency) 衡量重建图像与原始目标图像在像素或低层特征上的吻合度,例如结构相似性或相关距离;语义对齐(semantic alignment) 则衡量重建结果与描述内容在类别、物体或场景语义上的一致程度,常用预训练视觉模型的嵌入相似度或分类准确率来量化。在VMI任务中,每个人想象出的画面并不唯一,像素级对比过于严苛,而语义对齐能反映模型是否捕捉到了“想象了什么”,两者解耦评估因而更贴合任务本质。
基线结果揭示了什么
论文报告的基线与定量结果表明,当前的重建流程在AVID上仍然表现有限。不过,最成功的重建能够保留来自口语描述的、可识别的场景级语义。
这一结果传递了两个信息。一方面,听觉诱导的VMI解码在语义层面是可行的,这为后续模型开发提供了基本信心。另一方面,细粒度视觉细节的重建仍然是开放难题,现有流程离实用化的神经假体通讯接口还有明显距离。AVID的价值恰在于提供了一个能暴露这些短板的基准,而非只展示成功案例。
对领域的影响
AVID的贡献可以归纳为三个层面。数据层面,它提供了首个面向听觉诱导VMI解码的5.0特斯拉fMRI训练级资源,填补了专用数据集的空白。方法层面,双轨子集设计为不同研究问题提供了可选择的实验条件。评估层面,解耦的一致性/语义协议为跨研究比较建立了共同语言。
对于从事神经解码、脑机接口和多模态表征学习的研究者而言,AVID既是一个可直接使用的数据基础,也是一个用于检验模型是否真正学到“想象”而非“视觉输入”的测试平台。随着更多模型在该基准上迭代,VMI解码从语义级走向细节级的时间表,或许会变得更为清晰。
相关推荐

神经网络本质是线性回归?华为300集AI课讲师用TensorFlow Playground讲透深度学习
华为300集AI深度学习教程中,讲师用TensorFlow Playground演示神经网络本质是线性回归,讲透机器学习与深度学习在特征工程上的核心差异,以及2012年大数据时代为何成为深度学习崛起的分水岭。

WorkBuddy做AI漫剧全流程:8步从零到成片
基于B站教程梳理WorkBuddy制作AI漫剧的完整八步流程:从选题策划、剧本分镜到图片资产、视频生成、配音剪辑与导出发布,并解析WorkBuddy的专家技能机制与逐个召唤专家的实操技巧,适合零基础入门。

Codex实战教程:从安装到多智能体协同
基于B站Codex实战教程,系统梳理Codex从安装配置、CLI交互、斜杠指令、AGENTS.md架构到MCP协议、多智能体协同与企业级插件开发的完整路径,帮助开发者理解AI Agent的工程化用法。