Azure SQL Hyperscale基准测试:吞吐量领先52%,性价比高51%

独立测试显示Azure SQL Hyperscale吞吐量比Aurora高52%,每美元性能领先51%。
微软委托Principled Technology对Azure SQL Database Hyperscale与Amazon Aurora进行独立基准测试,采用HammerDB模拟电商订单处理系统,在16 vCore配置及64、96、128并发用户下对比。结果显示Hyperscale原始吞吐量比Aurora高约52%,每美元订单处理性能领先约51%。微软代表Ravi强调,Hyperscale适用范围广泛,支持亚核级、无服务器模式及弹性数据库池,存储可从几MB扩展至至少128 TB。该基准为云数据库选型提供量化参考,但实际表现仍需结合具体工作负载验证。
微软委托独立厂商Principled Technology对Azure SQL Database Hyperscale与Amazon Aurora进行了对比基准测试,结果在Data Exposed节目中由SQL产品团队Ravi与主持人Anna Hoffman共同揭晓。测试显示,Hyperscale在原始吞吐量上比Aurora高出近52%,在每美元订单处理性能上也领先51%。这一结果对正在选型云数据库的企业具有参考价值。
基准测试如何设计
据Ravi介绍,本次测试采用HammerDB模拟电商订单处理系统,在高并发场景下测量数据库能处理多少订单。测试方选择了16 vCore的Hyperscale实例,并匹配Aurora上规格相近的实例(Principled Technology选用了其内部认为对等的配置),以确保对比的公平性。
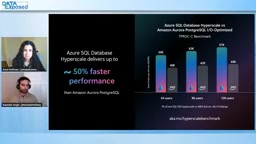
测试覆盖了多档并发用户数,包括64、96和128。随着并发量提升,Hyperscale的性能优势依然保持,表明其扩展能力较为稳定。
HammerDB 是一款开源的数据库基准测试工具,支持 TPC-C(在线事务处理)和 TPC-H(决策支持)等标准工作负载模型。其中 TPC-C 模型模拟电商订单处理场景,包含新订单、支付、订单状态查询、库存查询和发货等事务类型,通过测量每分钟处理的事务数(TPM)来评估数据库的 OLTP 吞吐能力。HammerDB 支持多种数据库后端,并允许调整并发用户数、事务混合比例等参数,因此常被用于跨数据库平台的公平对比测试。本次测试中,测试方使用 HammerDB 的 TPC-C 工作负载,在高并发下测量订单处理量,这也是业界评估数据库事务处理性能的常见做法。
性能与性价比双领先
单纯看吞吐量,Hyperscale比Aurora高出约52%。但对企业而言,性价比同样关键。测试方用每月总订单数除以总计算小时数,衡量单位成本的订单处理能力。结果显示,Hyperscale每美元处理的订单数比Aurora多51%。
Ravi强调,客户不应只关注“堆算力换性能”,而应追求“在合适成本下获得最佳性能”。这一指标更贴近真实业务决策。
vCore(虚拟核心) 是 Azure SQL Database 和 Amazon Aurora 等云数据库的计费与资源配置单位,代表分配给数据库实例的计算能力。不同云厂商的 vCore 底层硬件可能不同(如 CPU 型号、内存配比、I/O 带宽),因此即使 vCore 数量相同,实际性能也可能存在差异。本次测试中,Principled Technology 选择了 16 vCore 的 Hyperscale 实例,并匹配 Aurora 上“规格相近”的实例,但具体配置对等性由测试方自行判断。读者在参考基准结果时,需注意 vCore 并非跨平台完全等价,实例匹配方式可能影响结论的普适性。
不止适用于大型数据库
虽然Hyperscale常被联想到超大规模数据库,但Ravi澄清其适用范围很广。用户可以从亚核级(sub-core)规格起步,也可选择无服务器(serverless)模式;需要整合多个数据库时,可使用弹性数据库池(elastic DB pools)。
存储方面,Hyperscale支持从几MB的小型数据库平滑扩展至至少128 TB,覆盖从初创应用到大型企业系统的全生命周期。这意味着团队可以随着业务增长在同一平台上扩展,无需早期就为峰值负载过度配置。
无服务器(Serverless) 计算模式允许数据库根据工作负载自动扩缩容,并在无流量时暂停计算资源,按实际使用量计费。Azure SQL Database 的无服务器模式提供自动暂停和恢复功能,适合间歇性、不可预测的工作负载,可显著降低非高峰时段的成本。弹性数据库池(Elastic DB Pools) 则是一种多租户资源池方案,将多个数据库共享同一组计算和存储资源,适用于 SaaS 应用等“多库、低平均利用率、峰值各异”的场景。这两种形态与 Hyperscale 的存储架构结合,使同一平台能覆盖从轻量级到超大规模的多样化需求。
对选型的启示
对于正在评估云数据库的企业,这份独立基准提供了可量化的参考:在相近vCore配置下,Hyperscale在订单处理场景中展现出更高的吞吐量和更优的成本效率。不过,基准测试结果受工作负载类型、并发模式和实例匹配方式影响,建议结合自身业务场景进行验证。
完整报告由Principled Technology发布,可在节目描述中找到链接。微软强调该测试由第三方独立完成,用户可自行阅读原始数据做出判断。
相关推荐

DeepSeek Harness速通指南:从安装到5个实战案例
DeepSeek Harness 是什么?本文基于 B 站教程,介绍这款 AI Agents 软件的工作原理、安装配置、四种工作模式,并通过 3D 赛车游戏、官网、音乐播放器、科普动画、自开发插件五个实战案例展示其能力,附 Token 省钱技巧。

拆解DeepSeek Super-agent架构:Router+Worker如何破解多会话管理瓶颈
解读DeepSeek Super-agent论文:Router+Worker双层架构如何通过Fast Pass、链式召回、存算分离解决多AI会话管理瓶颈,并分析其对人注意力瓶颈的真实缓解程度与工程取舍。

5天1.9万星!DeepSeek开源AI程序员为何爆火
DeepSeek开源AI程序员5天斩获1.9万星,从零登顶GitHub榜首。它为何爆火?本文分析智能体赛道热潮、AI自写代码的叙事以及从问答工具到AI员工的范式转变,并提醒研究代码仍需谨慎审核。