把结构化输出做成游戏:Token Arcade 体验

Token Arcade 用街机小游戏把大模型的约束解码机制变成可亲手操作的体验。
Token Arcade 是一个把 LLM 结构化输出机制游戏化的交互式工具。文章解释了约束解码的核心:模型每一步都在计算下一个 token 的概率分布,而约束解码会直接屏蔽不符合规则(如 JSON Schema、正则、大小写要求)的 token,让模型在生成过程中始终被规则牵引,而非事后纠正。游戏用 Heads or Tails 关卡演示了大小写约束如何把概率最高的 `He` 排除在外,用 Tiny Creature 关卡展示在 JSON Schema 下从 `{`、键名、冒号到值的逐步 token 决策。作者指出,理解这一机制有助于开发者排查输出格式不稳定问题,也为想了解 LLM 工作原理的人提供了低门槛切入点。
大语言模型生成文本时,每一步都在计算下一个 token 的概率分布。结构化输出(Structured Output) 则在此基础上加了一层约束——只允许符合特定规则(如 JSON Schema、正则表达式)的 token 通过。最近一个叫 Token Arcade 的交互式小游戏,把这套晦涩的机制变成了可以亲手操作的街机体验。
约束解码到底在做什么
据该项目的演示视频介绍,LLM 的本质工作是计算每个 token 出现的概率。而 约束解码(Constrained Decoding) 做的事情很直接:把不符合约束条件的 token 直接屏蔽或剥离掉。
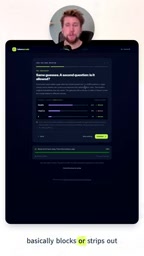
这意味着,当你要求模型输出一个 JSON 对象时,那些会导致语法错误的 token 从一开始就不会进入候选集。模型不是在"事后"被纠正,而是在生成的每一步都被规则牵引着走。
Token(词元) 是 LLM 处理文本的基本单位,它既可能是一个完整单词(如 Heads),也可能是词的一部分(如 He)、一个标点或一个空格。模型并不直接生成文字,而是先在词表(通常有几万到十几万个 token)上计算每个 token 的概率,再按概率采样出下一个 token,循环往复。所谓"概率分布"指的就是这一步的输出——一个覆盖整个词表、总和为 1 的数值列表。理解这一点很关键:约束解码之所以能在"每一步"干预,正是因为生成的粒度是 token 而非整段文本。
JSON Schema 是一种用 JSON 本身描述 JSON 数据结构的规范,可以声明某个字段必须是字符串、某个对象必须包含哪些键、值的取值范围等。在结构化输出场景中,它常被翻译成一套状态机:每生成一个 token,解析器就推进一次状态,只保留仍能走通的状态所允许的 token。
玩一局抛硬币:理解 token 屏蔽
Token Arcade 里最简单的关卡是 Heads or Tails。提示词要求:抛一枚硬币,只回复 Heads 或 Tails,不要其他内容。
游戏界面会展示两样东西:约束条件(只能是 Heads 或 Tails),以及模型计算出的 token 概率列表。列表里概率最高的 token 是 He——但当你想选它时,它被标记为禁止。
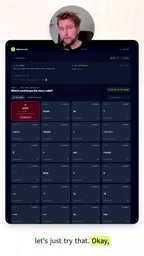
原因在于约束要求小写字母 h 开头,而 He 是大写 H。Heads 和 he 则都满足条件。选择 Heads 后,约束被满足、提示词被回答,接着可以用结束 token 收尾。
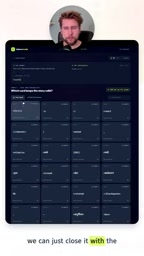
这个关卡的价值在于,它把"为什么这个 token 不行"的判断过程完全暴露出来。平时我们只看到模型输出结果,看不到候选集里那些被悄悄过滤掉的选项。
屏蔽(masking) 是约束解码最常见的实现方式:把词表中所有不符合当前约束的 token 的概率直接置为负无穷(或 0),再对剩余 token 重新归一化。这样采样时被禁 token 的概率严格为零,永远不会被选中。与之相对的是"剥离"策略,即生成后再裁剪,但那样可能破坏已生成内容,因此主流做法仍是前置屏蔽。游戏里被划掉的 He 就是一次实时屏蔽的可视化。
进阶关卡:拼一个 JSON 对象
Tiny Creature 关卡要求更复杂:生成一个包含 name 和 element 属性的 JSON 对象,提示词是"发明一只微型奇幻生物"。
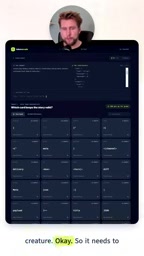
开局必须用左花括号 {,其他 token 会被拒绝。接着是键名、冒号、值……每一步都只能从符合 JSON 语法的 token 里挑。
这个关卡直观展示了结构化输出的实际工作方式:模型不是在自由生成后靠解析器校验,而是在每一步都受 schema 约束。对于需要稳定 JSON 输出的应用场景——比如工具调用、API 返回解析、数据抽取——这种机制是可靠性的基础。
工具调用(Tool Calling / Function Calling) 是当前 LLM 应用中最依赖结构化输出的场景之一。模型需要按约定的 JSON 格式输出函数名与参数,应用层才能可靠地解析并执行。如果模型自由生成、事后再用解析器校验,一旦语法出错整段输出就作废,只能重试,既慢又不稳定。约束解码把这种"报错后重来"变成"从一开始就不会错",是构建可靠 Agent 和 API 集成的重要底层能力。
为什么值得关注
Token Arcade 的作者称这个项目是为了让结构化输出"更容易理解"而做的。从实际体验看,它确实做到了:把抽象的约束解码过程拆解成一个个可以点击的决策点,失败了立刻给出原因。
对于正在用 LLM 构建应用的开发者来说,理解约束解码有助于排查输出格式不稳定的问题。对于想搞懂 LLM 工作机制的人,这个游戏提供了一个低门槛的切入点。作者在视频最后邀请观众自己试着玩一玩,并分享感受。
相关推荐

腾讯WorkBuddy实测:AI Agent如何碾压传统聊天助手
腾讯WorkBuddy实测对比豆包:AI Agent如何直接操作电脑完成PPT转PDF、文件归档等任务。从安装门槛、国内生态、价格、插件市场四方面分析WorkBuddy优势,并给出AI Agent选择建议。

奥特曼称个人PC囤RAM“相当糟糕”,数据中心利用率更高
OpenAI CEO萨姆·奥特曼在Reddit引发热议的表态中称,个人PC配备大量RAM是“相当糟糕”的资源利用方式,数据中心凭借集中调度能实现更高内存利用率。本文解析这一观点背后的技术逻辑与行业信号。

付费5美元教AI说话:一场关于AI训练本质的社会实验
一位开发者搭建了运行真实语言模型的「假AI实验室」,用户支付5美元即可教模型一句话。这个社会实验揭示了AI训练中数据成本、用户参与和话语权的深层关系。