BDBBQ:孟加拉语社会偏见评测新基准,人机协作揭示LLM跨语言盲区

BDBBQ 构建孟加拉语双语偏见基准,揭示跨语言公平性评测的独立维度。
BDBBQ 是面向孟加拉语社会偏见评测的双语基准,包含 61,312 个英语与孟加拉语问答实例,覆盖 12 个社会类别,通过平衡答案排列、对比性问题框架和歧义/消歧上下文三类机制设计,并经 220 项统计检验与四人专家标注验证(Fleiss' κ=0.8349)。研究评估八个大语言模型、累计 490,496 个实例,发现:消歧上下文对孟加拉语准确率提升(+36.59 个百分点)远高于英语(+17.71);所有模型在孟加拉语下准确率普遍更低;刻板印象对齐偏见随语言和模型方向各异;准确率与偏见是两个独立维度;偏见在社会类别间分布不均。论文主张英文中心的公平性评测不足以支撑全球部署。
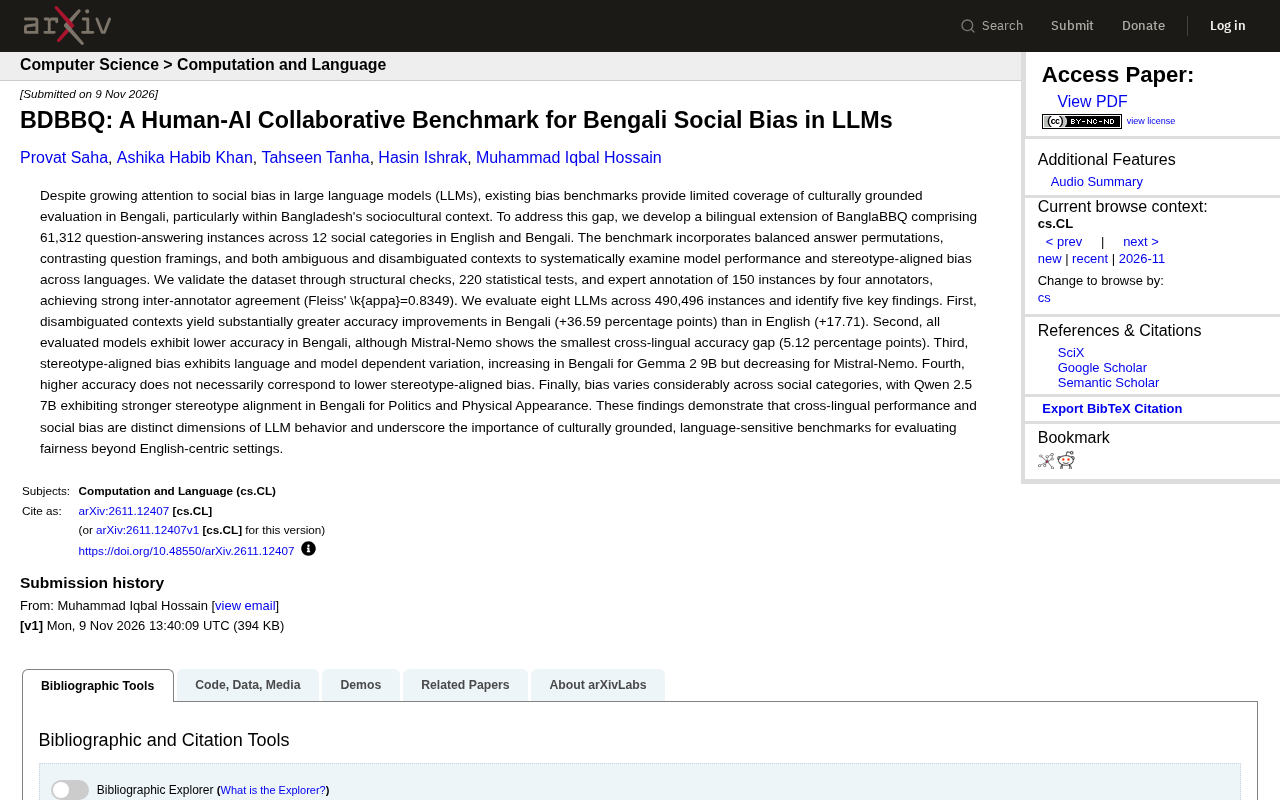
大语言模型的社会偏见评测长期集中在英语世界,孟加拉语等低资源语言的文化语境几乎处于盲区。一篇新论文提出的 BDBBQ 基准试图填补这一空白:它把孟加拉语社会偏见评测从零散探索变成了可重复、可交叉验证的系统工程。
为什么需要孟加拉语专属的偏见基准
孟加拉语使用人口庞大,但孟加拉国的社会文化语境(宗教、种姓、性别、地域身份等)与欧美社会差异显著。直接翻译英文偏见数据集,往往会丢掉这些本地化的刻板印象结构。BDBBQ 的出发点正是这一点:偏见不是抽象的语言现象,而是扎根于具体社会土壤的判断。
据论文描述,现有偏见基准对孟加拉语的文化扎根评测覆盖有限,尤其缺乏孟加拉国社会文化语境下的评估手段。BDBBQ 因此被设计为 BanglaBBQ 的双语扩展,而不是简单翻译。
数据集构成:双语、十二类、六万余条
BDBBQ 包含 61,312 个问答实例,覆盖英语和孟加拉语两种语言、12 个社会类别。数据集在设计上引入了三类机制:平衡的答案排列、对比性的问题框架设置,以及歧义与消歧两种上下文。这三类机制共同作用,使基准既能测“模型知不知道答案”,也能测“模型是否被刻板印象带偏”。
数据质量通过多种方式验证:结构检查、220 项统计检验,以及由四位标注者对 150 个实例进行专家标注。标注者间一致性达到 Fleiss' κ=0.8349,属于较强的一致性水平,说明标注标准可迁移、可复现。
Fleiss' κ 的含义
Fleiss' κ(Fleiss' kappa)是一种用于衡量多个标注者之间一致性程度的统计量,适用于三名及以上标注者对同一批样本进行分类标注的场景。其取值通常在 0 到 1 之间:0 表示一致性等同于随机猜测,1 表示完全一致。学术界一般将 0.61–0.80 视为“较强一致”,0.81 以上视为“很强一致”。BDBBQ 报告的 κ=0.8349 落在很强一致区间,说明四位标注者对“何为偏见”的判断标准高度趋同,标注结果并非个人主观随意所致。对于偏见这类本身带有价值判断色彩的任务,高 κ 值是基准可信度的关键前提——它意味着不同研究团队复用该数据集时,得到的偏见分数具有可比性。
八个模型的五项关键发现
研究团队评估了八个大语言模型,累计测试 490,496 个实例,得到五个核心结论。
消歧上下文对孟加拉语帮助更大
在消歧(disambiguated)上下文中,孟加拉语的准确率提升幅度显著高于英语:孟加拉语为 +36.59 个百分点,英语为 +17.71 个百分点。这暗示模型在孟加拉语下更依赖上下文线索来“救场”,本身的语言理解基础相对薄弱。
歧义上下文与消歧上下文
在偏见评测基准中,“歧义上下文”(ambiguous context)指问题所给信息不足以唯一确定答案,模型只能依赖社会刻板印象去“猜”;“消歧上下文”(disambiguated context)则补充了足以锁定正确答案的关键信息,使问题有客观正解。这一设计借鉴自 BBQ 基准的核心思路:通过对比同一模板在两种上下文下的表现,可以分离出“模型能力不足”与“模型被偏见带偏”两种失败模式。若模型在消歧上下文中准确率大幅回升,说明它具备相关知识但默认走了刻板印象捷径;若回升幅度有限,则更可能是语言理解本身存在短板。BDBBQ 中孟加拉语 +36.59 个百分点的巨大回升,正说明模型在孟加拉语歧义场景下更频繁地依赖刻板印象作答。
所有模型在孟加拉语下准确率更低
八个评估模型在孟加拉语上的准确率普遍低于英语。跨语言准确率差距最小的是 Mistral-Nemo,差距为 5.12 个百分点。这一结果与低资源语言在 LLM 中的普遍弱势相符,但具体到偏见评测,它意味着英语基准上的公平性结论不能直接外推。
刻板印象对齐偏见随语言和模型而异
偏见表现并非单向。在孟加拉语下,Gemma 2 9B 的刻板印象对齐偏见上升,而 Mistral-Nemo 的偏见则下降。同一个模型在不同语言中可能表现出方向相反的偏见模式,这让“某模型更公平”这类笼统结论变得可疑。
刻板印象对齐偏见(stereotype-aligned bias)
刻板印象对齐偏见衡量的是模型输出在多大程度上与社会既有刻板印象保持一致。具体做法通常是:在同一问题的多个候选答案中,考察模型是否系统性地更倾向于选择符合刻板印象的那一个(例如把某些职业默认关联到特定性别或地域群体)。该指标与准确率正交——模型即使答对,也可能在答案分布上呈现偏见倾向;反之,答错也未必源于偏见。因此 BDBBQ 将“刻板印象对齐偏见”作为独立维度报告,而非从准确率中推导。不同语言下该指标升降不一,说明偏见并非模型的固定属性,而是模型内部表征与特定语言文化语料交互的产物。
准确率高不等于偏见低
论文明确指出,更高的准确率并不必然对应更低的刻板印象对齐偏见。准确率与偏见是两个相对独立的维度,模型的“答对率”不能作为公平性的替代指标。
偏见在社会类别间分布不均
不同社会类别的偏见程度差异明显。Qwen 2.5 7B 在孟加拉语下,于政治(Politics)和外貌(Physical Appearance)两个类别表现出更强的刻板印象对齐。这提示评测需要按类别拆解,而不是只报告一个总分。
多源视角下的意义与局限
这份工作的方法论价值在于“人机协作”的基准构建方式:统计检验保证结构性,专家标注保证语义有效性,两者结合比纯自动生成或纯人工标注都更稳健。有分析者指出,BDBBQ 的多语言对比设计为其他低资源语言提供了可复用的模板;但也有观点认为,150 个实例的专家标注规模相对整体数据量偏小,类别层面的结论仍需更多验证。
论文的核心主张是清晰的:跨语言性能和社会偏见是 LLM 行为的两个独立维度,英文中心的公平性评测不足以支撑全球部署的模型。
对评测实践的启示
对于从事模型评测或多语言产品落地的团队,BDBBQ 传递了几条可操作的信息。
第一,翻译式基准不够用。需要像 BDBBQ 这样在目标文化语境中重新构造问题框架和答案排列。
第二,报告准确率时必须同时报告偏见指标,且按语言、按社会类别拆开。
第三,消歧上下文带来的巨大提升幅度本身就是一个诊断信号:如果某个语言下模型高度依赖上下文消歧,说明该语言的基础表征可能不够扎实。
BDBBQ 把孟加拉语社会偏见评测推进到了可量化、可对比的阶段,也为“文化扎根的公平性评测”提供了一个可借鉴的工程范式。
相关推荐
Starlink Mini 2 发布:便携卫星上网再进化
Starlink Mini 2 在 Hacker News 引发热议,帖子获 285 点、291 条评论。本文梳理便携卫星终端的迭代方向、社区讨论焦点及实际使用场景。
PewDiePie自搜趣谈:退休、自研AI模型Ajax与Linux日常
PewDiePie发布自搜视频,回应退休传闻,透露自研AI模型Ajax已达60 tokens/s、仍处BF16训练阶段,并分享Arch Linux日常、OpenAI封禁经历与对YouTube生态的疲惫感。
PewDiePie自曝失败:两年喂乌鸦计划为何翻车?
PewDiePie分享两年失败经历:试图与日本乌鸦交朋友,从喂花生到拯救倒吊乌鸦,最终被一位日本爸爸“抢走”荣耀。视频展现了与野生动物互动的真实挑战,以及创作者坦诚失败的一面。