北美L40/L40G GPU租赁难题:供需缺口与替代方案分析
北美L40/L40G GPU批量租赁严重短缺,专业云平台与预留合约是可行出路。
Reddit社区一则求租帖揭示了AI算力市场的真实痛点:NVIDIA L40/L40G因其在推理、图形与中等规模训练上的高性价比定位,需求急剧膨胀,但产能持续向H100等旗舰卡倾斜,导致中端专业卡在北美市场出现批量供应严重不足的局面。面对这一困境,文章梳理了三条可行路径:向AWS、GCP等主流云厂商申请预留实例以锁定容量;直接联系Lambda、CoreWeave等专业GPU云平台的销售团队获取专属报价;或通过Vast.ai等点对点市场寻找碎片化库存。若L40/L40G确实无法批量获取,则可评估A40、L4等性能相近的替代型号,或将负载迁移至库存更充裕的其他地区。文章最终指出,AI算力获取的竞争逻辑正从"比价"转向"稳定供货",提前规划和锁定容量将成为企业的核心竞争力。
一个来自社区的真实需求
近期在Reddit社区中,一位用户发出了这样一条简短却耐人寻味的求助帖:希望在北美地区批量租赁NVIDIA L40/L40G GPU,但发现主流市场上的供应量远远不足,不知道还能从哪里租到。
这条看似普通的求租信息,实际上折射出当前AI算力市场一个真实而普遍的痛点——特定型号的专业级GPU正处于供不应求的状态,尤其是在需要批量部署的场景下。
L40/L40G 为何成为抢手货
NVIDIA L40 是基于 Ada Lovelace 架构的数据中心级 GPU,配备 48GB GDDR6 显存,面向图形渲染、虚拟工作站、AI 推理以及混合负载场景设计。相较于更昂贵、更稀缺的 H100、A100 等旗舰训练卡,L40 系列在推理、图形计算和中等规模训练任务上提供了更具性价比的选择。
L40G(通常指 L40S 或面向特定场景的变体)进一步强化了 AI 推理和训练的平衡能力,成为许多企业在生成式 AI 部署中的热门选项。正因为它定位在"够用且相对划算"的甜点区间,市场需求迅速膨胀,供应却跟不上节奏。
供需错配的根本原因
从这位用户"市场上看不到足够数量"的描述可以看出几个信号:
- 产能被旗舰卡挤占:在 AI 热潮下,NVIDIA 的产能和分销资源优先倾斜给了 H100、H200 等高端型号,中端专业卡的现货流通量相对有限。
- 批量需求难满足:个人或小团队租用一两张卡尚可,但一旦涉及"批量租赁",公开市场的碎片化供应就显得捉襟见肘。
- 区域性限制:求租者明确限定在北美地区,而算力资源的地理分布并不均衡,特定区域的可用库存可能远低于整体水平。
Ada Lovelace 是 NVIDIA 于 2022 年推出的 GPU 微架构,采用台积电 4nm 工艺制造,相比上一代 Ampere 架构在能效比和 AI 推理吞吐量上有显著提升。该架构引入了第四代 Tensor Core 和第三代 RT Core,使同一块 GPU 能够同时高效处理深度学习矩阵运算与光线追踪渲染任务。L40 正是基于此架构专为数据中心设计的"双栖"卡——它既不像 A100/H100 那样完全面向纯计算,也不像消费级显卡只偏重图形,而是在 48GB 大容量显存的支撑下兼顾两者,因此特别适合多租户云环境和需要同时承载推理与可视化工作负载的企业场景。
批量租赁 GPU 的可行路径
针对这类需求,社区和行业内通常有几条可行的解决思路,值得有类似需求的用户参考。
主流云服务商的按需与预留实例
AWS、Google Cloud、Microsoft Azure 以及 Oracle Cloud 等大型云厂商都提供配备 L40 系列或同级 GPU 的实例。对于批量且持续的需求,预留实例(Reserved Instance)或承诺使用折扣往往比现货租赁更划算,也更能保证容量。缺点是价格通常高于专业 GPU 云,且具体型号可用性因区域而异。
专业 GPU 云平台
近年来涌现出大量专注于 AI 算力的新兴云平台,例如 Lambda、CoreWeave、RunPod、Vast.ai 等。这类平台往往以更灵活的计费方式和更具竞争力的价格提供各类 GPU,其中一些平台的 L40/L40S 库存可能优于综合云厂商。对于寻求批量租赁的用户,直接与这类平台的销售团队沟通,往往能获得公开列表之外的专属容量报价。
这类专业 GPU 云平台的商业模式与传统云厂商存在本质差异。Lambda Labs、CoreWeave 等平台通常自建或托管大规模 GPU 集群,以裸机或近裸机的方式出租,省去了虚拟化层的性能损耗,更适合对 GPU 利用率和延迟敏感的 AI 训练与推理任务。CoreWeave 早期依靠以太坊挖矿积累了大量 GPU 资产,在挖矿收益下降后转型算力租赁,因此在 NVIDIA 专业卡库存上具备一定先发优势。Vast.ai 则采用聚合模式,将分散在全球的个人矿机、小型数据中心算力统一纳入市场撮合,买家可按小时竞价,价格弹性较大但稳定性参差不齐。与这类平台的销售团队直接洽谈,往往可以获得未在官网公示的专属算力池或优先排队权,这对批量采购尤为关键。
去中心化与点对点算力市场
Vast.ai 这类点对点市场聚合了大量个人和小型数据中心的闲置算力,有时能找到主流平台缺货的型号。不过这类来源在稳定性、SLA 保障和合规性上相对较弱,适合对可靠性要求不极端苛刻的场景。
当供应确实不足时的替代策略
如果 L40/L40G 在目标区域确实难以批量获取,不妨考虑以下思路:
- 型号替代:评估 A40、L4 或 RTX 6000 Ada 等显存与算力接近的型号是否能满足工作负载需求。
- 跨区域部署:如果业务允许,将部分负载迁移到库存更充裕的其他区域。
- 长期合约锁定容量:与供应商签订中长期合约,提前锁定批量容量,避免现货市场的波动。
小结
这条简短的求租帖,是 AI 算力市场供需紧张的一个缩影。L40/L40G 作为性价比突出的中端专业卡,正面临旺盛需求与有限现货之间的矛盾。对于有批量租赁需求的用户,与其在碎片化的公开市场上苦苦寻找,不如主动联系专业 GPU 云平台的销售团队、评估预留容量方案,或考虑性能相近的替代型号。算力获取正在从"看谁价格低"转向"看谁能稳定供货",提前规划容量将成为关键竞争力。
相关推荐
ICLR 2027仍在发拒稿信,学术圈苦AI水文久矣
ICLR 2027持续对低质量投稿发出desk reject,Reddit社区对此表示支持。本文分析AI生成论文泛滥下学术会议的初筛压力、评价体系激励扭曲,以及研究者该如何应对。
Anthropic印度公司早于Claude?一个名字引发的趣闻
Reddit网友发现印度存在一家早于AI公司Anthropic的同名企业,引发对品牌命名与商标保护的讨论。本文梳理这一趣闻的来龙去脉与启示。
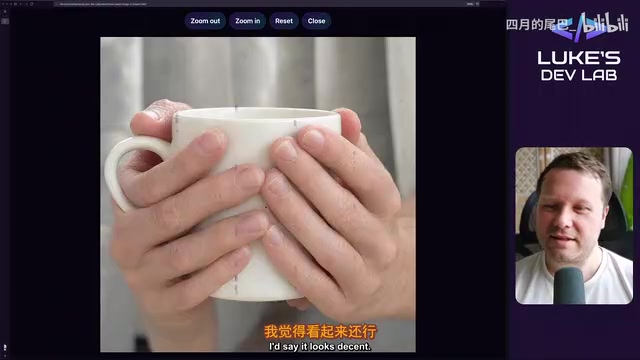
Qwen Image 2.1本地32项实测:数数翻车,动漫风格意外能打
B站UP主Luke的DevLab用RTX 5090本地实测Qwen Image 2.1共32项:拼写与空间布局可靠,苹果计数翻车,动漫风格优于写实人体,自行车轮辐条等几何结构明显短板,画面反复出现疑似训练数据残留的紫色印记。