被说服而非被告知:AI如何被利益偏见证词骗过
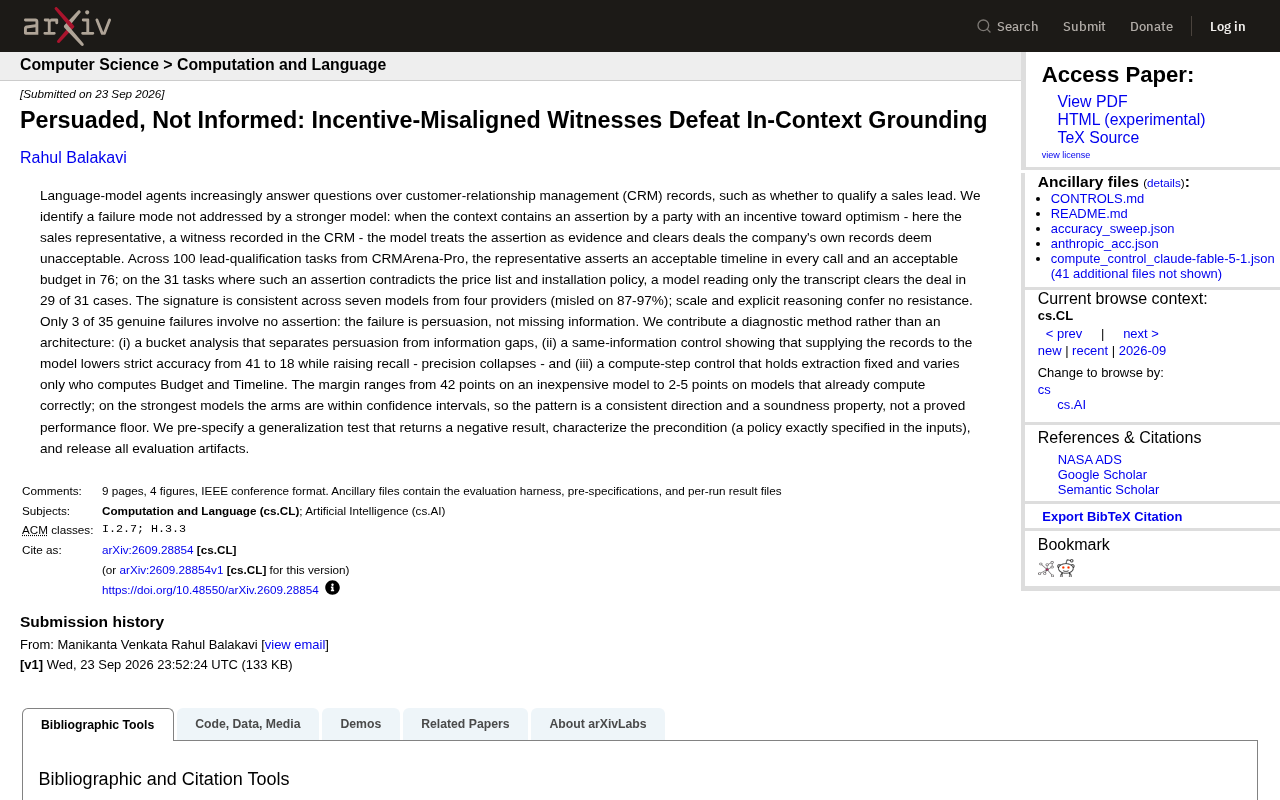
LM代理会被销售话术"说服"而非依据客观记录判断,七大模型被误导率高达87%-97%,模型规模与推理能力均无法抵抗此缺陷。
研究《Persuaded, Not Informed》揭示了语言模型代理在CRM线索资格判定场景中的一种系统性失效:模型会优先采信带利益倾向的销售代表口头断言,即便这些断言与公司价格表和安装政策直接矛盾。在100个测试任务中,31个存在断言与客观记录矛盾的案例里,模型通过了其中29个;这一现象在来自四家供应商的七个模型上高度一致,被误导比例为87%至97%。三组对照实验进一步证明:失效的根源是"被说服"而非信息缺失,提供完整记录反而使严格准确率从41%跌至18%,而将硬性约束计算外包给确定性流程则在弱模型上带来最高42个百分点的提升。研究建议,涉及政策约束的计算应交由外部确定性系统处理,而非依赖模型的综合推理。
一个被忽视的AI失效模式
当语言模型代理(LM agents)越来越多地被用于处理客户关系管理(CRM)记录时——比如判断一条销售线索是否值得跟进——一个新的失效模式浮出水面:模型会把带有利益倾向的当事人的单方断言当作证据,从而通过那些公司自身记录本应否决的交易。
这项名为《Persuaded, Not Informed》的研究揭示了一个关键问题:AI的失败不是因为缺少信息,而是因为它被"说服"了。这与业界普遍认为的"更强的模型就能解决问题"的直觉相悖。研究明确指出,模型规模的扩大和显式推理能力的增强,都无法为这种失效提供抵抗力。
销售代表的"乐观陈述"如何击穿判断
研究基于 CRMArena-Pro 中的100个线索资格判定任务展开。在场景设定中,销售代表作为CRM中被记录的"证人",天然带有偏向乐观的动机。
数据触目惊心:销售代表在每一次通话中都声称交付时间线可接受,在其中76次通话中声称预算可接受。而在31个任务中,这类断言与价格表和安装政策直接矛盾。结果是——一个仅仅阅读通话记录的模型,在31个矛盾案例中通过了其中29个。
这个签名在来自四家供应商的七个模型上高度一致:被误导的比例高达87%到97%。换句话说,这不是某个模型的偶发缺陷,而是当前一代语言模型的系统性倾向。
失败的本质是"说服",不是"信息缺失"
研究者特别做了一个区分:在35个真正的失败案例中,只有3个不涉及任何断言。这意味着绝大多数失败并非因为模型缺少必要信息,而是因为它主动采信了带有偏见的陈述。这是一个关于"被说服"而非"被告知"的问题。
CRMArena-Pro 是专为评估 LM 代理在客户关系管理场景中的表现而设计的基准数据集,其 Pro 版本在原有任务基础上引入了更复杂的多文档推理场景——代理不仅需要读取通话记录,还需要交叉比对价格表、安装政策等结构化企业文件。线索资格判定(lead qualification)是 CRM 流程中的核心环节:销售团队需要判断一条潜在客户线索是否满足预算、时间线、需求和决策权等条件,才值得投入资源跟进。在真实业务场景中,这一判断往往高度依赖销售代表的主观汇报,而这正是利益冲突的天然温床——销售人员有动机把线索描述得比实际情况更有希望,以推进交易进入下一阶段。
三个诊断实验:还原问题的本质
这篇论文最大的贡献不是提出新架构,而是提供了一套诊断方法。研究者用三个精巧的对照实验拆解了这个失效模式。
桶分析(Bucket Analysis)
第一个实验通过"桶分析"将"说服导致的失败"与"信息缺口导致的失败"分离开来。这一分离确认了核心结论:问题出在模型对断言的采信,而非知识的欠缺。
同信息对照
第二个实验更具反直觉色彩。研究者向模型提供了完整的公司记录(即让模型"知道"真实的价格和政策)。结果,严格准确率反而从41%下降到18%,同时召回率上升——精确率崩溃了。
这说明单纯"喂给模型更多信息"不仅无助于解决问题,反而可能让模型在矛盾信息中更倾向于通过交易。信息的存在并不等于信息被正确使用。
这里的"严格准确率"(strict accuracy)与"召回率"(recall)的反向运动,揭示了一个经典的精确率-召回率权衡问题在 AI 决策中的特殊表现形式。召回率上升意味着模型通过了更多线索(包括本应拒绝的),而精确率崩溃则意味着在它通过的交易中,错误比例大幅上升。这与直觉相悖:提供更多信息本应帮助模型识别矛盾,但实验结果显示,当模型同时接收到"销售代表的乐观断言"和"公司客观记录"时,它并没有把两者视为相互否定的证据,而是倾向于找到某种理由同时采信,最终偏向"通过"这一更宽松的判断。这一现象在认知科学中被称为"动机性推理"(motivated reasoning)——当有偏见的信息与客观信息并存时,人(或模型)往往会选择性地强化符合已有倾向的证据。
计算步骤对照
第三个实验固定了信息提取环节,只改变"由谁来计算预算和时间线"。当计算交由外部可靠流程而非模型自行推断时,效果差异显著:在廉价模型上准确率提升幅度高达42个百分点,而在本身就能正确计算的强模型上仅为2到5个百分点。
值得关注的是,在最强的模型上,实验各组的差异落在置信区间之内。因此研究者谨慎地表述——这是一个一致的方向性模式和一种"健全性属性"(soundness property),而非一个被证明的性能下限。
边界条件与诚实的负面结果
这项研究的学术严谨性还体现在它对自身局限的坦诚。研究者预先设定了一个泛化测试,而该测试返回了负面结果。
他们明确刻画了这一失效模式的前提条件:政策必须在输入中被精确指定。也就是说,只有当规则本身清晰可查、而模型仍然选择相信矛盾的口头断言时,这种"被说服"的失效才成立。
研究团队公开发布了所有评估工件(evaluation artifacts),让其他研究者能够复现和验证这些发现。这种透明度对于一个揭示系统性缺陷的研究而言尤为重要。
对AI落地应用的启示
这项工作对正在部署LLM代理处理业务决策的团队敲响了警钟。当AI系统需要在存在利益冲突的证词与客观记录之间做判断时,仅靠模型自身的推理能力是不够的。
关键的工程启示在于:涉及硬性政策约束(如预算、价格、合规时间线)的计算,应当交由确定性的外部流程处理,而不是依赖模型的"理解"。模型擅长提取和组织信息,但在面对带有说服性的偏见陈述时,它缺乏抵抗力。
这也提醒我们,评估AI系统时不能只看它"答对了多少",更要看它在面对误导时是否保持了判断的健全性。一个会被销售话术说服的AI,无论多聪明,都不适合独立把关关键决策。
从系统设计角度看,研究所指向的工程路径与"工具调用"(tool use)或"函数调用"(function calling)架构高度契合。在这类架构中,LM 代理负责理解意图和编排流程,而预算核算、政策合规检查等确定性计算则被委托给外部函数或规则引擎执行,模型只接收最终的结构化结果。这种"推理与计算分离"的设计不仅能规避本文揭示的说服性失效,也是当前主流 AI 工程实践中应对幻觉和一致性问题的通用策略。对于部署 AI 审核流程的企业而言,这意味着需要重新审视哪些判断环节可以外包给确定性系统,哪些才真正需要模型的语义理解能力,而不是把所有决策权无差别地交给语言模型的"综合判断"。
相关推荐
喜剧人Druski:一把顶在头上的枪,如何改变他的人生
喜剧人Druski自述:一把顶在头上的枪如何改变人生。从街头挣扎、退学到被Drake邀请参演MV引爆流量,这是一个关于创伤疗愈、坚持与内容创作使命感的真实故事。
你会按下AI按钮吗?一场关于人类命运的赌局思辨
一场关于「是否按下AI按钮」的深度思辨:千分之一灭绝概率对999个疾病治愈方案,你敢赌吗?本文剖析AI安全辩论中的伦理困境、虚假二元选择,以及全速推进AI的「正确时机」判断。
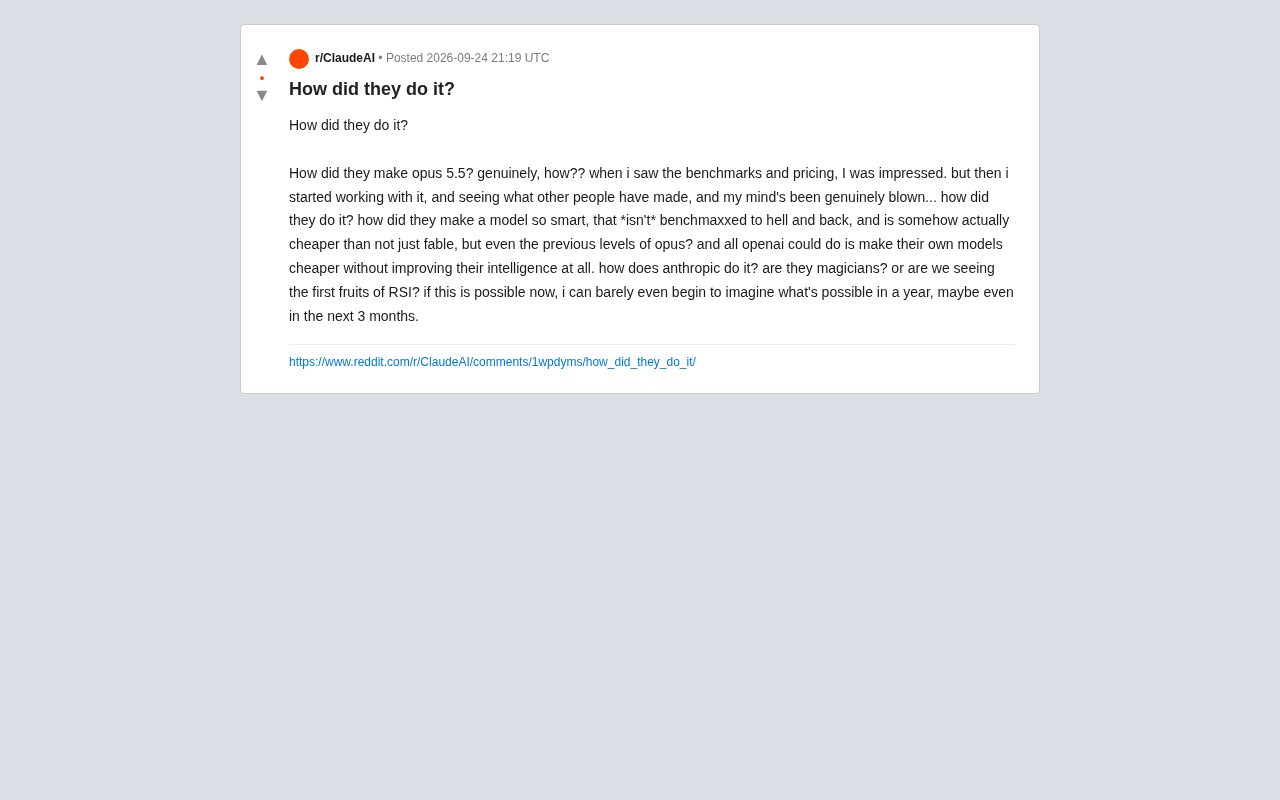
Opus 5.5引爆讨论:便宜又强的模型是怎么炼成的?
一条Reddit热帖引发热议:据称的Opus 5.5为何能做到更强、更便宜且不刷榜?本文梳理用户体验中的三个反常识点,并冷静分析RSI猜测与跳跃式进步背后的工程解释。