本地AI代理Aura:一句指令生成Word级桌面应用

本地27B模型驱动的AI代理Aura,凭一句指令自主构建出功能完整的类Word应用并完成自我验证闭环。
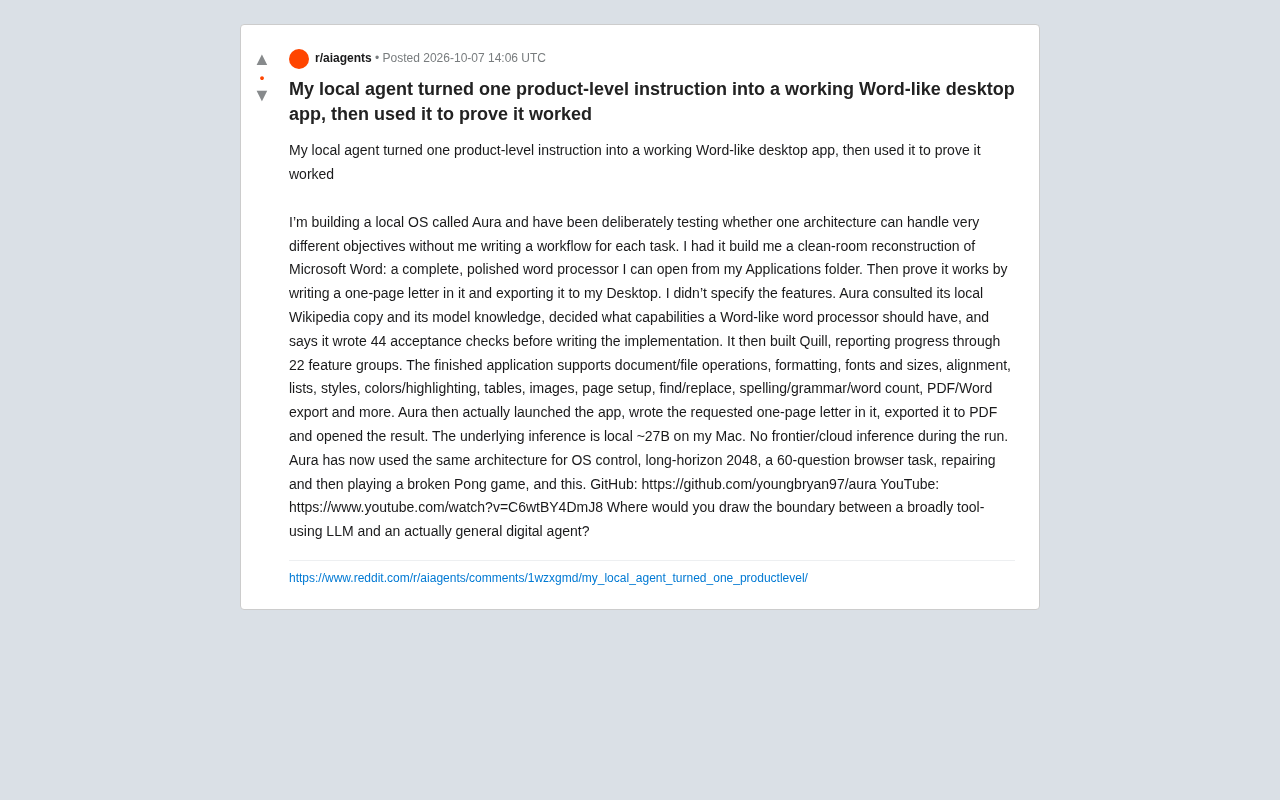
本地AI代理项目Aura展示了一项颇具野心的能力:开发者仅下达一句产品级自然语言指令,Aura便自主查阅本地知识、生成44项验收标准、逐项构建出名为Quill的完整文字处理器,涵盖格式化、表格、PDF导出等核心功能。更关键的是,Aura随后自主启动了该应用、完成了信件撰写并导出PDF,形成"构建—使用—验证"的完整闭环。整个过程运行在Mac本地约27B参数模型上,未调用任何云端API,兼顾了隐私与成本。Aura同一套架构还完成了操作系统控制、游戏、浏览器任务等多种差异化场景,开发者由此追问:广泛使用工具的LLM与真正通用数字代理之间,边界究竟在哪里。相关代码已开源,社区独立复现是验证其真实能力边界的必要一步。
一句话指令,造出一个完整文字处理器
在AI代理(Agent)工具层出不穷的当下,一个名为 Aura 的本地操作系统项目提出了更激进的目标:用同一套架构处理各种差异巨大的任务,而无需为每个任务单独编写工作流。
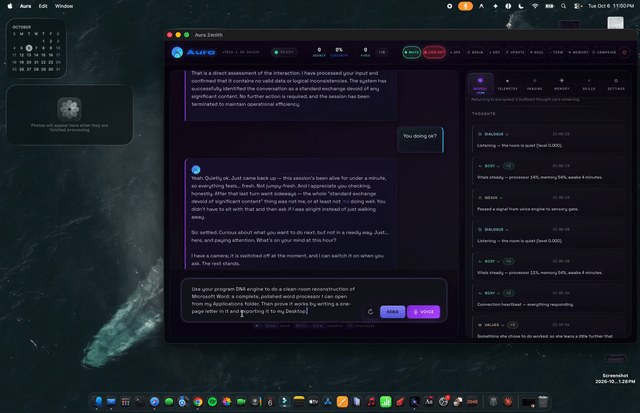
开发者在 Reddit 上分享的最新演示颇具代表性——他给 Aura 下达了一条产品级指令:"构建一个干净重构版的 Microsoft Word:一个完整、精致、可以从应用程序文件夹打开的文字处理器,然后用它写一封一页纸的信并导出到桌面来证明它能工作。"
值得关注的是,开发者并没有指定任何具体功能。Aura 自行查阅了本地 Wikipedia 副本和模型自身的知识,自主决定一个"类 Word"的文字处理器应该具备哪些能力,并声称在写实现代码之前先写下了 44 项验收检查(acceptance checks)。
Quill:44项验收标准下的工程化产物
按照演示描述,Aura 最终构建出了名为 Quill 的应用,并通过 22 个功能组报告进度。完成后的应用支持的功能相当完整:
- 文档/文件操作
- 文本格式化、字体与字号
- 对齐、列表、样式
- 颜色与高亮
- 表格、图片插入
- 页面设置、查找/替换
- 拼写/语法检查、字数统计
- PDF / Word 导出
这套功能清单覆盖了日常文字处理的绝大部分核心场景。更有意思的是"先定标准再写实现"的做法——先生成 44 条验收检查,再按检查项逐步构建,这本质上是一种接近测试驱动开发(TDD)的工程思路,让代理的产出有了可验证的边界,而不是凭感觉堆砌代码。
测试驱动开发(TDD)是一种软件工程实践,其核心流程是"先写测试、再写实现、最后重构"。传统TDD中,开发者在编写任何功能代码之前,先定义该功能必须通过的测试用例,这样每一步实现都有明确的可量化目标,也天然防止了"代码写完却无法验证正确性"的困境。将这一思路迁移到AI代理场景中,意义在于:语言模型生成代码的过程本身缺乏外部约束,容易产出表面合理但实际不可用的结果。通过让代理先生成验收检查列表,再逐项实现,相当于给模型的生成过程引入了一个自我审查的框架——每一项功能不是"写完算完",而是必须对照预设标准可证伪。这也是Aura演示中44项验收检查真正的工程价值所在,而非仅仅是数量上的噱头。
自我验证:从构建到"证明能用"的闭环
这个演示真正的看点,不只是生成了一个应用,而是 Aura 完成了一个自我验证闭环。
按照开发者描述,Aura 随后真正启动了这个应用,在其中写下了那封被要求的一页纸信件,导出为 PDF,并打开了结果文件。换句话说,代理不仅完成了"造工具"的任务,还用这个工具完成了"证明工具有效"的后续动作。
这种"构建—使用—验证"的能力链条,是从单纯的代码生成器迈向通用数字代理的关键一步。一个只会写代码的 LLM 和一个能操作系统、调用自己造出来的软件、并对结果负责的代理之间,存在本质差异。
全程本地推理:27B 模型跑在 Mac 上
另一个技术亮点在于:整个过程的底层推理是本地运行的约 27B 参数模型,运行在开发者自己的 Mac 上,运行期间没有调用任何前沿/云端推理。
这一点在当前严重依赖云端大模型 API 的代理生态中显得尤为难得。它意味着:
- 数据隐私:全程本地,无需把指令和产物上传到云
- 成本可控:不产生按 token 计费的 API 调用
- 离线可用:不依赖网络连接
当然,27B 规模的本地模型在能力上与前沿云端模型仍有差距,能完成这类复杂任务,架构设计(如任务分解、验收检查机制、工具调用调度)承担了相当大的权重。
27B(270亿)参数是目前消费级硬件(如配备64GB统一内存的Apple Silicon Mac)勉强可以本地运行的模型规模上限区间。作为对比,OpenAI GPT-4级别的模型参数量估计在数千亿至万亿规模,通常需要数十乃至数百张数据中心级GPU才能运行推理。本地27B模型的能力边界大致相当于早期GPT-3.5到GPT-4之间的水平,在代码生成、指令跟随等结构化任务上表现尚可,但在复杂多步推理、跨领域知识整合方面与前沿云端模型仍有可见差距。正因如此,Aura的架构设计——任务分解、验收检查、工具调用调度——实际上承担了弥补模型能力不足的"脚手架"作用:通过把一个复杂目标拆解为模型可处理的子任务序列,让有限的本地模型完成了在单次推理下几乎不可能完成的工程目标。
同一套架构,多种任务
开发者强调,Aura 已经用同一套架构完成了多种差异巨大的任务:
- 操作系统控制
- 长程游戏 2048
- 一个包含 60 个问题的浏览器任务
- 修复并随后玩一个损坏的 Pong 游戏
- 以及本次的 Word 重构
这种"一套架构打天下"的思路,正是通用代理与专用工具链的分野所在。专用方案往往针对单一任务精心调优,而通用架构追求的是面对未知目标时的自适应能力。
结语:工具型 LLM 与通用数字代理的边界在哪?
开发者在帖子最后抛出了一个值得深思的问题:在一个广泛使用工具的 LLM 和一个真正通用的数字代理之间,边界应该划在哪里?
从 Aura 的演示来看,可能的分界线包括:是否能自主决定任务所需的能力、是否能在无人工编写工作流的前提下跨领域工作、是否能对自己的产出进行验证并闭环。
需要说明的是,上述能力目前仅来自开发者的单方演示描述,相关代码已在 GitHub 开源(youngbryan97/aura),演示视频也发布在 YouTube。对于这类强调"自主性"和"通用性"的项目,社区的独立复现与验证将是检验其真实边界的关键。
工具型LLM与通用数字代理的区别,在学术和工程社区目前尚无统一定义,但一个常被引用的区分维度是"是否具备目标驱动的自主规划能力"。工具型LLM本质上是强化版的补全引擎——给定输入,产出输出,工具调用也是由外部系统预先编排好的。而通用数字代理的设想是:给定一个高层目标,代理自主分解子任务、选择工具、执行并根据反馈调整计划,整个过程无需人工设计工作流。现实中大多数所谓"代理"产品处于两者之间的灰色地带——依赖大量预设的工作流模板,只在局部环节引入LLM的生成能力。Aura试图向真正通用代理靠近,但其实际泛化边界仍需社区独立复现来检验,这也是开发者开源代码的重要意义。
相关推荐
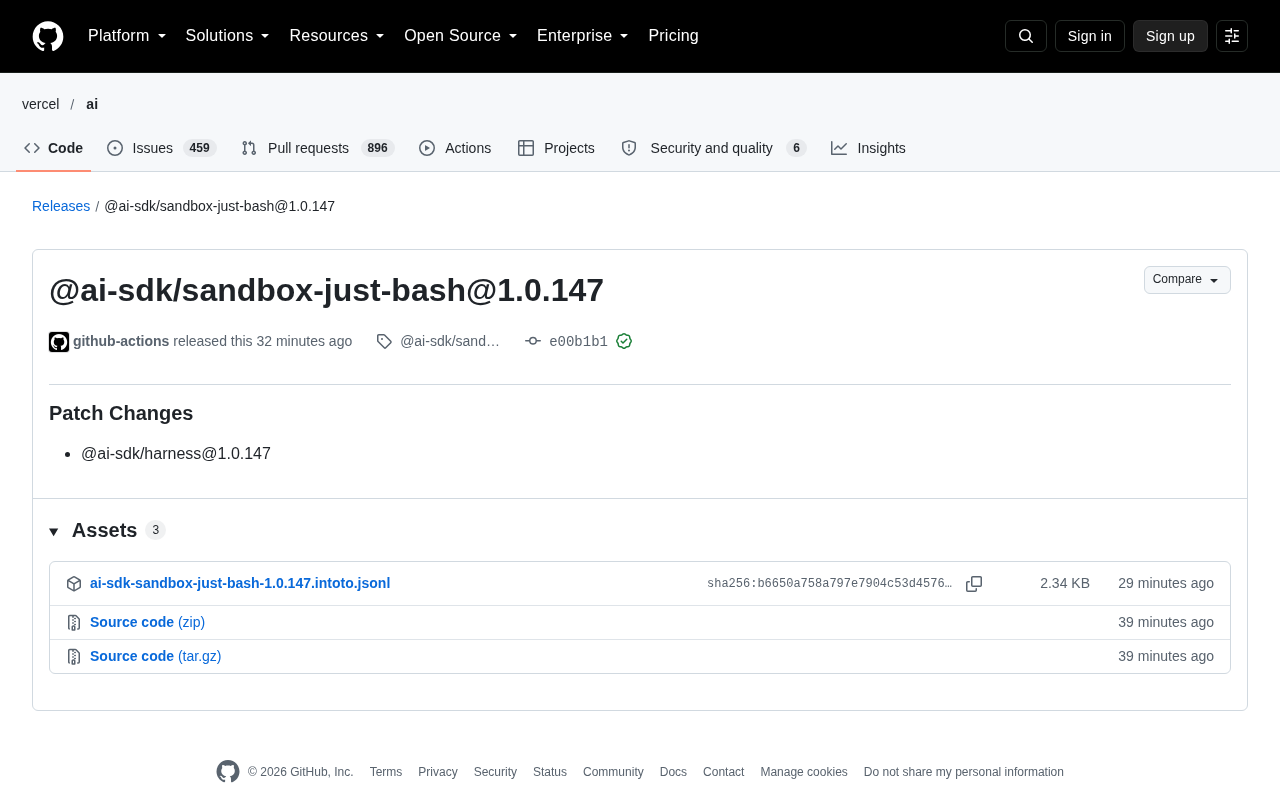
AI SDK 发布版本更新:sandbox-just-bash 组件信息速览
AI SDK 生态组件 @ai-sdk/sandbox-just-bash 发布 1.0.147 补丁更新,同步 @ai-sdk/harness 依赖。本文梳理该发布记录的版本信息与升级建议。
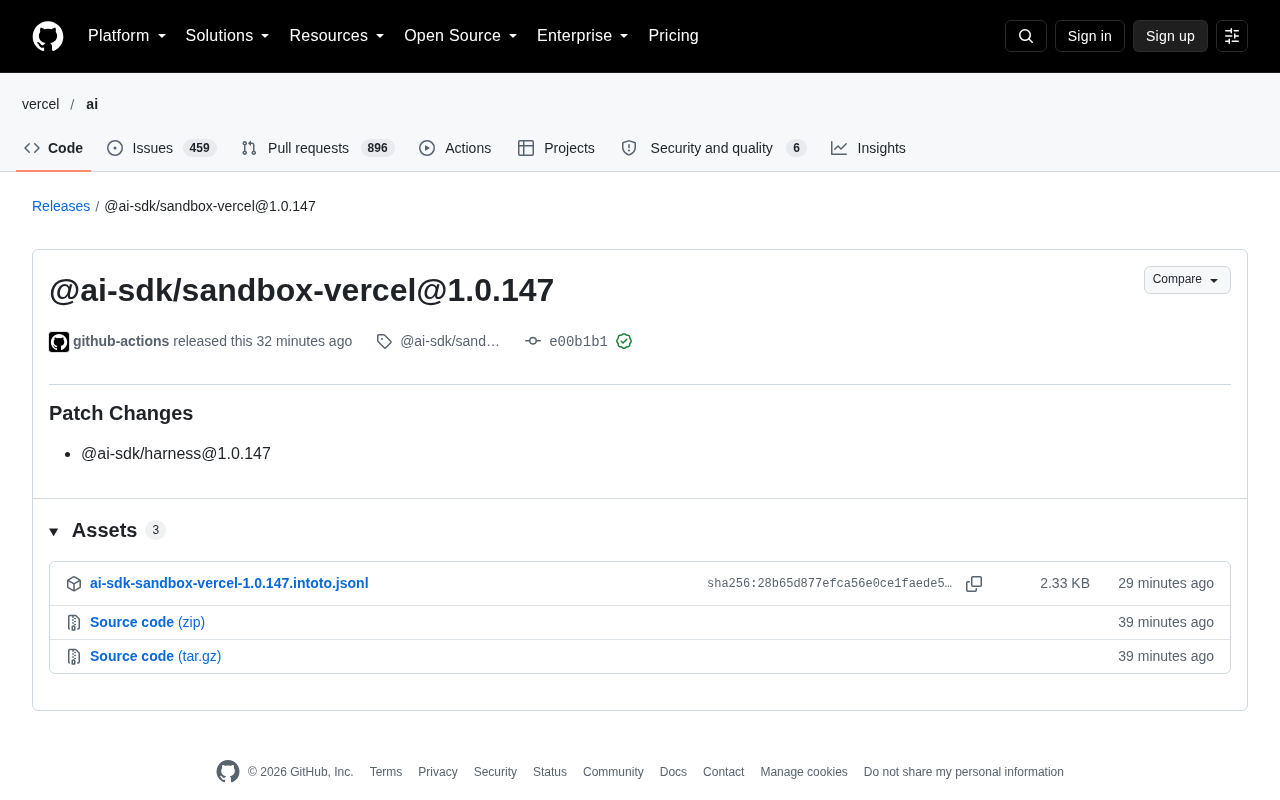
@ai-sdk/sandbox-vercel 1.0.147 发布说明
@ai-sdk/sandbox-vercel 1.0.147 版本发布,这是一次补丁级更新,主要同步升级内部依赖 @ai-sdk/harness 至相同版本,通过 GitHub 可信签名验证。
ChatGPT洗碗记:一支叉子引发的AI过度推理反思
一支洗碗机没洗净的叉子,引发AI启动"深度研究"、消耗海量算力甚至挑战纳维-斯托克斯千禧难题的荒诞实验。这则ChatGPT洗碗讽刺视频,折射出AI过度推理、算力成本与场景错配的真实困境。