本地部署DeepSeek全攻略:联网+知识库+RAG架构详解
为什么要本地部署大模型
使用在线AI服务固然方便,但数据隐私、内容审查、使用成本和网络依赖始终是绕不开的问题。随着欧盟《通用数据保护条例》(GDPR)、中国《个人信息保护法》等法规的严格实施,企业在使用在线AI服务时面临的合规风险日益增大。将敏感数据发送至第三方云端API不仅存在数据泄露风险,还可能因数据跨境传输而触发法律问题。本地部署大模型可以从根本上解决这些痛点:数据不离本机、无需付费订阅、支持离线运行、低延迟响应,还能接入自定义知识库。对于处理企业内部资料或敏感个人数据的场景——尤其是金融、医疗、法律等对数据安全要求极高的行业——这套方案尤其值得考虑。
不过本地部署有一个客观局限:普通消费级硬件无法运行 DeepSeek 的满血版(671B 参数的完整模型)。实际可部署的是蒸馏版,参数量从 1.5B 到 70B 不等。所谓蒸馏,是指通过知识蒸馏技术将大模型的能力迁移至更小的模型,在大幅降低硬件需求的同时保留较高性能。知识蒸馏(Knowledge Distillation)最早由 Geoffrey Hinton 等人在 2015 年提出,核心思想是让一个小型的"学生模型"学习大型"教师模型"的输出分布,而非直接学习原始训练数据。教师模型在推理时产生的"软标签"包含了丰富的类间关系信息,学生模型通过学习这种概率分布,能捕获大量隐含知识。在大语言模型领域,蒸馏通常还结合了中间层特征对齐、注意力模式迁移等更精细的技术手段,使得参数量缩小数十倍的学生模型依然能保持相当的语言理解和推理能力。
DeepSeek-R1 的蒸馏版基于多个不同的基座模型架构,包括 Qwen 和 LLaMA 系列。例如 DeepSeek-R1-Distill-Qwen-32B 以 Qwen-2.5-32B 为基座,通过从完整的 671B MoE(Mixture of Experts,混合专家)架构模型中蒸馏知识而来。MoE 架构的特点是模型虽然总参数量巨大,但每次推理只激活其中一部分专家网络,这使得蒸馏过程能够有针对性地提取不同专家的专长知识。基准测试结果显示,该模型在 AIME 2024(数学推理)、MATH-500、LiveCodeBench(代码生成)等任务上表现出色,在多数场景下与 GPT-4o 和 DeepSeek V3 相当,部分指标甚至超越了同期的 OpenAI o1-mini——对于本地运行来说,这个性价比相当可观。
用 Ollama 搭建本地模型运行环境
Ollama 是目前最主流的本地大模型运行框架,专为在消费级硬件上部署和运行大模型设计,与绝大多数本地 AI 工具生态兼容良好。截至目前,DeepSeek 系列模型在 Ollama 上的下载量已接近 1300 万次,是平台上最热门的模型之一。
Ollama 底层基于 llama.cpp 项目构建,后者是将 Meta 的 LLaMA 模型用纯 C/C++ 重新实现的推理引擎,支持在 CPU 上高效运行量化后的大语言模型。llama.cpp 项目由 Georgi Gerganov 于 2023 年发起,其核心贡献是实现了 GGUF(GPT-Generated Unified Format)模型格式,支持多种量化精度方案。量化(Quantization)是指将模型权重从 32 位或 16 位浮点数压缩为 4 位甚至 2 位整数表示,以大幅减少内存占用和计算量,代价是精度的轻微损失。常见的量化级别包括 Q4_K_M(4位量化,中等精度)、Q5_K_M(5位量化)和 Q8_0(8位量化)等。以一个 7B 参数模型为例,FP16(16位浮点)格式需要约 14GB 内存,而 Q4_K_M 量化后仅需约 4.5GB,内存占用降低近 70%,而在多数基准测试中困惑度(Perplexity)的增加通常不超过 1-2%。Ollama 默认使用 Q4_K_M 量化方案,在内存占用和输出质量之间取得了较好的平衡。
Ollama 在此基础上封装了模型管理、API 服务、GPU 加速调度等功能,使用户无需手动处理模型格式转换、显存分配等底层细节。其本地 API 服务遵循 OpenAI 兼容格式,这意味着大量为 OpenAI API 开发的第三方工具可以几乎零成本地切换到本地模型。
安装过程非常简单:访问 Ollama 官网下载对应操作系统的安装包,双击安装后在终端执行以下命令验证安装:
ollama --version
安装成功后,Ollama 会在本地监听 11434 端口。随后即可用一条命令下载并运行模型:
ollama run deepseek-r1:7b
模型名称中的 7b 代表参数量为 70 亿,是入门硬件的推荐选择。Ollama 官网的模型列表页列出了各版本所需的磁盘空间,选型前可先对照自己的存储容量。
用 ChatBot UI 提升交互体验
纯命令行的交互方式对日常使用不够友好。目前做得比较好的本地 AI 客户端是 ChatBot UI,这是一个开源的前端界面,GitHub 上已有超过 29K Star,支持接入本地部署模型和各类云端 API,跨平台兼容性也不错。
配置方式:下载安装后,在设置中将模型提供商选为 Ollama,API 域名填写本地地址 http://localhost:11434,工具会自动识别已安装的模型列表。这样就获得了一个体验接近 ChatGPT 的本地对话界面。
值得一提的是,通过 ChatBot UI 结合 Groq 的 API,也可以很方便地体验满血版 DeepSeek R1。Groq 之所以能提供极快的大模型推理速度,源于其自研的 LPU(Language Processing Unit)芯片架构。与 GPU 的大规模并行计算不同,LPU 采用确定性的时序流架构(Temporal Instruction Set Computer),专门针对大语言模型推理中的顺序 Token 生成过程进行优化。传统 GPU(如 NVIDIA 的 A100、H100)在大模型推理时面临的核心瓶颈是内存带宽:自回归生成过程中每生成一个 Token 都需要从 HBM(高带宽内存)中加载完整的 KV Cache(键值缓存),而 GPU 的计算单元大部分时间在等待数据加载,实际计算利用率很低(通常不到 5%)。Groq 的 LPU 通过将模型权重和中间状态完全放置在片上 SRAM 中,配合确定性的指令调度机制,消除了外部内存访问的延迟。每块 LPU 芯片集成了约 230MB 的 SRAM,多块芯片通过高速互联组成推理集群,从而在 Token 生成速度上实现了相比 GPU 方案 10 倍以上的提升(不过 LPU 目前主要面向推理场景,不具备训练能力)。Groq 提供一定的免费额度,超出后需付费,适合偶尔需要完整版能力的场景,也可以作为本地蒸馏模型能力不足时的有效补充。
为本地模型添加联网搜索能力
ChatBot UI 内置了联网功能,但目前仅支持部分模型。要让本地 Ollama 模型具备稳定的联网搜索能力,推荐使用浏览器插件 Page Assist。
Page Assist 是一个开源浏览器插件,原本用于为本地 AI 提供交互界面,但其最大亮点是对联网搜索的原生支持。所有交互均在本地完成,不向外部服务传输任何数据,隐私安全有保障。
安装完成后点击插件图标,它会自动检测正在运行的 Ollama 实例及已安装模型。对话框底部有一个地球图标,点击即可开启联网搜索模式。实测效果正常,可以检索实时信息并结合本地模型生成回答。
RAG 架构与本地知识库的核心原理
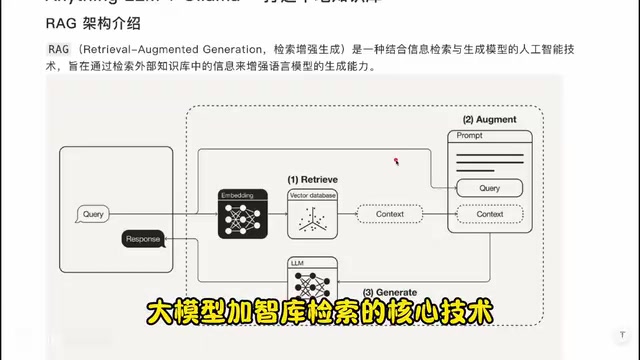
在接入本地知识库之前,有必要理解背后的技术架构——RAG(Retrieval-Augmented Generation,检索增强生成)。这是目前让 AI 精准回答特定领域问题的主流方案。
RAG 的工作流程可以类比为三步:找资料 → 整理资料 → 回答问题。
- 检索(Retrieval):用户提问后,系统通过 Embedding 模型将问题转换为向量,再在向量数据库中检索语义最相近的文档片段。
- 增强(Augmentation):将检索到的相关文档片段作为上下文,连同原始问题一起输入到大模型。
- 生成(Generation):大模型基于整合后的上下文生成准确、连贯的回答。
需要注意的是,RAG 并非让大模型"学习"新知识,而是在推理时动态提供外部信息作为参考上下文。这与另一种常见方案——微调(Fine-tuning)有本质区别。微调是通过在特定领域数据上继续训练模型,将知识"写入"模型权重,优点是推理时无需额外检索步骤,缺点是训练成本高、知识更新困难且容易出现灾难性遗忘(Catastrophic Forgetting)。灾难性遗忘是指模型在新数据上微调后,会显著降低对原始训练数据中学到的知识的记忆能力。为缓解这一问题,业界发展出了 LoRA(Low-Rank Adaptation)和 QLoRA 等参数高效微调(PEFT)方法,它们只更新模型参数的一个低秩子空间,冻结绝大部分原始权重,从而在降低训练成本的同时减轻遗忘问题。
RAG 的优势在于知识库可以随时更新、来源可追溯、不需要重新训练模型,但受限于上下文窗口长度,单次能注入的参考信息量有限。此外,当 RAG 注入过多上下文时,还会出现"Lost in the Middle"现象——模型对位于上下文中间位置的信息关注度下降,检索精度因此受限。工程实践中常用的优化手段包括:文档分块策略(控制 chunk size 和 overlap)、重排序(Reranking,在初步检索结果上用交叉编码器精排)、以及混合检索(同时使用关键词检索和向量检索,取并集或加权融合)。在实际生产环境中,微调和 RAG 往往结合使用:用微调让模型掌握特定领域的语言风格和基础知识,再用 RAG 补充最新的、细粒度的事实信息。
其中有两个关键概念需要深入理解:
Embedding 模型负责将文本转换为机器可理解的数字向量(语义相近的词在向量空间中距离更近,例如"苹果"和"水果"的距离远近于"苹果"和"汽车")。Embedding 模型的核心任务是将人类语言映射到高维向量空间(通常为 384 到 4096 维),这一过程基于 Transformer 架构的编码器,通过在海量文本对上进行对比学习(Contrastive Learning)训练而成。对比学习的核心框架(如 SimCSE 和 E5 系列方法)通过将语义相似的文本对(正例)在向量空间中拉近、将语义无关的文本对(负例)推远来学习有效的语义表示。
向量数据库则负责高效存储和检索这些向量。在向量检索领域,精确的最近邻搜索(暴力搜索)在数据量增大时计算成本呈线性增长,因此实际生产中普遍采用近似最近邻(ANN)算法。HNSW(Hierarchical Navigable Small World)算法构建一个多层的图结构,每层是前一层的稀疏子图,检索时从最顶层开始逐层向下搜索,复杂度为 O(log N),在召回率和速度之间表现优秀,是目前最流行的 ANN 方法之一。IVF(Inverted File Index)则先将向量空间用聚类算法划分为多个 Voronoi 区域,检索时只需扫描查询向量所在区域及相邻区域,适合超大规模数据集。这些算法能在百万甚至亿级向量中以毫秒级速度找到最相似的结果。LanceDB 基于 Lance 列式存储格式构建,采用磁盘索引(DiskANN)技术,与 Milvus、Pinecone 等需要独立服务进程的向量数据库不同,它以嵌入式库的形式运行,零依赖、零配置,数据以 Arrow 格式存储在本地文件中,无需独立的数据库服务进程,这也是它特别适合本地部署和个人知识库等不需要分布式部署场景的重要原因。
用 AnythingLLM 搭建本地知识库系统
AnythingLLM 是一款基于 RAG 架构的本地知识库工具,支持将文档、网页等数据源与本地大模型结合,构建个性化的知识问答系统。
初始配置
从官网下载安装后,首次启动需要依次配置:
- 选择大模型:选择 Ollama,工具会自动读取本地已安装的模型。
- 选择 Embedding 模型:Embedding 模型的质量直接决定知识库检索的准确度。OpenAI 的 text-embedding-3 系列目前综合表现最强,其 text-embedding-3-large 输出 3072 维向量,因训练语料覆盖数百种语言的大规模平行文本,在多语言场景尤其是中文语义检索中表现显著优于开源小模型,但需要联网和付费。免费离线方案可选默认的
all-minilm系列(如 all-MiniLM-L6-v2,基于 6 层 Transformer 编码器,输出 384 维向量,体积仅约 80MB),在英文场景下已具备不错的检索能力,在 MTEB(Massive Text Embedding Benchmark)英文排行榜上位于中游水平,准确度略逊但完全满足日常使用。对于中文知识库场景,还可以考虑专门针对中文优化的开源模型如 bge-large-zh-v1.5 或 m3e-large,它们在中文检索任务上的表现通常优于通用多语言模型。 - 选择向量数据库:默认的 LanceDB 完全本地运行且免费,是推荐选项。
- 创建工作区(Workspace):每个工作区拥有独立的知识库和设置,可以为不同项目或领域分别维护。
知识库的构建建议
AnythingLLM 支持多种数据格式:纯文本(TXT、Markdown)、格式化文档(PDF、Word)、结构化数据(CSV、JSON),以及直接粘贴网页 URL。
知识库的结构质量对最终回答效果影响很大。非结构化的网页内容不利于模型检索,建议先在本地将原始资料整理成层次清晰、易于检索的 Markdown 格式,再上传至工作区。实测将结构化的 Markdown 知识库上传后,模型可以精准检索并回答其中的具体数据(如商品价格等字段级信息)。
Agent 能力扩展
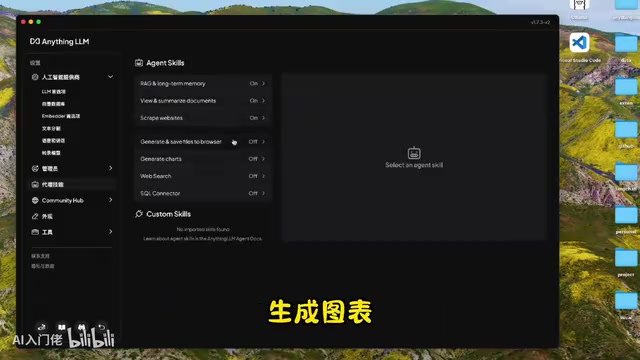
AnythingLLM 还内置了较完善的 Agent 体系,可在设置中开启:网页深度抓取、图表分析、数据库连接,以及 Web 搜索 Agent。搜索引擎方面,DuckDuckGo 和 SearXNG 均免费可用,效果不及付费的 Google 或 Bing API,但用于测试足够。在对话框中输入 @ 即可唤起 Agent 能力。
通过 API 实现灵活集成
AnythingLLM 提供完整的 REST API,这是整套方案从"可用"迈向"可扩展"的关键一步。REST(Representational State Transfer)API 是一种基于 HTTP 协议的无状态接口规范,其资源导向的设计风格使其成为 Web 服务间通信的事实标准。通过 API,可以将本地知识库能力集成到任意业务系统中,例如私人知识管理工具、企业内部问答机器人、自动化文档处理流水线等。
在实际工程中,常见的集成模式包括:通过 Webhook 将企业 IM(如飞书、Slack)的消息转发至 AnythingLLM 的聊天接口,实现内部问答机器人(当用户在 IM 中发送消息时,平台会向预配置的 URL 发送 HTTP POST 请求,中间层服务解析消息后调用 AnythingLLM 的聊天接口获取回答,再通过 IM 的回复接口推送结果给用户);利用定时任务脚本批量处理文档并将结果写入数据库;或者在 CI/CD 流水线中嵌入代码审查环节,让本地模型自动分析代码变更。
API 调用涉及两个核心概念:
- Workspace Slug:工作区的唯一标识符,通过
GET /api/v1/workspaces接口获取。 - Thread Slug:工作区下具体对话线程的唯一标识符。
核心聊天接口为 POST /api/v1/workspace/{slug}/thread/{threadSlug}/chat,主要参数包括消息内容和响应模式(chat 或 query)。AnythingLLM 的 API 通过 Bearer Token 进行身份认证,支持 JSON 格式的请求和响应。接口返回值包含模型的完整回答、检索到的知识库上下文片段(sources),以及本次调用的元数据。返回的知识库上下文片段尤其重要,它提供了回答的溯源依据,这在合规性要求较高的企业场景中是刚需——用户不仅能看到 AI 的回答,还能直接跳转到原始文档验证信息的准确性。对于需要流式输出的场景,AnythingLLM 也支持 Server-Sent Events(SSE)模式,允许模型逐 Token 返回结果,避免用户在等待长回答时看到空白页面。以下是一个基础的 cURL 调用示例:
curl -X POST "http://localhost:3001/api/v1/workspace/{workspace-slug}/thread/{thread-slug}/chat" \\\\\\\\
  -H "Authorization: Bearer YOUR_API_KEY" \\\\\\\\
  -H "Content-Type: application/json" \\\\\\\\
  -d '{"message": "你的问题", "mode": "chat"}'
API 文档内置在 AnythingLLM 的设置面板中,支持在线测试调用,方便快速上手。
总结
这套本地 AI 部署方案的完整链路是:Ollama 提供模型运行环境 → ChatBot UI 或 Page Assist 负责交互界面和联网能力 → AnythingLLM 实现 RAG 知识库检索 → REST API 支持自定义集成开发。整个过程无需任何云端服务,数据完全在本地流转。
对于硬件配置有限的用户,7B 到 14B 参数的蒸馏模型是性价比最高的起点;有条件的话,32B 模型在多数场景下的表现已经相当接近在线服务的水准。Embedding 模型的选择对知识库检索质量影响显著,如果对准确度有较高要求,OpenAI 的 Embedding API 值得单独接入;如果是中文为主的知识库,bge-large-zh-v1.5 或 m3e-large 等专门优化的开源模型也是不错的免费替代方案。
相关推荐
MiniMax H3 开源视频模型本地部署实测:8G显存即可玩转
MiniMax H3 最新开源视频生成模型本地部署实测教程,支持文生视频、图生视频与首尾帧控制。8G显存即可运行,含ComfyUI部署流程、量化版本选择与实际应用效果分析。
LTX2.5开源本地部署实测:AMD显卡最低8G显存跑视频生成
开源视频生成模型 LTX2.5 本地部署实测:AMD 7900XTX 显卡在 Windows 11 环境下最低 8G 显存可运行,2 分钟生成 5 秒视频。附五套工作流对比与整合包、手动部署教程。
ComfyUI双语提示词节点实测:不懂英文也能玩转标签
一位B站UP主借助GPT打造的ComfyUI双语标签提示词拓展节点实测:中英标签双向联动、30万词库支持、未知标签一键翻译沉淀,让不懂英文的小白也能玩转提示词,目前适配anima本地部署模型。