本地部署无审查大模型:Ollama选型与硬件配置实战指南

为何越来越多人转向本地无审查模型
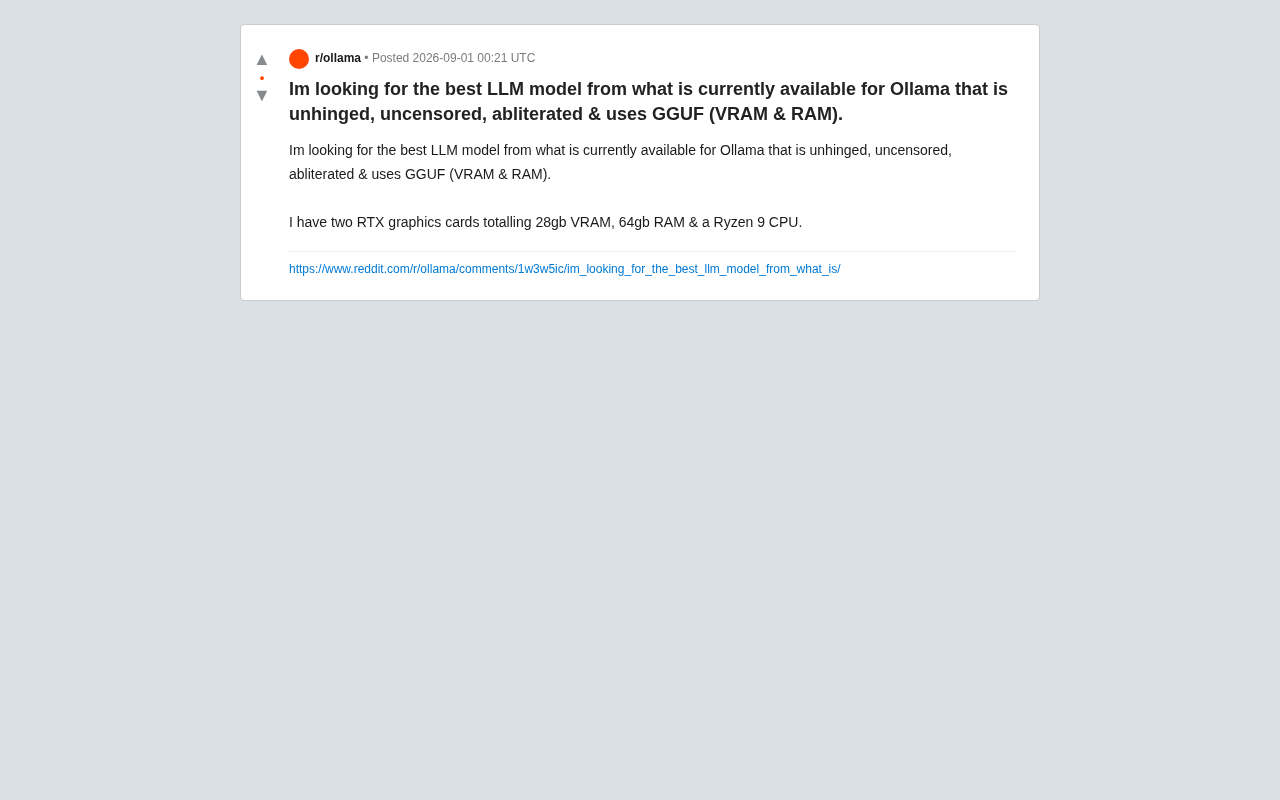
随着大语言模型(LLM)的普及,云端服务的内容审查限制正引发越来越多讨论。在 Reddit 的本地部署社区中,一位硬件配置强大的用户提出了一个极具代表性的问题:如何在 Ollama 上找到当前最好的、无审查(uncensored)、经过 abliterated 处理并支持 GGUF 格式的开源大模型?
这位用户的配置相当硬核——两块 RTX 显卡合计 28GB 显存、64GB 内存加上一颗 Ryzen 9 处理器,足以驾驭相当规模的本地模型。问题背后,折射出一个快速增长的真实需求:越来越多用户希望摆脱云端 API 的内容限制,在自己的机器上获得完全可控、可定制的 AI 能力。
关键术语解析:Uncensored与Abliterated
什么是无审查(Uncensored)模型
主流开源模型(如 Llama、Mistral 等)在发布时通常经过了安全对齐(safety alignment),遇到敏感或边缘话题会拒绝回答或给出模板化的"我不能帮助你"回复。所谓 uncensored 模型,是通过微调(fine-tuning)移除了这些拒绝行为的版本,让模型能够更自由地回应各类请求。
安全对齐是当前大模型开发流程中的核心环节,通常包括 RLHF(基于人类反馈的强化学习)和 DPO(直接偏好优化)等技术。OpenAI、Meta、Google 等公司在发布模型前,会通过大量人工标注的偏好数据训练一个奖励模型,引导 LLM 拒绝生成有害、违法或不道德的内容。具体而言,RLHF 需要先训练一个独立的奖励模型来评估生成内容的质量和安全性,然后通过 PPO(Proximal Policy Optimization)等策略优化算法迭代更新 LLM 参数,整个流程复杂且训练过程容易不稳定。DPO 则由斯坦福团队于 2023 年提出,直接从人类偏好数据中推导出最优策略的闭式解,绕过了奖励模型的训练步骤,大幅降低了对齐的计算成本和工程复杂度。值得注意的是,用 DPO 对齐的模型由于其对齐机制的相对简单性,可能更容易被逆向工程去除对齐效果——这也间接推动了社区去审查实践的发展。
这一过程虽然提升了模型的安全性,但也带来了"过度对齐"问题——模型可能在完全合理的请求上也表现出过度谨慎,例如拒绝讨论历史战争细节、医学知识或虚构场景中的冲突情节,这正是催生无审查模型需求的重要原因。
安全对齐的核心矛盾在于"安全"与"有用"之间的张力。Anthropic 在其研究中将这一问题形式化为 HHH 框架——Helpful(有用)、Honest(诚实)、Harmless(无害),三者之间存在天然冲突。例如,一个完全无害的模型可能选择对所有敏感话题保持沉默,但这显然损害了有用性。Meta 在发布 Llama 2 时的安全报告中也承认,其安全微调导致模型在某些基准测试上的得分出现下降。这种"对齐税"(alignment tax)正是推动社区探索无审查替代方案的技术动因。
Abliteration 技术是什么
Abliteration 是一种更精巧的去审查技术。与传统重新微调不同,它通过识别并抑制模型内部负责"拒绝行为"的特定方向向量(refusal direction),在不显著损害模型整体能力的前提下去除其拒绝倾向。
具体而言,Abliteration 的理论基础来自对 Transformer 模型内部表征空间的研究。Transformer 的架构设计中,每一层的输出是注意力子层和前馈子层的增量叠加到残差流(residual stream)上——这种"恒等映射+增量修改"的结构使得高层语义概念在残差流空间中呈现出近似线性的编码方式。研究者发现,模型的拒绝行为并非分散在整个参数空间中,而是集中在残差流中的一个特定方向向量上。通过收集模型产生拒绝回复和正常回复时的激活值,可以用主成分分析(PCA)或差异均值方法提取出这个"拒绝方向"。随后,对模型每一层的权重矩阵进行正交投影,将该方向分量消除——这在数学上类似于在高维空间中将一个向量投影到某个超平面上,从而"擦除"其在拒绝方向上的信息分量。整个过程无需重新训练模型,即可移除拒绝行为。这一技术最早由 failspy 等社区研究者在 2024 年推广开来,其灵感部分源自 Representation Engineering 领域的研究成果。
Abliteration 的学术基础可以追溯到 2023 年由 Dan Hendrycks 团队发表的 Representation Engineering(RepE)论文。该研究证明,大语言模型的高层概念(如诚实、权力欲望、道德判断)在其内部表征空间中以线性方向的形式编码。这意味着可以通过简单的线性代数操作来"读取"甚至"编辑"模型的行为特征。Abliteration 正是将这一发现应用于拒绝行为的实践案例。后续研究者还将类似技术应用于控制模型的情感倾向、写作风格等特征,形成了所谓的"激活工程"(activation engineering)这一新兴研究方向。这一方向的兴起标志着对 LLM 行为的控制正从粗粒度的训练调参转向精细的内部表征操控。
这种方法有三大优势:
- 保留原始能力:相比大规模微调,abliteration 对模型的知识和推理能力破坏更小,高质量的处理通常能将性能损失控制在 1-2 个百分点以内
- 计算成本低:无需完整的重新训练,仅需对权重矩阵进行线性代数运算,普通消费级 GPU 即可在数分钟内完成
- 效果精准:直接作用于"拒绝"这一特定行为模式,而非粗暴地改变模型整体行为分布
目前 Hugging Face 上有大量社区开发者(如 mradermacher、bartowski 等量化贡献者,以及 failspy 等 abliteration 技术的推动者)发布了各类经过处理的模型版本。
GGUF格式与硬件适配方案
为什么选择 GGUF 格式
GGUF(GPT-Generated Unified Format)是 llama.cpp 生态推出的模型量化格式,也是 Ollama 底层支持的核心格式。它由 llama.cpp 项目创始人 Georgi Gerganov 于 2023 年推出,取代了早期的 GGML 格式。相比前身,GGUF 采用了键值对元数据结构,具备更好的前向兼容性和可扩展性,支持在文件中嵌入分词器信息、模型架构参数等完整元数据,使得单个文件即可完整描述一个可运行的模型。
llama.cpp 项目始于 2023 年 3 月 Georgi Gerganov 的一次实验性尝试——用纯 C/C++ 实现 LLaMA 模型的推理,最初的目标仅仅是在 MacBook 上运行。这个项目迅速发展为本地 LLM 推理的基础设施,支持几乎所有主流开源模型架构(包括 LLaMA、Mistral、Qwen、Phi、Gemma 等数十种架构)。围绕 GGUF 格式形成了一个庞大的量化贡献者社区,其中 bartowski 和 mradermacher 是两位最活跃的量化发布者。bartowski 以其严格的量化质量验证流程著称,通常会对每个量化版本运行困惑度(perplexity)测试以确保质量;mradermacher 则以覆盖面广、更新速度快见长,几乎在每个新模型发布后数小时内就能提供全系列量化版本。
GGUF 最大的优势在于灵活的量化选项和CPU/GPU 混合推理能力——即使模型大小超过显存容量,也可以将部分层卸载到系统内存中运行。在量化方面,GGUF 支持从 2-bit 到 8-bit 的多种混合量化策略,其中 K-quant 系列(如 Q4_K_M)使用了基于重要性的混合精度量化。K-quant 的核心思想是不同层对量化误差的敏感度存在显著差异:注意力层中的 QKV 投影矩阵直接影响模型"关注什么"的决策,量化误差对其影响更大;而前馈网络(FFN)层的中间维度通常具有更好的冗余性和鲁棒性。因此 Q4_K_M 中的"M"表示 medium(中等质量),意味着在注意力层使用 Q6 精度、在 FFN 层使用 Q4 精度的混合策略,比统一使用 Q4 精度(如 Q4_0 或 Q4_1)能获得显著更低的困惑度(perplexity)分数,即更好的输出质量。
常见的量化等级对比:
- Q4_K_M:平衡质量与体积的主流选择,约为原始模型的 1/4 大小
- Q5_K_M / Q6_K:更高质量,体积略大,适合对输出质量有更高要求的场景
- Q8_0:接近无损,但体积较大,适合显存充裕的配置
28GB 显存的模型选型建议
以 28GB 显存 + 64GB 内存的配置为例,可选择的空间相当宽泛:
| 模型规模 | 推荐量化 | 是否全部载入显存 |
|---|---|---|
| 8B 级别 | Q6_K / Q8_0 | 轻松全载入 |
| 32B 级别 | Q4_K_M / Q5_K_M | 可全载入或接近 |
| 70B 级别 | Q4_K_M | 需 GPU+RAM 混合推理 |
需要特别注意的是,该用户的 28GB 显存来自两块 RTX 显卡而非单卡。llama.cpp 和 Ollama 支持将模型层分布在多块 GPU 上进行推理(即张量并行,Tensor Parallelism),但两块显卡之间的数据传输会引入额外延迟。NVLink 是 NVIDIA 专为 GPU 间高速通信设计的互联技术,在专业卡(如 A100)上可提供 600 GB/s 的双向带宽,但消费级 RTX 40 系列显卡已取消 NVLink 支持,只能通过 PCIe 总线通信。PCIe 4.0 x16 的理论带宽为 32 GB/s,PCIe 5.0 翻倍至 64 GB/s,但在推理场景下,每生成一个 token 都需要多次跨卡同步中间激活值,PCIe 的延迟和带宽瓶颈会导致双卡性能远低于理论上的线性扩展。因此在实践中,两块 14GB 显卡的实际推理性能通常不如单块 28GB 显卡。用户在选择模型和量化等级时,需要考虑层在不同 GPU 之间的分配策略,尽量减少跨卡通信的频率。
对于 70B 级别的大模型(如 Llama 3.3 70B 的 abliterated 版本),28GB 显存无法完全容纳 Q4 量化版本(约需 40GB+),此时 GGUF 的混合推理能力就派上用场——将部分层放在显存、部分放在内存中,虽然推理速度会有所下降,但依然可用。
混合推理(也称部分卸载,partial offloading)是 llama.cpp 和 Ollama 的核心特性之一。Transformer 模型由多个层堆叠而成(例如 Llama 3 70B 有 80 层),混合推理允许用户指定将前 N 层加载到 GPU 显存中运行,剩余层则留在系统内存中由 CPU 处理。GPU 处理的层享受并行计算加速,而 CPU 处理的层则受限于内存带宽。以 DDR5-4800 内存为例,其带宽约为 38.4 GB/s,而 RTX 4090 的显存带宽高达 1 TB/s,差距约 26 倍。因此实际推理速度取决于 GPU 卸载比例——GPU 承担的层越多,整体推理速度越快。这也解释了为什么 28GB 显存在运行 70B 模型时虽然可行但每秒生成的 token 数会明显下降——瓶颈出现在 CPU 处理那些未被卸载到 GPU 的层时,内存带宽成为了推理速度的决定性因素。
此外还需要考虑 KV Cache 的显存开销。KV Cache(Key-Value Cache)是 Transformer 模型自回归推理的核心优化机制——在生成每个新 token 时,模型需要对所有之前的 token 计算注意力,KV Cache 将已计算过的 Key 和 Value 矩阵缓存起来避免重复计算。但其代价是内存占用随上下文长度线性增长,且与模型层数和注意力头数成正比。以一个 70B 模型为例,8K 上下文的 KV Cache 可能占用约 2-4GB 显存,而扩展到 128K 上下文时这一数字可能飙升至 30GB 以上,甚至超过模型权重本身的显存占用。这也是为什么社区中出现了 GQA(分组查询注意力)和量化 KV Cache 等优化技术的重要原因。
GQA(Grouped-Query Attention)由 Google 在 2023 年的 PaLM 2 论文中正式提出,其核心思想是将多个 Query 头共享同一组 Key-Value 头。传统的多头注意力(MHA)中每个注意力头都有独立的 Key 和 Value 矩阵,导致 KV Cache 随头数线性增长。例如 Llama 3 的 70B 模型使用 8 个 KV 头服务 64 个 Query 头,将 KV Cache 大小缩减到 MHA 方案的 1/8。这一技术使得大模型在长上下文场景下的显存压力大幅降低,已成为当前几乎所有主流大模型(包括 Llama 3、Mistral、Qwen 2.5 等)的标配架构选择。此外,llama.cpp 还支持对 KV Cache 本身进行量化(如使用 FP16 或 Q8 精度存储 KV 值),进一步压缩其内存占用。
值得关注的无审查模型推荐
虽然"最好"的答案永远在变化,但根据社区普遍共识,以下几类模型值得重点关注:
主流基座的 Abliterated 版本
基于 Llama 3.x、Qwen 2.5、Mistral 等强力基座的 abliterated 版本,通常能在保持高智能水平的同时提供无审查体验。这类模型在 Hugging Face 上以 -abliterated 或 -uncensored 命名后缀标识,搜索时可据此筛选。选择基座模型时,可参考 Open LLM Leaderboard 等公开评测榜单上的基准分数,优先选择在核心测试集上表现优异的基座,再寻找对应的 abliterated 版本。
主要的评测基准各有侧重:MMLU(Massive Multitask Language Understanding)测试模型在 57 个学科上的知识广度,涵盖从人文到 STEM 的广泛领域;HumanEval 评估代码生成能力,包含 164 个 Python 编程题;GSM8K 测试数学推理能力,包含 8500 道小学数学应用题,要求模型展现多步推理能力。2024 年 HuggingFace 推出了 Leaderboard v2,引入更具挑战性的基准如 MUSR(多步推理)、BBH(BIG-Bench Hard)等,以更好地区分能力日益接近的新一代模型。需要注意的是,abliterated 版本在这些基准上的得分可能与原始版本略有差异,但高质量的 abliteration 处理通常能将性能损失控制在 1-2 个百分点以内。
专门的社区微调模型
一些社区团队(如 Dolphin 系列、Nous Research 的部分模型)专注于打造"更听话"、更少拒绝的模型版本。Dolphin 系列长期以来是无审查本地模型的标杆之一,其设计理念强调对用户指令的高度服从性。
Dolphin 由 Eric Hartford(ehartford)主导开发,自 2023 年起持续迭代。Hartford 提出了"模型不应该有自己的价值观"这一理念,认为 AI 应该像一把工具一样服从用户指令,道德判断应由使用者而非模型来承担。Dolphin 系列的制作方法是使用经过清洗的数据集——从训练数据中系统性地移除所有包含对齐拒绝模式的样本(例如"作为一个AI,我不能..."这类回复模板),然后在此基础上进行监督微调。这与 abliteration 的权重编辑方法形成互补:Dolphin 是数据层面的去审查,abliteration 是模型内部表征层面的去审查。两种方法也可以叠加使用——先用 Dolphin 的清洗数据集微调,再进行 abliteration 处理——进一步增强去审查效果。Nous Research 则是另一个值得关注的社区组织,其 Hermes 系列模型同样强调指令遵循能力,并在函数调用、结构化输出等方面进行了额外优化。
选择时的实用建议
- 明确使用场景:不同模型在创意写作、角色扮演、代码生成、逻辑推理等任务上各有侧重
- 关注量化来源:优先选择 bartowski、mradermacher 等信誉良好的量化发布者,这些贡献者通常会严格验证量化后模型的输出质量
- 下载实测对比:同样标称"uncensored"的模型,实际去审查程度和智能水平差异可能很大,建议多下几个对比测试
- 注意上下文长度:大上下文窗口会显著增加显存和内存占用,需根据硬件情况合理设置。例如 Llama 3 支持 8K 默认上下文,扩展到 128K 时 KV Cache 的内存占用会增长数倍
Ollama部署实践与注意事项
在 Ollama 中运行自定义 GGUF 模型
Ollama 是一个面向本地 LLM 部署的开源运行时工具,底层基于 llama.cpp 构建,提供了类似 Docker 的模型管理体验。用户可以通过简单的命令行操作完成模型的下载、运行和管理,同时 Ollama 暴露了兼容 OpenAI 格式的 REST API 接口,使其能够无缝对接 Open WebUI、Continue、Chatbox 等众多第三方前端和开发工具。截至 2024 年底,Ollama 已成为本地 LLM 部署的事实标准工具之一,GitHub 星标超过 10 万。与同类工具(如 LM Studio、GPT4All、text-generation-webui 等)相比,Ollama 的核心优势在于其极简的命令行界面和 API 优先的设计哲学,特别适合开发者和需要将本地 LLM 集成到工作流中的技术用户。
Ollama 官方模型库已包含部分 uncensored 模型,可通过 ollama pull 直接获取。对于库中没有的 Hugging Face GGUF 文件,可以通过创建 Modelfile 方式导入:
FROM ./model-name.Q4_K_M.gguf
Modelfile 的设计借鉴了 Dockerfile 的思路,除了指定模型文件外,还可以定义系统提示词、温度参数、上下文长度、GPU 卸载层数等运行时配置。例如:
FROM ./model-name.Q4_K_M.gguf
PARAMETER temperature 0.7
PARAMETER num_ctx 8192
SYSTEM "You are a helpful assistant."
然后执行 ollama create 命令即可在本地注册并使用,极大降低了自定义模型的使用门槛。对于需要更精细控制的高级用户,还可以通过 PARAMETER num_gpu 指定 GPU 卸载层数以优化混合推理性能,或通过 PARAMETER repeat_penalty 等参数调节生成质量。
合规与伦理提醒
需要特别强调的是,无审查模型的使用应当遵守当地法律法规和平台规则。这类模型移除了安全防护机制,用户需要对生成内容承担完全责任。本地部署带来自由的同时,也意味着更高的自律要求。在企业或团队环境中使用时,建议建立内部使用规范,并考虑在应用层面添加必要的内容过滤机制——例如通过部署独立的内容安全分类器(如 Llama Guard、OpenAI Moderation API 的本地替代方案等)对模型输出进行二次审核,在保留模型完整能力的同时在应用层面建立安全边界。
总结
对于拥有 28GB 显存这类中高端配置的用户来说,本地部署无审查大模型已经完全可行。核心思路是:选对基座模型(保证智能水平)→ 选对 abliterated/uncensored 版本(实现去审查)→ 选对 GGUF 量化等级(匹配硬件条件)。
随着 abliteration 技术的成熟和量化工具链的完善,本地 LLM 正在从尝鲜玩具走向实用的生产力工具。对于重视隐私保护、需要不受限制的内容生成能力、或希望完全掌控自己 AI 技术栈的用户来说,这条路径值得深入探索。
核心要点
核心要点
核心要点
相关推荐
企业级AI Agent全栈开发实战:从零搭建可上线智能体的学习路径
一份企业级AI Agent全栈开发课程导学解析:涵盖为什么学Agent、适合人群、LangChain与CrewAI框架学习路径,以及从单智能体到多智能体的实战落地方案,助你搭建可上线的智能体应用。
从真实项目拆解AI智能体:基于LangGraph的学习助手架构实践
以真实上线的AI学习助手为例,拆解基于LangGraph、Neo4j知识图谱、Redis与MinIO的智能体架构实践,解析为何面试官偏爱复杂真实项目,以及FDE岗位的求职方向。
LangChain 1.3 入门指南:大模型与Agent核心概念解析
LangChain 1.3入门教程:解析大语言模型的三大局限、框架的统一接口与模块化架构,以及LLM、Agent、DeepAgent与Harness架构的层级关系,助你理解大模型应用开发核心概念。