本地大模型怎么选?四个标准帮你精准对号入座

用参数量、格式量化、上下文、许可证四个硬标准,把开源模型选型变成可执行的筛选漏斗。
面对开源社区海量模型文件,本文提供一套四步筛选框架。第一步用参数量结合显存预算做硬门槛,跑不动的直接排除;第二步区分 Instruct/Chat 对话版与 Base 基座版,避免用错用途;第三步按运行引擎匹配格式——本地 Ollama/LM Studio 认准 GGUF 单文件格式,服务器高并发场景用 AWQ/GPTQ/FP8 配合 vLLM;量化档位不确定就选社区验证的 Q4_K_M。第四步关注上下文长度(按需取舍,越长越耗显存)和许可证(商用认 Apache 2.0/MIT,警惕 Community/Non-Commercial 协议)。四个标准按漏斗顺序执行,即可从海量文件中精准定位目标模型。
面对开源社区里成千上万个模型文件,即便知道去哪里下载,也很容易挑花眼。几十GB的文件下错了,不仅浪费带宽,还可能根本跑不起来。这期我们不靠猜,用四个硬标准把选型变成一道可以执行的筛选题:参数量、格式量化、上下文、许可证。
先学会解剖一个模型文件名
开源模型的命名其实暗藏规律,看懂了就等于掌握了半张地图。一个典型文件名通常由几段信息拼接而成:
- 前缀:出品方和模型代号;
- 参数量标识:比如
8B、7B、72B; - 用途标签:
Instruct或Chat代表对话微调版,不带则是基座版; - 格式与量化信息:决定了用什么引擎跑、精度多高。
其中 B 代表 Billion(十亿),所以 7B 就是 70 亿参数,72B 就是 720 亿参数。拿到参数量这个数字,就能直接代入上一期算过的显存预算公式,判断自己的机器装不装得下。
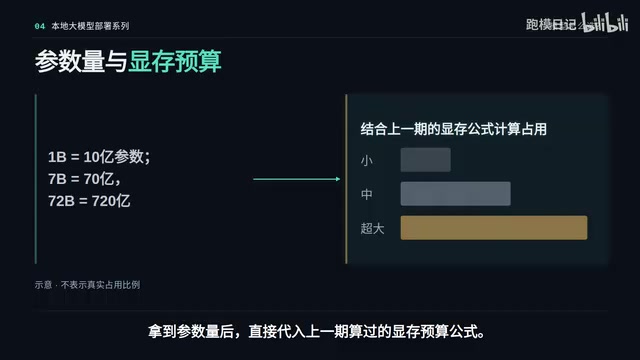
标准一:参数量决定装不装得下
参数量是第一道漏斗,用来快速砍掉大批无关选项。把文件名里的参数量代入显存预算公式,超标的大家伙直接跳过,不用纠结。
如果不小心下了超标模型会怎样?分两种情况:
- 轻微超标:引擎会借用普通内存参与计算,但速度会从每秒十几个字暴跌到几乎逐字蹦,失去实用价值;
- 严重超标:连启动的机会都没有,直接抛出 OOM(内存溢出)报错。
所以这一步不是可选项,而是硬门槛——先把机器跑不动的全部排除,再谈其它。
标准二:选对用途,别让模型显得「弱智」
参数量过关后,第二点是用途。一定要认准带有 Instruct 或 Chat 标签的版本。
这类模型经过指令微调,知道自己是一个助手,会正常理解并回答问题。而不带这些字眼的是 Base 基座版,它没有服务意识,通常只会顺着你的输入做词语接龙,看起来「很弱智」,并不是模型质量差,而是你选错了版本。
一句话记牢:做业务、做对话,认 Instruct/Chat;想二次训练、研究底座,才用 Base。
标准三:格式必须和引擎匹配
这是最硬性的一条,格式选错,引擎根本启动不了。社区里主要存在两大流派,背后是两种完全不同的使用场景。
本地个人使用:认准 GGUF
如果你用 Ollama 或 LM Studio,不要犹豫,直接认 GGUF 后缀。它把一切打包成单文件,极大简化了部署流程,适合个人在家把玩,一次回答一个问题。
服务器高并发:选 GPU 专属格式
如果你是在服务器上跑高并发的 vLLM,就去下 AWQ、GPTQ、FP8 量化版,或者官方的 BF16 原版。
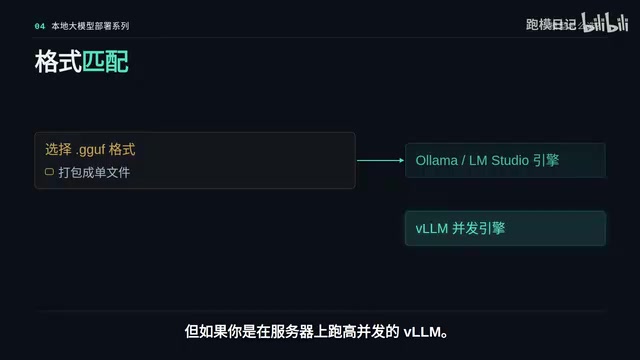
一个形象的比喻解释了为什么会分成两派:GGUF 就像单车道,适合你自己在家一次处理一个问题;但如果要在公司做客服系统,几十个人同时提问,GGUF 就会彻底拥堵瘫痪。这时必须换用 AWQ 这类 GPU 专属格式,配合 vLLM 开辟多车道并行处理。
理解两大格式派系的本质区别,有助于避免踩坑。GGUF(GPT-Generated Unified Format)是由 llama.cpp 项目定义的格式,其核心设计目标是「CPU 友好」——它支持将模型权重混合存放在内存和显存中,因此在没有高端 GPU 的消费级设备上也能运行。而 AWQ(Activation-aware Weight Quantization)、GPTQ 和 FP8 则是专门针对 CUDA GPU 优化的格式,依赖 GPU 的并行计算能力来实现高吞吐量,无法在纯 CPU 环境下高效运行。BF16 则是一种16位浮点数格式,相比常见的 FP32 节省一半显存,同时比 FP16 在数值范围上更稳定,是目前大模型训练和推理的主流精度格式。
量化档位怎么选:不知道就 Q4_K_M
在 GGUF 目录里,你会看到很多带下划线的后缀,这些代表量化档位。规律很简单:数字越小,模型体积越轻,但也越容易胡言乱语。
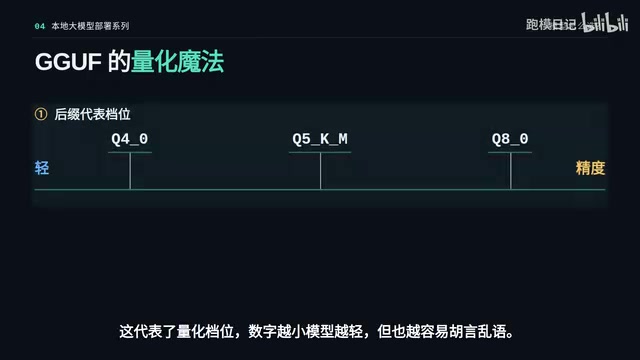
如果不知道怎么选,有个可以直接背下来的答案:Q4_K_M。它经过社区长期验证,是体积和精度最平衡的版本,适合绝大多数个人场景。
量化(Quantization)是指将模型权重从高精度浮点数(如 FP32、BF16)压缩为低位整数的技术。例如 Q4 代表用 4 位整数存储每个权重,相比原始 16 位浮点数体积缩减约 75%。文件名中的 K 表示采用了 K-quants 算法——这是 llama.cpp 引入的一种改进量化方案,能在相同位数下保留更多关键权重的精度,比早期的均匀量化效果更好。M(Medium)则是同一位数下的中等精度变体,介于 S(Small,最激进压缩)和 L(Large,最保守压缩)之间。因此 Q4_K_M 的完整含义是:4位K-quants中等精度版本,是社区公认的「够用又够轻」的最佳平衡点。
标准四:上下文长度与许可证
剩下两个要素相对直白。
上下文长度(比如 32K、128K)决定了模型一次能读完多厚的文档。但要牢记上一期的结论:想要超长的「记忆」,就得付出高昂的显存代价,并非越大越好,要按实际需求取舍。
许可证在公司场景中尤其关键。如果拿来做公司业务,认准 Apache 2.0 或 MIT。最需要警惕的,反而是名字里带 Community 或 Non-Commercial 的协议——它们看似免费,商用却可能构成侵权。
上下文长度(Context Length)在技术层面对应 Transformer 架构中的注意力(Attention)计算范围。其显存消耗随上下文长度的增加呈近似平方级增长,这是因为注意力机制需要维护一个「KV Cache」(键值缓存)来存储所有历史 Token 的中间状态。以 128K 上下文为例,其 KV Cache 的显存占用可能高达数 GB,有时甚至超过模型权重本身。因此,除非你的实际业务确实需要处理长篇文档(如完整合同、学术论文),否则选择 32K 或更短的上下文版本,能显著降低显存压力并提升响应速度。
把四步串成一个筛选漏斗
把这套方法按顺序走一遍,就能从海量文件里精准带走你需要的那一个:
- 看参数量,结合显存预算判断机器装不装得下;
- 按引擎匹配格式,本地引擎认 GGUF,并发服务认 AWQ 这类 GPU 量化版;
- 辨认量化档位,不知道选就 Q4_K_M;
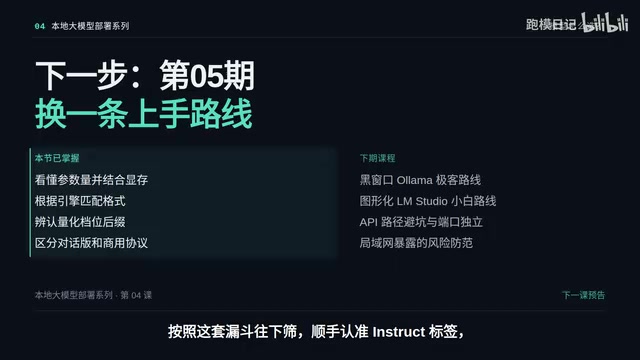
- 区分版本与协议,对话认 Instruct,商用认 Apache 2.0 和 MIT。
顺手记住 Instruct 标签,你就能告别瞎蒙。模型选好了,下一步就是怎么把它真正跑起来——下一期会对比两条主流路线:命令行的 Ollama 极客路线,和图形化的 LM Studio 小白路线,还会讲 API 路径怎么避坑、端口如何独立,以及局域网暴露的风险怎么防。
相关推荐

神经网络本质是线性回归?华为300集AI课讲师用TensorFlow Playground讲透深度学习
华为300集AI深度学习教程中,讲师用TensorFlow Playground演示神经网络本质是线性回归,讲透机器学习与深度学习在特征工程上的核心差异,以及2012年大数据时代为何成为深度学习崛起的分水岭。

WorkBuddy做AI漫剧全流程:8步从零到成片
基于B站教程梳理WorkBuddy制作AI漫剧的完整八步流程:从选题策划、剧本分镜到图片资产、视频生成、配音剪辑与导出发布,并解析WorkBuddy的专家技能机制与逐个召唤专家的实操技巧,适合零基础入门。

Codex实战教程:从安装到多智能体协同
基于B站Codex实战教程,系统梳理Codex从安装配置、CLI交互、斜杠指令、AGENTS.md架构到MCP协议、多智能体协同与企业级插件开发的完整路径,帮助开发者理解AI Agent的工程化用法。