本地GGUF模型导入Ollama:复用ComfyUI模型免重复下载
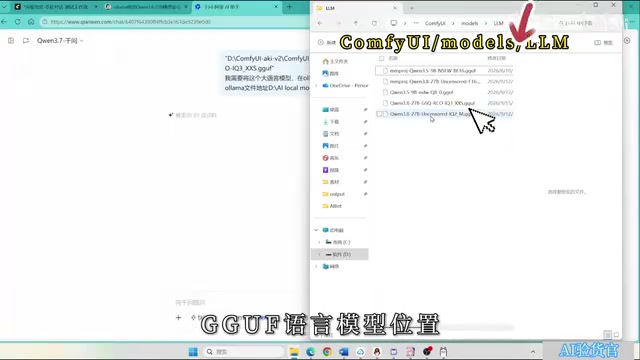
通过Modelfile让Ollama直接引用ComfyUI已有的GGUF模型,避免重复下载浪费空间。
本文介绍了一个解决ComfyUI与Ollama重复存储大语言模型问题的实用技巧。Ollama默认只识别自己下载的模型,与ComfyUI各自维护一份GGUF文件副本,造成数GB级别的存储浪费。解决方案是利用Ollama的Modelfile机制:创建一个包含`FROM`指令、指向ComfyUI目录中现有GGUF文件绝对路径的配置文件,然后在终端执行创建命令,Ollama便会建立对该文件的引用而非重新下载。整个过程速度极快,关键注意事项是重命名时必须删除文件的`.txt`后缀。完成后,同一个GGUF模型即可被两套工具共享调用。
对于同时使用 ComfyUI 和 Ollama 的用户来说,一个常见的困扰是:明明已经在 ComfyUI 目录下载好了 GGUF 格式的大语言模型,却因为 Ollama 有自己的模型管理机制,被迫重新下载同一个模型。这不仅浪费磁盘空间,还要忍受漫长的下载过程,甚至偶尔因网络问题导致下载失败。
实际上,Ollama 支持通过 Modelfile 机制直接导入本地已有的 GGUF 文件。掌握这个方法后,同一个模型就能在 ComfyUI 和 Ollama 之间共享,彻底告别重复下载。本文根据 B站 UP主「AI验货官」的演示,梳理出完整的操作流程。
为什么会出现重复下载
ComfyUI 通常将大语言模型放在 LLM 相关文件夹下,以 GGUF 这种量化格式存储,方便在本地推理时加载。而 Ollama 使用的是自成一体的模型仓库和命名体系,默认情况下它只认自己 pull 下来的模型,并不会主动去识别你在其他工具目录中已有的文件。
结果就是,两套工具各自维护一份模型副本。一个 7B 甚至更大的 GGUF 模型动辄数 GB,重复占用的存储相当可观。要解决这个问题,核心思路是让 Ollama 直接「指向」ComfyUI 目录里那份现成的 GGUF 文件,而不是重新获取。
GGUF(GPT-Generated Unified Format)是由 llama.cpp 项目引入的一种模型文件格式,专为本地推理设计。它将模型权重、分词器配置、超参数等所有必要信息打包进单个文件,同时支持 Q4、Q5、Q8 等多种量化精度,可以在显存有限的消费级硬件上运行原本需要数十 GB 显存的大模型。GGUF 已逐渐取代旧版 GGML 格式,成为 ComfyUI、LM Studio、Jan 等本地推理工具的通用标准。一个 7B 参数模型经过 Q4 量化后体积通常在 4-5 GB 左右,Q8 量化则在 7-8 GB,重复存储的成本非常直观。
操作前的准备工作
第一步是确认两个关键路径。先找到 ComfyUI 的 LLM 文件夹下 GGUF 语言模型的具体存放位置,记下完整路径。接着确认 Ollama 的模型下载位置,做到心中有数。
这里 UP主分享了一个实用的偷懒技巧:如果你不清楚具体路径或操作细节,可以把需求描述发给豆包(或其他 AI 助手),让它一步步给出针对性的指引。这种「让 AI 陪跑」的方式,对不熟悉命令行的新手尤其友好。
创建 Modelfile 配置文件
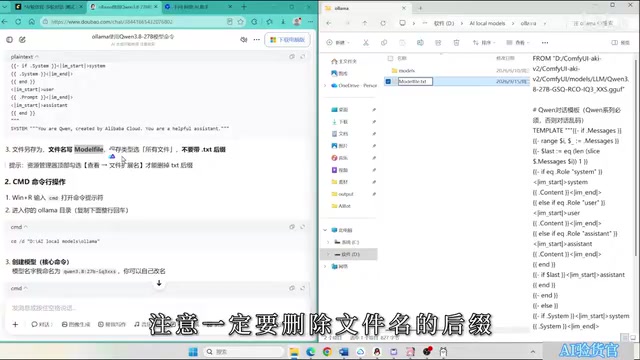
Ollama 通过一个名为 Modelfile 的配置文件来定义模型的来源和参数。具体做法是:新建一个文本文件,把 AI 助手给出的配置内容复制进去,粘贴保存后关闭。
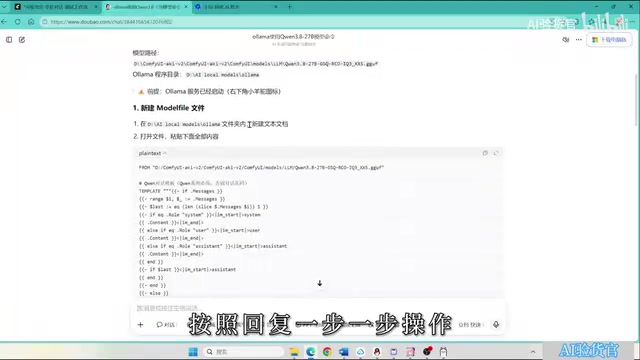
配置内容的核心,就是用一行 FROM 指令指向 ComfyUI 目录里那个 GGUF 文件的绝对路径。保存后,把文件重命名为 Modelfile——这里有个极易踩坑的细节:一定要删除文件名的 .txt 后缀,否则 Ollama 无法正确识别这个配置文件。建议开启系统的「显示文件扩展名」选项,避免误操作。
Modelfile 是 Ollama 借鉴 Dockerfile 思路设计的模型描述文件,语法简洁。除了 FROM 指令指定模型来源(可以是本地路径或 Ollama Hub 上的模型名),还支持 SYSTEM(设置系统提示词)、PARAMETER(调整 temperature、context 长度等推理参数)、TEMPLATE(自定义对话模板)等指令。对于仅共享已有 GGUF 文件的场景,只需一行 FROM /绝对路径/模型名.gguf 即可,其余指令按需添加。Ollama 在处理 FROM 指向本地文件时,实际上并不复制文件,只是在自己的元数据库中建立引用,因此速度极快且不额外占用磁盘。
执行导入命令
配置文件就绪后,在文件所在目录右键打开终端(命令行窗口)。
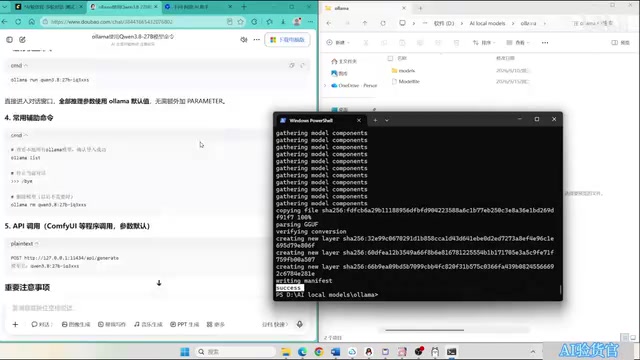
接下来运行 Ollama 的模型创建命令,命令中可以自定义模型名称,方便后续调用时识别。粘贴命令后回车,等待系统处理。当终端输出 success 字样,就说明导入成功——这个过程只是让 Ollama 建立对本地文件的引用,不涉及任何下载,所以速度很快。
验证与使用
导入完成后,可以用模型列表命令查看结果,确认新建的模型已经出现在 Ollama 的可用列表中。
最后运行一下这个模型进行测试,如果能正常对话,就大功告成了。至此,同一个 GGUF 模型可以同时被 ComfyUI 和 Ollama 调用,既省下了磁盘空间,也免去了 Ollama 端下载失败的烦恼。
方法背后的价值
这个技巧看似只是省一次下载,但对深度使用本地大模型的用户而言,意义不小。随着 GGUF 成为本地量化模型的主流格式,越来越多工具都能读取它。让不同工具共享同一份模型文件,是本地 AI 工作流优化的一个通用思路。
需要提醒的是,UP主在演示中大量借助 AI 助手来生成路径和命令,这降低了上手门槛,但也意味着不同系统环境下的具体命令可能有差异。操作时建议结合自己的实际路径灵活调整,遇到报错时把错误信息反馈给 AI 助手往往能快速定位问题。
相关推荐
本地跑 Qwen-3.8-27B 替代 API:一位开发者的实战体验
一位 Reddit 开发者分享用本地 Qwen-3.8-27B 完全替代云端 API 的实战经验,涵盖 Q4_K_S 量化、Pi agent 极简工具链、树莓派部署与详细成本核算,探讨开源大模型「够用」的临界点。
生产环境中如何验证AI Agent的行为?运行时校验实战指南
AI Agent在生产环境代表用户执行操作时如何验证其行为?本文从非确定性输出、不可逆副作用等挑战出发,梳理策略护栏、人在回路、运行时追踪、LLM评判等验证方法,帮助团队构建分层防御体系。
TechCrunch Disrupt 2026 门票优惠倒计时:省200美元的最后机会
TechCrunch Disrupt 2026 早鸟门票优惠进入倒计时,最高可省 200 美元,9 月 25 日截止,第二位嘉宾享 5 折。官方重点强调参会理由之一:获取务实、可落地的行业答案。