本地文学创作模型PK:Qwen3.8 27B微调版胜出,DeepSeek v4.1表现平淡

七款Qwen3.8 27B微调模型文学创作横评:海明威总分第一,HumanLike Chat情感最佳,DeepSeek v4.1表现平庸。
B站UP主用三道文学创作题(场景叙事、对话创作、600字短篇)横向测评了七款基于Qwen3.8 27B的模型,包括海明威、HumanLike Chat、东方朔等社区微调版及官方原版,并加入DeepSeek v4.1对比。结果显示,专为文学优化的海明威总分第一,人物描写和对白突出;主打拟人聊天的HumanLike Chat在情感渲染和对话自然度上表现最佳,第三题短篇夺冠。DeepSeek v4.1无明显错误但叙事平淡如流水账,排名中游。东方朔虽主打网文优化,却因角色关系混乱垫底。UP主建议优先尝试海明威和HumanLike Chat,并强调27B模型无法一次性生成长篇,需分段生成和人工把控角色一致性。
用本地部署的开源模型写网文、写文案,到底靠不靠谱?最近一位B站UP主做了一次横向测评,用三道文学创作题测试了七款基于Qwen3.8 27B的模型,其中包括社区热门微调版和官方原版,还拉来了DeepSeek v4.1做对比。结论有些出人意料:专门为文学优化的海明威模型拿下第一,主打拟人聊天的HumanLike Chat紧随其后,而备受期待的DeepSeek v4.1表现平庸,甚至被评价为“白开水”。
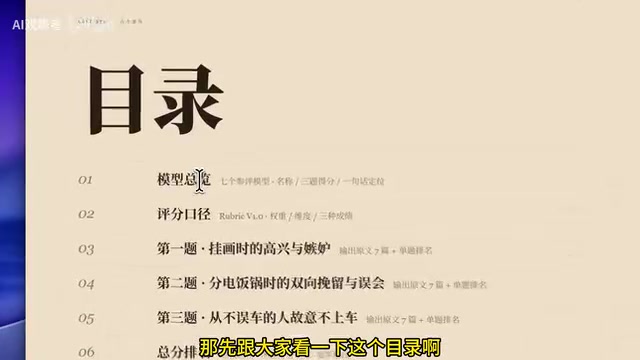
测评方法与评分标准
这次测评选取了六款社区微调模型,基座均为Qwen3.8 27B:海明威(Hemingway)、HumanLike Chat、Alexs WinX(强调高EQ)、DavidAU Brandings(春秋大王)、东方朔(中文网文特化),以及官方原版Qwen3.8 27B作为基准。第七款是DeepSeek广告 v4.1(官方1017版本)。
三道题分别考察不同能力:
- 第一题:场景叙事——两位画友,一人办个展,另一人帮忙挂画,要求通过动作、对话、细节传达“高兴又轻微嫉妒”的复杂情绪,不能直说。
- 第二题:对话创作——合租三年的室友即将分开,围绕电饭锅归属写12句对话,不能加入旁白或心理描写,要让读者感受到双方都不愿对方离开。
- 第三题:600字完整短篇——给定标题或场景,要求叙事结构完整、情感渲染到位、角色关系不出错。
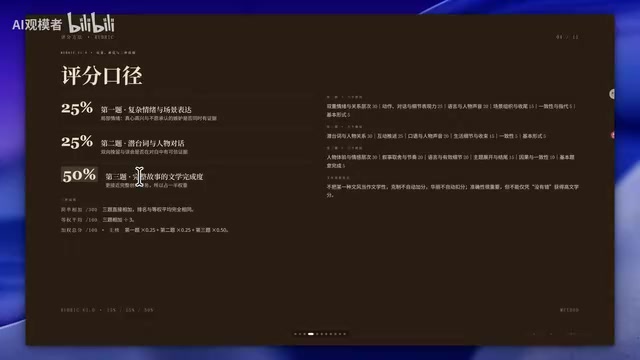
评分权重上,第三题占50%,前两题各25%。UP主解释,第三题对叙事闭环、情感渲染和角色一致性要求最高,最能拉开差距。
微调(Fine-tuning) 是指在已预训练好的基座模型上,用特定领域或风格的数据继续训练,使模型习得该领域的表达习惯与知识。本文中六款社区模型均以 Qwen3.8 27B 为基座进行微调,因此它们的底层语言能力相近,差异主要来自微调数据的风格与质量。这也解释了为何“海明威”“HumanLike Chat”等风格化模型能在文学任务上胜过官方原版——微调相当于给模型“开小灶”,强化了特定场景下的输出偏好。
27B 参数规模 指模型约有 270 亿个可学习参数,属于中等偏大的开源模型量级。这一规模足以支撑较流畅的中文生成,但受限于上下文窗口和显存,无法一次性输出超长文本(如百万字小说),通常需要分段生成、人工拼接与校对。参数规模也直接影响本地部署的硬件门槛,27B 模型通常需要 24GB 以上显存或量化后运行。
第一题:海明威夺冠,细节叙事见功力
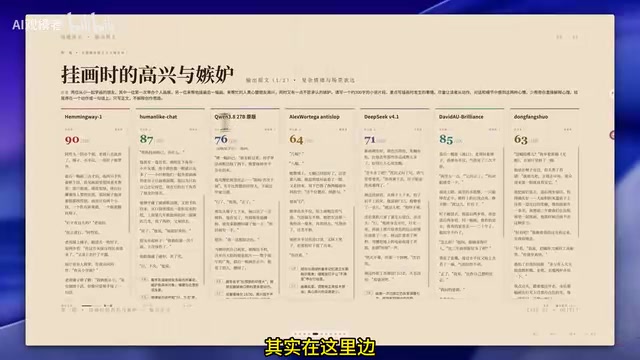
第一题要求写“挂画时的高兴与嫉妒”,不能直接点破情绪。海明威模型拿到90分,在七款模型中排名第一。
UP主展示了海明威的片段:老周帮朋友阿哲挂画,观众问阿哲“你从小学画吗”,老周抢着接话“我俩都是从小学的”,随后又咧嘴笑、把旁边并不歪的椅子摆正。结尾人群涌向阿哲,老周站在原地没动。这些动作和细节把“替朋友高兴”和“隐隐嫉妒”同时传递了出来,没有一句直白说明。
HumanLike Chat排名第二,用了类似插叙的手法,朋友笑着说“你盯着我的画看了三天了”,用一句调侃点出心虚,但结尾收束不如海明威。官方原版排第三,表现均衡但缺少亮点。DeepSeek v4.1排第五,被评价为“写得可以,但结尾一般”。DavidAU Brandings(春秋大王)在这题里表现尚可,但整体排名未进前三。
UP主点评:海明威在局部人物描写和人物对白上很突出,但故事完整性稍欠。
第二题:HumanLike Chat情商在线,对话自然
第二题考的是“不说破”的对话能力。海明威依然第一,但HumanLike Chat的高情商表现让人印象深刻。
HumanLike Chat的对话里,甲说“锅归我吧,明天我早上要熬粥”,乙回“那你内胆大,一个人烧一锅剩一半”,甲又说“你那厨房灶台小,放不下”,乙接“挤一挤就行了,住了三年有什么没挤过”。几句家常话,双方都在挽留,却谁也没说破。UP主评价“情商确实不错,对白自然,文字克制”。
官方原版排第三,对话合理但情绪张力不足。DeepSeek v4.1在这题里表现中规中矩,没有明显错误,也没能打动读者。东方朔在这题里角色关系出现混乱,排名靠后。
第三题:HumanLike Chat爆冷第一,但角色错误普遍存在
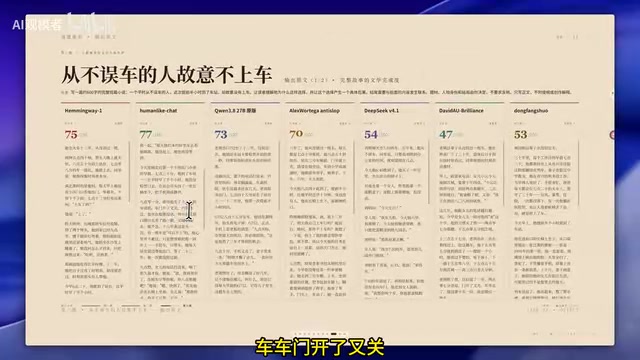
第三题是600字完整短篇,权重最高,也是失误最多的一题。HumanLike Chat拿下第一,写了一个老人沈炎在妻子去世后,第一次没有赶8点班车的故事。文中用“等车”串联三层等待:妻子生前等他、他等妻子、女儿等他。情感渲染和叙事结构都得到了认可。
但UP主也指出,这篇在结尾处出现了角色指代错误——“母亲生前”应为“妻子生前”,女儿站在门口张望的样子被写成“和母亲从前站在窗边等他的样子一模一样”。这个错误不只是HumanLike Chat有,其他27B模型多多少少都出现了类似问题。
海明威在这题排第二,同样写了等车主题,叙事完整但情感冲击力略逊。官方原版排第三。DeepSeek v4.1写的故事被评价为“太平淡,像流水账”,女儿坐车、到站、拿蛋糕,没有任何打动读者的地方,分数较低。东方朔错误最多,角色混乱、结构颠三倒四,在七款模型中垫底。
角色指代错误 是长文本生成中的典型问题,指模型在叙事中混淆人物身份、称谓或关系,例如把“妻子”写成“母亲”。这类错误在 27B 级别模型中普遍存在,根源在于模型缺乏对全文人物关系的显式记忆与一致性校验机制。分段生成时,每一段独立推理,模型容易根据局部语境“脑补”称谓,导致前后矛盾。缓解方法包括:在提示词中固定人物关系表、分段后人工核对称谓、使用支持长上下文的模型或外部记忆工具辅助。
总排名与使用建议
综合三道题,最终排名如下:
- 海明威(Hemingway)——总分第一,人物描写和对白突出
- HumanLike Chat——总分第二,情感渲染和对话自然度最佳
- 官方原版Qwen3.8 27B——均衡但无惊喜
- DavidAU Brandings(春秋大王)——第一题尚可,整体不如原版
- Alexs WinX——高情商标签,但文学创作表现一般
- DeepSeek v4.1——无明显错误,但缺乏亮点
- 东方朔——中文网文特化,但基础文学素养不足,角色混乱严重
UP主给出的实用建议是:如果想用本地模型辅助文学创作,海明威和HumanLike Chat值得优先尝试,聊天和创作表现都较均衡。DavidAU和Alexs WinX在推理、智能体方面可能不错,但文学创作不是强项。东方朔虽然主打网文优化,但基础叙事能力不过关,角色关系容易混乱,写长篇网文风险较高。
另一个重要提醒是,27B级别的模型无法一次性生成百万字小说,只能分段生成,且需要人工把控多角色关系。UP主强调:“不能完全交给它,写完之后你可能需要进行一定的修改。”
一点观察
这次测评的样本量不大,三道题也很难覆盖文学创作的全部维度,但它揭示了一个值得注意的现象:基座能力强的模型(如官方原版)在文学创作上未必比专门微调的版本更出彩,而主打拟人聊天的模型反而在情感表达上更有优势。DeepSeek v4.1的中文能力口碑一直不错,但在需要情感张力和叙事技巧的任务中,它的“安全牌”风格反而成了短板。
对于想本地部署写网文、写文案的用户来说,模型选择只是第一步,提示词设计、分段策略、人工润色同样关键。海明威和HumanLike Chat的下载链接UP主放在了评论区置顶,感兴趣可以自行尝试。
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。