AI论文精选:智能体架构与上下文管理新突破

引言:智能体研究进入深水区
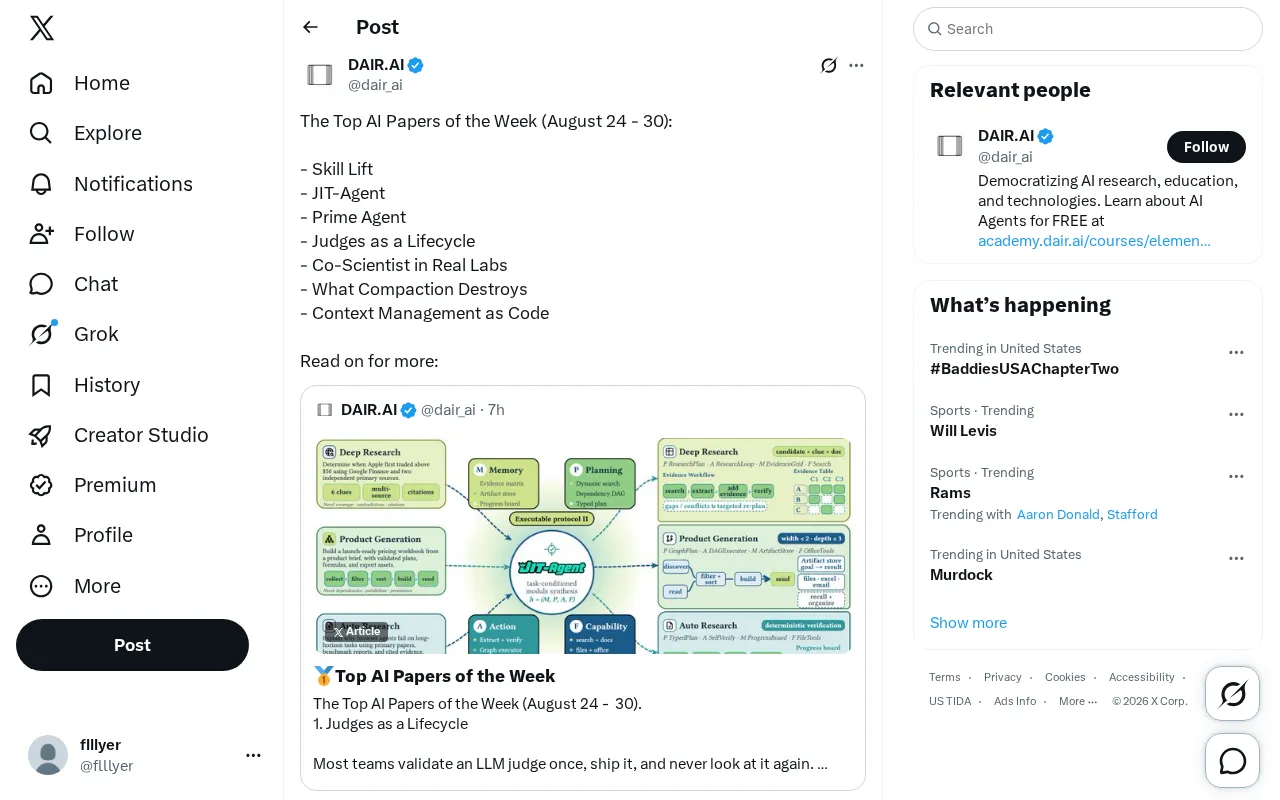
AI学术界近期迎来了一批聚焦于智能体(Agent)系统的重磅论文。从技能迁移、即时编译式智能体,到评估体系的生命周期化管理,再到科学发现的实验室实践,这些研究共同勾勒出一个清晰的趋势:AI智能体正从「能跑通demo」向「工程化、可维护、可评估」的成熟阶段演进。
本文将梳理近期备受关注的七篇论文,分析它们各自解决的核心问题,以及对未来智能体开发实践的启示。
智能体能力构建:从技能迁移到即时编译
Skill Lift:让智能体技能可复用、可迁移
「Skill Lift」这一研究方向瞄准的是智能体技能的抽象与迁移问题。在传统的智能体开发中,特定任务的能力往往与具体场景强耦合,难以复用。Skill Lift的核心思路是将成功执行的行为模式抽象为可复用的「技能」单元,让智能体在新任务中快速调用已有经验,而不必从零学习。
这一方向的价值在于大幅降低智能体的训练与部署成本。当一个智能体掌握了某类操作模式后,理论上能将其「提升」到更高层次的抽象,从而泛化到相似但不完全相同的任务场景。
从技术谱系来看,技能迁移的概念根植于迁移学习(Transfer Learning)和分层强化学习(Hierarchical Reinforcement Learning)的研究传统。在迁移学习中,核心思想是将在一个任务或领域中学到的知识应用到另一个相关但不同的任务中,大幅减少新任务所需的训练数据和计算资源。而在分层强化学习中,智能体将复杂任务分解为多层次的子目标,底层策略负责原子操作,高层策略负责调度组合——经典的Options框架和HAM(Hierarchy of Abstract Machines)都是这一方向的代表性工作。Skill Lift的思路与此一脉相承,但更强调从实际执行轨迹中自动提取和抽象可复用的技能模块,类似于软件工程中的函数抽象和模块封装。值得一提的是,这一方法与OpenAI早期在Minecraft游戏中通过「Voyager」智能体积累技能库的实验形成呼应——后者通过将成功行为编码为可调用的JavaScript函数,实现了开放世界中的持续学习和能力积累,展示了技能库随时间增长带来的「滚雪球」效应。Skill Lift的进一步贡献在于将这种技能抽象机制推向了更通用的场景,使其不再局限于特定的游戏或仿真环境。
JIT-Agent:即时编译思想重塑智能体范式
「JIT-Agent」借鉴了编程语言中「即时编译」(Just-In-Time Compilation)的理念。传统智能体在面对任务时,通常依赖预先设计好的固定流程;而JIT范式主张在运行时根据当前上下文动态生成执行策略或代码。
要理解这一创新的深意,有必要回顾即时编译技术本身的原理。JIT编译最初是编程语言运行时优化的核心技术,由Java虚拟机(JVM)和.NET CLR等广泛采用。其核心思想是:不在程序运行前将全部源代码编译为机器码(即AOT,Ahead-Of-Time编译),而是在运行时根据实际执行路径和热点代码进行动态编译优化。例如,JVM的HotSpot编译器会监控哪些方法被频繁调用,仅对这些「热点」方法进行深度优化编译,从而在启动速度和峰值性能之间取得最佳平衡。这使得程序能够根据运行时的具体上下文信息做出更优的编译决策——包括内联展开、分支预测优化等在编译期无法确定的优化策略。将这一思想移植到智能体领域,意味着智能体不再依赖预先硬编码的所有可能行为路径,而是在面对具体任务时,基于当前上下文实时生成执行计划或代码片段,在灵活性和执行效率之间取得动态平衡。
这种做法的最大优势在于灵活性——智能体不再受限于开发者预设的行为树(Behavior Tree,一种在游戏AI和机器人领域广泛使用的决策结构,通过层级化的节点组织定义智能体的行为逻辑),而是即时「编译」出针对当前问题的解决方案。对于处理长尾、开放式任务而言,这一点尤为关键,也标志着智能体架构从静态编排向动态生成的根本性转变。
Prime Agent:多智能体系统的协调中枢
「Prime Agent」探讨的是多智能体系统中主导协调者的角色设计。在复杂任务中,单一智能体往往力不从心,需要多个子智能体协同工作。Prime Agent作为核心调度者,负责任务分解、子任务分配以及结果整合,是构建可扩展多智能体系统的关键组件。
多智能体系统(Multi-Agent Systems, MAS)的研究可以追溯到上世纪80年代分布式人工智能的早期工作,经典的合同网协议(Contract Net Protocol)和黑板系统(Blackboard Architecture)奠定了智能体间协作与通信的基本范式。但在当前大语言模型驱动的智能体生态中,协调问题呈现出新的挑战维度。核心难题包括:任务分解的粒度控制(分解过粗则子智能体负担过重,过细则通信开销剧增)、子智能体之间的信息共享与冲突解决、以及全局目标与局部行为的对齐问题。当前,AutoGen(微软推出的多智能体对话框架)、CrewAI(基于角色扮演的智能体协作框架)、LangGraph(LangChain团队推出的基于图结构的智能体编排工具)等主流多智能体框架均在探索不同的协调范式。Prime Agent作为中央协调者的设计,本质上采用了集中式调度架构,与去中心化的对等协作模式形成对照——集中式更易保证全局一致性和任务执行的确定性,去中心化则具备更好的容错性和可扩展性。这两种范式的权衡选择,很可能成为未来多智能体系统架构设计中的核心决策点。
评估与质量保障:Judges as a Lifecycle
评估一直是AI系统落地的痛点,尤其对于生成式和智能体系统来说,缺乏明确的标准答案让质量保障异常困难。「Judges as a Lifecycle」提出了一个重要观点:评估不应是开发流程末端的一次性检验,而应作为贯穿整个系统生命周期的持续过程。
这里的「Judges」概念建立在近两年兴起的「LLM-as-a-Judge」评估范式之上。这一范式最早由LMSYS团队在MT-Bench和Chatbot Arena中大规模应用,基本思路是使用一个能力较强的LLM(如GPT-4)对其他模型的输出进行打分或排序,以替代昂贵且耗时的人工评估。该范式的优势在于可扩展性强、评估速度快、成本低,但也存在已知的偏见问题:位置偏见(Position Bias,倾向于给排在前面的回答更高分)、冗长偏见(Verbosity Bias,倾向于给更长的回答更高分)、以及自我偏好(Self-Enhancement Bias,倾向于给与自身风格相似的回答更高分)。将Judges嵌入系统全生命周期,不仅需要解决何时评估、评估什么的问题,还需要同时应对这些评估偏见的校准挑战,例如通过多评判者投票、位置随机化、以及人类偏好数据的持续校准来缓解偏见影响。
从一次性评测到持续评估
传统的模型评估往往集中在训练完成后的基准测试环节。但在真实生产环境中,系统的输入分布会不断变化(即数据漂移,Data Drift),用户需求也在持续演进。将「评判者」(Judges,通常指用于自动评估输出质量的模型或规则)嵌入整个生命周期,意味着系统能够持续监控自身表现,及时发现质量退化。
这一理念与软件工程中的持续集成/持续部署(CI/CD)思想高度契合。CI/CD是现代软件工程的基石实践,通过自动化的构建、测试和部署流水线确保代码变更的快速、安全交付。在AI系统领域,这一实践正在演化为MLOps(机器学习运维)和更新的LLMOps概念。MLOps关注模型训练、版本管理、数据漂移监控和模型重训练的自动化流程,代表性平台包括MLflow、Kubeflow和Weights & Biases;而LLMOps则进一步聚焦于提示词版本管理、输出质量的持续监控、成本优化和安全护栏的部署,LangSmith、Braintrust等工具正是这一领域的新兴代表。将评估生命周期化,实质上是在LLMOps流水线中嵌入质量门禁(Quality Gates),使系统能够在生产环境中持续自我诊断,而非仅依赖上线前的离线评测。
这反映出AI系统开发正在积极吸收成熟软件工程的最佳实践。将评估「生命周期化」,本质上是在为智能体系统建立长期可靠的质量护栏。
科学发现的实践:Co-Scientist in Real Labs
「Co-Scientist in Real Labs」将AI智能体带入了真实的科学实验室场景。相比于在受控benchmark上的表现,AI作为「协同科学家」在真实实验环境中面临更多挑战:不确定的实验条件、噪声数据、以及与人类研究者之间的协作界面。
要理解这项研究的定位,需要了解AI辅助科学发现(AI for Science)近年来经历的三个发展阶段。第一阶段是数据分析加速,AI主要用于处理大规模实验数据,如DeepMind的AlphaFold预测蛋白质三维结构(解决了困扰生物学界50年的蛋白质折叠问题)、以及GNoME项目在材料科学领域发现了220万种新稳定晶体结构;第二阶段是假设生成,AI开始参与科学假设的提出,利用大语言模型进行海量文献的综合分析和新假设推理,FutureHouse的PaperQA等工具已能够自动完成系统性的文献综述;第三阶段则是闭环实验,AI不仅生成假设,还能设计实验方案、控制自动化实验设备(如机器人化学家)、分析实验结果并迭代假设,形成完整的科学发现闭环。Carnegie Mellon大学的「Coscientist」系统已在化学合成领域展示了这种闭环能力,能够自主规划实验步骤并操控液体处理机器人完成有机反应。
Co-Scientist in Real Labs代表的正是向第三阶段的积极推进,其核心难点在于处理真实实验中的不可控变量——试剂纯度波动、环境温湿度变化、设备精度误差等——以及与人类研究者的有效协作。这类研究的意义在于验证AI智能体是否真正具备加速科学发现的能力。当AI能够协助设计实验、分析结果、提出假设时,它就从工具进化为了研究伙伴。真实实验室的落地为评估AI的实用价值提供了远比论文理想化设定更严格的检验标准。
上下文工程:本周最值得关注的方向
What Compaction Destroys:上下文压缩的隐性代价
随着上下文长度不断增长,如何管理和压缩上下文成为长对话、长任务智能体的核心挑战。「What Compaction Destroys」(压缩摧毁了什么)这篇论文的标题本身就发人深省——它直面上下文压缩过程中不可避免的信息损失问题。
这一问题的背景是大语言模型上下文窗口的急剧扩张与模型实际处理能力之间的张力。从GPT-3时代的2048 tokens,到GPT-4的128K tokens,再到Claude的200K tokens和Gemini 1.5的百万级tokens,上下文窗口经历了指数级增长。然而,更长的上下文并不意味着问题的彻底解决——2023年Stanford和UC Berkeley的研究揭示了「Lost in the Middle」问题,即模型在处理超长上下文时,对位于上下文中间位置的信息检索准确率显著下降,呈现出明显的U型曲线(对开头和结尾信息的利用效率远高于中间部分)。为应对这一挑战,学术界和工业界发展了多种上下文压缩技术:基于摘要的压缩(将历史对话摘要化,保留语义精华但丢失细节)、基于检索的压缩(即RAG——检索增强生成,仅检索与当前查询相关的片段注入上下文)、基于蒸馏的压缩(将长文本的语义信息压缩到较少的「软提示」向量中,如Stanford的Gisting技术和Princeton的AutoCompressors),以及简单的滑动窗口策略(仅保留最近的N轮对话)。每种方法都涉及信息保留与计算效率之间的艰难权衡。
当我们为了节省token或提升效率而压缩历史上下文时,究竟丢失了哪些关键信息?这些丢失又会如何影响智能体的后续决策?这项研究提醒开发者:压缩并非免费的午餐,粗暴的截断或摘要可能从根本上破坏智能体维持长期一致性的能力——例如丢失早期对话中用户表达的隐式偏好、关键约束条件或已达成的共识。
Context Management as Code:上下文管理的工程化实践
与前者形成呼应,「Context Management as Code」(上下文管理即代码)主张将上下文管理提升为一等工程实践。正如基础设施可以用代码定义(Infrastructure as Code),上下文的组织、注入、清理也应当被显式地、可版本化地管理。
这里所借鉴的Infrastructure as Code(基础设施即代码,IaC)是DevOps运动中的核心理念,以Terraform(HashiCorp出品的声明式基础设施编排工具)、Ansible(Red Hat的自动化配置管理工具)、Pulumi(支持通用编程语言定义基础设施的工具)等为代表。其核心原则是:所有基础设施配置(服务器、网络、数据库等)都应以声明式代码的形式定义、纳入Git等版本控制系统管理,并通过自动化流程部署,从而消除手动配置带来的不一致性和不可追溯性——即所谓的「配置漂移」(Configuration Drift)问题。将这一理念应用于上下文管理,意味着智能体的上下文构造过程不再是隐式的、难以追踪的黑盒操作,而是通过显式的代码逻辑精确定义:何时注入系统提示、何时检索外部知识、何时清理过期信息、何时压缩历史对话、如何在多轮交互中维护状态信息。这种透明化管理使得上下文行为可审计、可回滚、可在团队间共享和复用,也为调试智能体行为异常提供了清晰的排查路径。
这一理念的核心要义是:不要让上下文成为黑盒。通过将上下文管理逻辑代码化,开发者能够精确控制哪些信息在什么时候进入模型的视野,从而实现可预测、可调试、可复用的智能体行为。这或许是近期论文中对实际工程落地最具指导意义的方向之一。
总结:智能体研究的工程化转向
综观这批论文,一个鲜明的主题浮出水面——智能体研究的工程化转向。无论是JIT式的动态生成、Judges的生命周期评估,还是Context Management as Code的显式管理,研究者们越来越关注如何让智能体系统变得可维护、可评估、可信赖。
这标志着AI智能体领域正在走出「炫技」阶段,进入务实的工程建设期。对于从业者而言,这些研究不仅是学术前沿的展示,更提供了可直接落地的方法论——从技能复用到上下文治理,每一项都指向了构建生产级智能体系统的关键路径。
核心要点
核心要点
相关推荐

AI数字员工系统实测:所谓免费背后的营销套路解析
针对B站流行的「AI超级员工系统」「AI数字员工」推广视频,本文拆解其视频剪辑智能体、DeepSeek脚本助手两大功能模块,揭示其大模型二次封装的技术本质与免费引流背后的营销套路及账号安全风险。

WorkBuddy入门指南:让AI真正替你上班的桌面智能体
WorkBuddy是一款能直接操作本地电脑的桌面AI智能体。本文详解其定位、与CodeX的差异、常见认知误区及文件管理、协同办公等实战能力,帮你从AI提问者进化为AI管理者。

LangGraph入门指南:AI Agent的操作系统全解析
LangGraph 被称为 AI Agent 的操作系统,本文系统梳理其与 LangChain 的关系、状态节点边三大要素、持久化 checkpoint、human-in-the-loop 及子图等核心能力与学习路径。