变换采样器与方差缩减:用归一化流破解控制变量难题
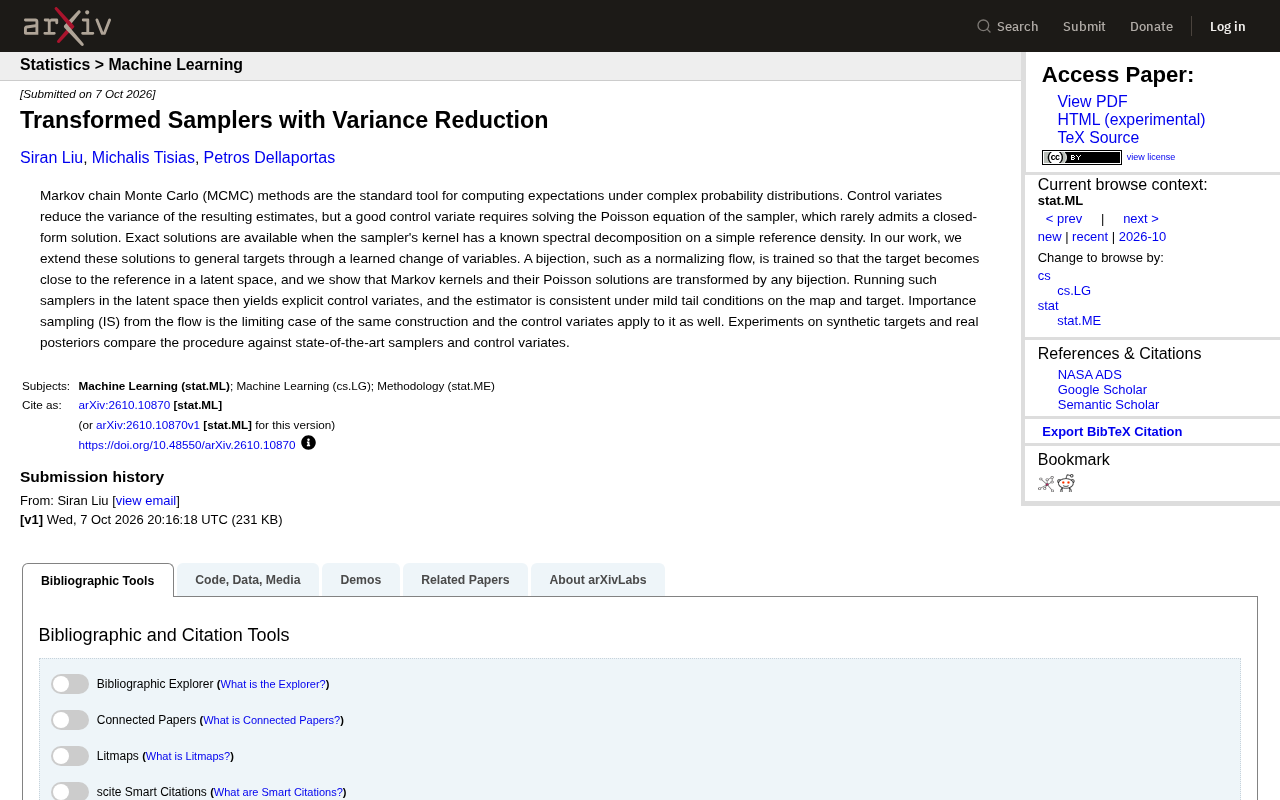
训练归一化流将复杂目标映射到可解析空间,从而为MCMC提供显式控制变量以缩减方差。
这篇论文针对MCMC方差大、控制变量难以构造的核心痛点,提出了一套基于可学习变量变换的解决方案。现有控制变量方法依赖泊松方程的闭式解,而这只在目标分布具有简单谱分解时才可行。研究者的关键洞察是:训练一个归一化流(双射),将复杂目标分布映射到结构简单的参考密度附近,马尔可夫核及其泊松方程的解会随双射一起被"搬运",从而在任意目标上获得显式控制变量。理论上,在温和尾部条件下估计量保持一致;实践中,重要性采样被识别为该框架的极限情形,体现出方法的通用性。实验在合成目标与真实贝叶斯后验上对标了当前最先进方法,验证了实际的方差缩减收益。
一个困扰蒙特卡洛方法的老问题
马尔可夫链蒙特卡洛(MCMC)方法是从复杂概率分布中计算期望值的标准工具。无论是贝叶斯推断中的后验估计,还是统计物理中的配分函数计算,MCMC 几乎无处不在。但它有一个老毛病——估计量的方差往往很大,意味着需要大量采样才能得到可靠结果。
控制变量(control variates) 是降低这种方差的经典手段。它的思路很直接:构造一个期望已知、且与目标函数高度相关的辅助变量,用它来"抵消"估计中的随机波动。但问题在于,一个真正有效的控制变量需要求解采样器的泊松方程(Poisson equation),而这个方程在绝大多数情况下根本没有闭式解。

泊松方程在马尔可夫链理论中扮演核心角色:给定目标函数 $f$ 和转移核 $P$,泊松方程形如 $(I - P)g = f - \pi(f)$,其中 $\pi(f)$ 是 $f$ 在平稳分布下的期望值。方程的解 $g$ 即为所求的控制变量——将 $g(X_{t+1}) - Pg(X_t)$ 加入估计量,可以在不改变期望的前提下大幅压低方差。直觉上,$g$ 捕捉了马尔可夫链的"累积相关性",利用它可以消除相邻样本间的冗余信息。问题的难点在于,$(I - P)$ 是一个定义在函数空间上的算子,只有当转移核 $P$ 具有可解析描述的特征函数展开时,方程才存在闭式解;对于一般的高维目标分布,这一条件几乎不可能满足。
现有方法的局限:只能解简单情形
当采样器的核在某个简单的参考密度上具有已知的**谱分解(spectral decomposition)**时,泊松方程的精确解才是可获得的。换句话说,现有的理论工具只能处理那些结构足够"干净"的目标分布——比如高斯分布这类参考密度。
可现实中的目标分布往往远比这复杂。真实的贝叶斯后验分布可能是高维、多峰、带有重尾的,谱分解无从谈起,闭式泊松解自然也就失效了。这正是这篇 arXiv 新论文(arXiv:2610.10870v1)试图突破的瓶颈。
核心思路:用可学习的变量变换架桥
论文提出的方法可以概括为一句话:通过学习一个变量变换,把复杂目标映射回能解析求解的参考空间。
具体来说,研究者训练一个双射(bijection)——典型实现就是归一化流(normalizing flow)——使得目标分布在隐空间(latent space)中接近那个结构简单的参考密度。关键的理论贡献在于,作者证明了:马尔可夫核及其泊松方程的解,在任意双射下都会被相应地变换过去。
这意味着原本只能在简单参考密度上求解的泊松方程,现在可以借助这个学习到的映射,"搬运"到任意复杂的目标分布上。
在隐空间运行采样器
一旦有了这个映射,整个流程就变得清晰:在隐空间中运行采样器,就能自然地得到显式的控制变量。而且,作者进一步证明,只要映射和目标满足温和的尾部条件(mild tail conditions),所得到的估计量是一致的(consistent)——这为方法的可靠性提供了理论保证。
重要性采样作为极限情形
一个有意思的发现是,从归一化流中进行重要性采样(Importance Sampling, IS) 恰好是上述构造的极限情形。这说明该框架不仅适用于 MCMC,同样的控制变量也能应用到重要性采样上,具有相当的通用性。
归一化流(Normalizing Flow) 是一类通过叠加可逆、可微变换来构造复杂概率分布的深度生成模型。其核心机制是利用变量替换公式:若 $z = T(x)$ 是一个双射,则 $x$ 的密度可以通过 $z$ 的(通常为简单高斯)密度与雅可比行列式的绝对值之积来表达。训练时,模型学习使隐变量 $z$ 的分布尽量接近标准参考分布,同时保持正向和逆向变换均可高效计算。在本文的场景中,归一化流不用于生成新样本,而是提供一个将复杂目标密度"压平"为参考密度的坐标变换——正是这个变换,让原本无法求解的泊松方程在新坐标下变得可解析处理。
重要性采样(Importance Sampling, IS) 是蒙特卡洛积分的另一类经典技术:从一个易于采样的提议分布 $q$ 中抽取样本,再用权重 $w(x) = \pi(x)/q(x)$ 修正偏差,从而估计目标分布 $\pi$ 下的期望。IS 可以看作"退化的"马尔可夫链——每个样本相互独立,链长为 1。当本文构造中的隐空间采样器退化为独立同分布采样时,控制变量方法自然收敛至重要性采样的形式。这一联系揭示出该框架的统一性:MCMC 和 IS 并非两套独立的工具,而是同一个基于映射的方差缩减框架在不同"链相关性"假设下的特例,从而使得同一套学习到的归一化流可以无缝服务于两类估计器。
实验验证:对标最先进方法
论文在两类场景下进行了实验:合成目标分布和真实的后验分布。对比对象包括当前最先进的采样器和控制变量方法。实验设计的意图很明确——证明这套"变换 + 控制变量"的组合拳在实际任务中确实能带来方差缩减的收益,而非仅停留在理论推导层面。
这项工作的意义
从方法论角度看,这篇论文最大的价值在于把归一化流这类深度生成模型,与经典的方差缩减理论打通了。归一化流近年来在生成建模领域大放异彩,而它在这里扮演的角色不是生成样本,而是作为一座"桥梁",把难解的泊松方程转移到可解的空间。
这种思路对实际的贝叶斯计算、科学模拟都有潜在吸引力:如果能用更少的样本得到同样精度的估计,就意味着更低的计算成本。当然,归一化流本身的训练开销、以及尾部条件在实际目标上是否成立,仍是落地时需要权衡的因素。
对于关注采样方法、变分推断与蒙特卡洛前沿的研究者来说,这是一条值得跟进的技术路线。
相关推荐
Claude Code团队实测:AI智能体如何重塑软件开发全流程
Claude Code团队核心成员实测分享:如何用AI智能体重塑软件开发全流程,涵盖Claude Tag、Workflows大扇出、代码审查、验证闭环与云端Loops,以及工程师角色从深耕细节到放大视角的转变。

WorkBuddy入门指南:腾讯桌面AI智能体能帮你干哪些活
WorkBuddy是腾讯推出的桌面AI智能体,可直接操作本地文件、打通微信飞书钉钉等国内软件。本文解析它与Codex的差异、使用成本、常见误区及实际应用场景,帮你从AI提问者进化为AI管理者。

腾讯开源 Octopus 实测:多 Agent 协作助手的定位尴尬与价值
腾讯开源 Octopus(Octop)实测体验:一款支持多用户、多 Agent 协作的 AI 助手,整合长期记忆、知识库、远程桌面、技能录制与腾讯生态连接器。本文解析其核心功能、安装流程、ACP 连接价值,以及与阿里 AgentScope 的定位差异。