别抽卡了!用本地大模型写HTML做视频,安全可控
用本地大模型生成单文件HTML,录屏代替渲染,实现可控且安全的视频素材生产。
文章介绍B站UP主提出的一种视频素材生产思路:把演示大纲和提示词交给本地大模型,生成带3D视差效果的单文件HTML动画,再用录屏软件录制后进入剪映剪辑,从而绕开AI视频生成「开盲盒」式的不可控。作者总结了四个高频坑位——代码截断、移动端布局崩坏、外部资源导致断网失效、录屏掉帧,并给出对应的提示词解法:分段输出、强制响应式、严禁外部字体图片、全屏60帧录制。相比云端AI视频,该方案的核心优势是逐帧可控与数据不出本地,适合商业敏感场景;但其边界也很明确,只擅长动效演示与片头,不覆盖实拍和复杂人物场景,且仍需一定前端排错能力。
AI视频生成常被比作"开盲盒"——你输入提示词,等待渲染,结果却充满随机性。一位B站UP主在"Strata生产力第二期"中提出另一种思路:让本地大模型写单文件HTML,用录屏代替渲染,实现精确可控的视频素材生产。这套玩法不仅绕开了AI视频的不可控性,还把数据安全握在了自己手里。
核心玩法:把大纲丢给大模型,生成可录屏的网页
UP主的做法极简:把演示大纲交给大模型,附上一段"咒语"提示词,要求生成单文件HTML,带3D视差效果,拒绝外部依赖代码。代码存成网页后,打开就是丝滑的演示动画。
做视频片头同理——换成故障风文字出场动画的提示词,生成后用录屏软件录制,再扔进剪映剪辑即可。UP主的原话是:"别人花几小时抽卡,你花三分钟录屏搞定。"
这套流程的价值在于精确控制:改字即改画面,每一帧都是你说了算。相比AI视频生成每帧不可控的特性,HTML做视频更像是"用代码画分镜",适合对画面有明确预期的场景。
单文件HTML指的是将HTML结构、CSS样式、JavaScript脚本全部写进一个.html文件里,不拆分、不依赖外部文件。这种形式的好处是复制即用、双击即开,无需搭建服务器或安装依赖,非常适合交给大模型一次性生成。3D视差效果则是利用CSS的transform: perspective()与translateZ(),或监听鼠标/滚动位置改变不同图层位移速度,制造出前后景分离的立体纵深感。它计算量小、兼容性好,不需要WebGL或Three.js这类重型库,因此在「拒绝外部依赖」的约束下,成为大模型生成演示动画的常用手法。理解这两点,就能明白为什么提示词里要强调「单文件」和「无外部依赖」——它们共同保证了产物在任何机器上都能离线稳定复现。
四个必踩的坑,和对应的填坑指令
UP主自称"踩坑搭子",用亲身经历试出了四个高频问题,每个都附带了提示词层面的解法:
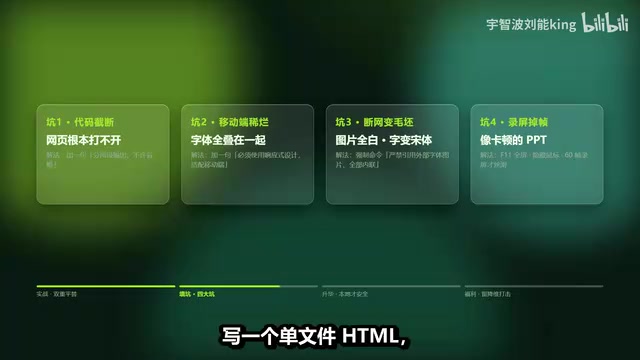
坑一:代码截断,网页打不开。 大模型输出长代码时容易中途省略。解法是在提示词中加一句"分两段输出,不许省略"。
坑二:电脑上绝美,手机上稀烂。 字体全部叠在一起,布局崩坏。解法是强制要求"必须使用响应式设计,适配移动端"。
坑三:断网变毛坯。 网页图片全白、字体变宋体,因为引用了外部资源。解法是命令大模型"严禁引用任何外部字体和图片,全部内置内联"。
坑四:录屏掉帧,像卡顿的PPT。 解法是浏览器按F11全屏、隐藏鼠标,使用60帧录屏才丝滑。
这四个坑覆盖了从代码生成到录制成片的完整链路,本质上都是"把隐性要求显性化"——你不说,大模型就默认偷懒。
为什么不用云端AI视频?安全是分水岭
有人会问:既然都是做视频,直接用网上的AI生成工具不行吗?
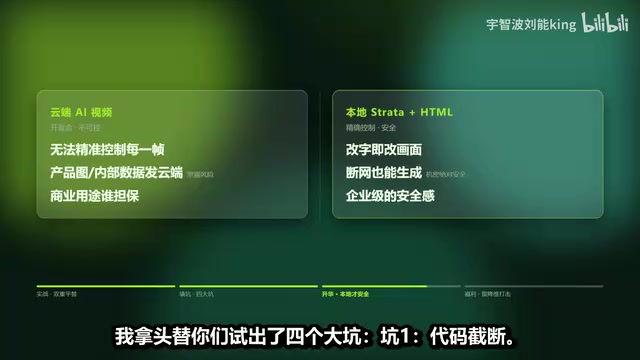
UP主的回答切中要害:"AI视频是开盲盒,你无法精准控制每一帧。"更关键的是商业场景——把公司产品图、内部数据发给云端,数据安全谁来保证?
HTML做视频的差异在于,它可以在本地跑。比如公司要做内部宣传片或未发布新产品的演示,用本地部署的大模型跑代码,断网都能生成。
UP主由此引申出一个观点:这就是大公司一定要建自己的本地算力的原因——只有本地大模型才能提供企业级的安全感。"只要你不懂代码,大模型就是你雇佣的顶级前端工程师。"
本地部署大模型指把开源模型(如Llama、Qwen、DeepSeek广告等系列)下载到自有显卡或工作站上运行,通过Ollama、LM Studio、vLLM等工具提供接口,推理过程不经过任何第三方服务器。与之相对的云端API,需要把提示词乃至产品图、内部文档上传到厂商服务器,存在数据留存与合规风险。本地部署的核心权衡在于:前期要投入GPU硬件与运维成本,模型能力通常略逊于顶级云端模型,但换来数据主权、断网可用和无限次调用。对企业而言,这正是「建自己的算力」的现实意义——敏感素材在闭环环境里生成,从源头切断泄露路径。
这套方法的边界在哪里
需要冷静看待的是,HTML录屏并非万能。它擅长的是文字动画、数据可视化、演示型片头这类结构化内容;对于实拍素材、复杂人物动作、真实光影场景,仍然需要传统拍摄或AI视频生成。UP主展示的片段也集中在动效演示范畴。
另一个隐性成本是提示词调试。四个坑的解法看似简单,但实际生产中,响应式适配、内联资源、分段的代码拼接都可能引入新的兼容问题,需要一定的前端排错能力。UP主提供的"三套动效提示词加四句填坑指令"降低了门槛,但距离"零基础出片"仍有距离。
不过对于有明确画面需求、又在意数据隐私的团队来说,这条路径提供了一种务实的中间态:比PPT模板灵活,比AI抽卡可控,比外包开发便宜。
背景补充
外部资源依赖是网页离线失效的根因。很多网页会通过<link>引入Google Fonts等网络字体,或用<img src="https://...">引用在线图床;一旦断网或跨域受限,字体回退到系统默认的宋体,图片则显示为空白。**内联(inline)**是解决办法:字体可用@font-face配合Base64编码的woff2数据嵌入CSS,图片可转成Base64的data: URI直接写进src,图标则可改用内联SVG。代价是文件体积变大、可读性下降,但换来的是完全自包含、断网可用——这恰好契合本地化、数据不出内网的诉求。
相关推荐
WorkBuddy智能体实战:从AI问答到自动办公的跨越
WorkBuddy是腾讯推出的AI智能体桌面工作台,能读取本地文件、操作办公软件、执行多步骤任务并定时自动运行。本文详解其核心功能、与传统AI工具的本质区别及适用场景。
Anthropic研究:LLM让形式化软件验证规模化成为可能
Anthropic Frontier Red Team研究显示,LLM已能在上百个真实开源库的RISC-V汇编级别批量生成形式化证明,覆盖123个OSS-Fuzz库、239个入口点,合计约1.8亿行Rocq证明,并在过程中发现数百量级Bug。文章解析其规格生成、证明流水线、信任边界与成本下降路径。
提示词工程入门:从写提示词到构建AI协作能力
从提示词的四大作用到提示词工程的六步流程,系统梳理AI提示词工程的核心概念、商业价值与三层局限性,帮助初学者建立对提示词工程的完整认知框架。