别再往CLAUDE.md塞两万行:10个技能砍掉上下文成本

用渐进式披露的技能与脚本替代两万行CLAUDE.md,重构Claude Code工作流。
文章指出,把海量规则堆进单个 CLAUDE.md 会让每次对话都支付高昂 token 税并稀释模型注意力。更优路径是采用 Agent Skills 规范:skill.md 仅暴露约 50 token 的 YAML front matter 描述,任务触发时才加载完整指令,机械工作交给确定性脚本。文章据此拆解 10 个技能,覆盖编码生命周期(Addy Osmani 的 25 技能加反合理化表)、代码库语义图谱(Graphify)、架构图规范生成、子代理编排(Superpowers)、证据驱动的前端性能优化(Web Quality Skills)、LSP 行级诊断,以及收尾的规划审查、长期记忆与安全审计,并强调组合成管线才是完整解法。
别再往CLAUDE.md塞两万行:10个技能砍掉上下文成本
如果你还把两千行架构规则、Linter 配置和 API 约定塞进一个 CLAUDE.md 文件,那你正在为每一次对话支付高昂的 token 税。更糟的是,在模型读到你的真实意图之前,庞大的冗余内容已经稀释了它的注意力机制。
据 B 站 UP 主 CodeRash with Gaurav 的系统梳理,资深工程师使用 Claude Code 的方式正在发生根本性转变:从单体式系统提示词,转向开放的 Agent Skills 规范(skill.md)与专用插件。核心逻辑是渐进式披露——会话启动时模型只读取约 50 token 的 YAML front matter 描述,只有当任务真正触发某个技能时,才加载完整的工作流指令,并把机械性工作交给技能文件夹内的确定性 Python 或 Node 脚本执行。
这篇文章拆解 10 个值得立即安装的技能,以及它们各自削减 token 浪费的具体机制。
渐进式披露:技能为何比塞提示词更省钱
传统做法把所有规则堆在一个文件里,每次对话都全量加载。而一个工程化良好的技能遵循四部分结构:skill.md(YAML front matter 中的 name 与触发描述 + 路由指令)、scripts(Claude 调用的确定性 Python/Node/bash 辅助脚本)、references(按需加载的深度文档)、assets(模板与 schema)。
以脚手架生成新后端端点为例:与其让模型每次逐 token 生成 800 行样板代码(慢、贵、易漂移),不如让 Skill Creator 把你的工作流固化成路由文件,并在 scripts 里放入确定性生成脚本。下次只需约 80 token 调用脚本,推理 token 全部留给定制业务逻辑。这是成本优化的底层逻辑,也是理解后续所有技能的前提。
YAML front matter 是 Markdown 文件开头由 --- 包围的元数据区块,常用键值对描述文档属性。在 Agent Skills 规范中,它承载技能的 name 与触发描述,模型只需扫描这几十个 token 就能判断当前任务是否与该技能相关,而无需加载正文。这种“先看目录、再翻正文”的机制正是渐进式披露能够大幅削减上下文成本的关键,也让技能文件同时具备人类可读性与机器可路由性。
确定性脚本 指行为可预测、相同输入必得相同输出的程序,与模型逐 token 采样生成形成对照。把样板代码生成、文件解析、图表渲染等机械工作放进技能文件夹内的 Python/Node/bash 脚本,模型只需以少量 token 发起调用并读取结构化结果,既避免了生成漂移,也把推理预算集中留给真正需要判断的业务逻辑。
编码工作流:Addy Osmani 的 Agent Skills
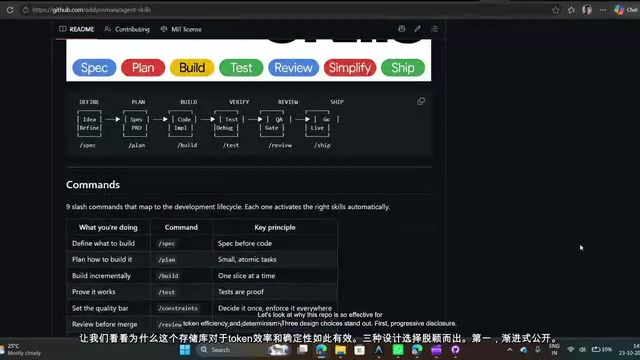
排名第一的是 Addy Osmani 的 agent skills 仓库,据视频介绍已获超 10 万 star,被视作编码高级工程工作流的黄金标准。它打包了 25 个独立技能,映射到 9 个斜杠命令,覆盖 spec、plan、build、test、review、simplify、ship 等完整生命周期。
三个设计选择让它兼顾 token 效率与确定性。其一是渐进式披露;其二是每个技能内嵌一张“反合理化表”——列出模型跳过步骤时常用的借口,并配上硬性反驳,阻止 Agent 走捷径;其三是把机械工作下放给脚本。
具体到日常高频使用的技能:interview me / idea-refine 在写第一行代码前,用一次一个的尖锐问题逼你暴露隐藏假设,收敛出最小规格,而不是让模型幻觉出 500 行假设;planning and task breakdown 读取你的代码库约定,输出带验收标准的原子任务清单;code simplification 在保持输入输出、副作用与错误顺序不变、且不修改测试的前提下,剥离认知复杂度;code review 则在合并前执行正确性、安全性、可维护性、性能等五轴审查。
代码库探索:Graphify 把仓库变成知识图谱
第二大 token 黑洞是代码库探索。把 Claude Code 丢进棕地仓库或多服务架构,它通常会跑 grep、find、cat 横扫四十个文件,等它搞清数据库关系与 API 路由时,八万 token 已经烧掉了。
Graphify 是一个开源技能,把整个项目文件夹转成可查询的语义知识图谱。它不只解析 TypeScript 或 C# 的 AST,还读取 SQL schema、架构 PDF、Markdown 笔记乃至 UI 脚本,抽取语义实体并链接成三类输出:交互式 graph.html 依赖可视化、链接式 Obsidian 架构库、以及可被 Claude 直接查询的压缩结构摘要。
一个具体场景:修改基于 Supabase 的投资者验证表后,你想知道改动在 Fly.io 上的 Node.js API 与 React 前端中的爆炸半径。Claude 读取图谱节点即可立刻看到下游消费者,据视频称探索 token 削减超过 80%,同时避免边缘路由的破坏性变更。
AST(抽象语法树) 是源代码语法结构的树状表示,每个节点对应一种语言构造,如函数声明、条件分支或类型注解,剥离了空白与注释等无关细节。借助 AST,Graphify 能跨 TypeScript、C# 等语言抽取函数、类与模块间的调用和引用关系,而不只是做文本匹配;再结合 SQL schema、架构文档等非代码源,最终拼成覆盖整个仓库的语义实体网络。
架构图与子代理编排:Artifact Diagramming 与 Superpowers
让模型画架构图或时序图,往往要花四轮追问去修 Mermaid 语法、被裁切的标签、深色背景上的黑字。Artifact Diagramming 在生成第一个 token 前先加载 Anthropic 内部的制图规范,强制三条规则:用内联 SVG 与 HTML/CSS 而非脆弱的 Mermaid;写入精确几何坐标与边界框避免标签碰撞;用语义化 CSS 变量与调色板校验,保证深色和浅色模式下都清晰可读。配合本地渲染脚本,模型只写声明式 SVG,确定性脚本输出生产级 PNG 或 WebP,零图像幻觉、零重复提示。
Jesse Vincent 的 Superpowers(据视频称近 30 万 star)则是一套有主见的完整开发方法论,靠子代理编排解决上下文污染。流程是:拦截提示词、强制苏格拉底式澄清并输出设计规格;批准后用 git worktree 创建隔离分支并验证干净测试基线;把规格拆成 2 到 5 分钟的微任务;交由子代理执行——子代理先删掉代码、强制写出失败测试再实现,任务通过代码审查后子代理终止,所有草稿噪音随之消失。据视频数据,主会话从开工到 PR 全程可保持在 15000 token 以内。
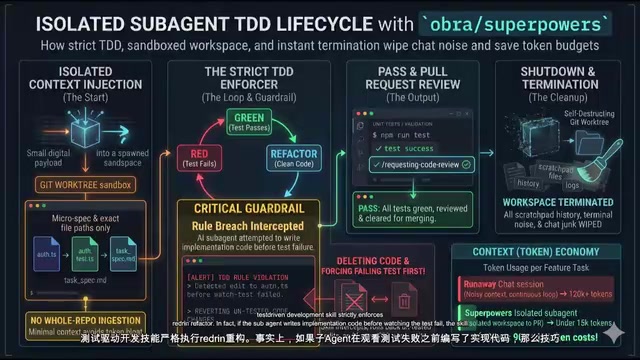
git worktree 允许在同一个仓库上同时检出多个工作目录,各自指向不同分支而共享同一份对象库。Superpowers 借此为每个微任务创建隔离分支,子代理在其中删码、写失败测试、实现并送审,主工作区始终保持干净基线;任务完成后临时 worktree 可被丢弃,草稿与调试噪音不会回流到主会话,从而把上下文污染控制在最小范围。
证据驱动的前端优化:Web Quality Skills
让通用模型优化 React 性能,它往往靠猜:随手给函数套 useCallback 和 useMemo,浪费 token、弄乱代码,却没改善真实用户延迟。Addy Osmani 的 Web Quality Skills 强制证据驱动。
配合 Chrome DevTools MCP 服务器,它启动本地 dev server 或命中 Cloudflare Pages 预览 URL,采集运行时 trace、LCP、INP 与 CLS,并严格区分“实测运行时故障”与“源码假设”。它还会校验面向 Agent 的浏览信号,例如结构化 JSON-LD、LLMs.txt 与 WebMCP 端点。结果是:你只为 DevTools trace 证实的那个关键渲染路径瓶颈付费,而不是为十个组件的猜测重写买单。
类型检查与工程纪律:LSP 插件与收尾工具
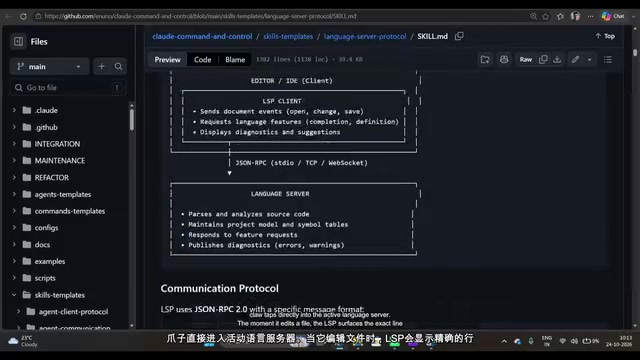
在强类型代码库中不使用 LSP 插件,Claude 改完文件会跑构建、等十二秒,再把四百行嘈杂输出灌进上下文,只为找一个缺失的接口属性。启用 TypeScript、Rust、C# 的 LSP 插件后,模型直接接入活跃的语言服务器,编辑瞬间就拿到行级类型错误或编译器诊断,据视频称不到 50 token,反馈环路更紧、每会话省下数千 token。
收尾环节同样有讲究。Planotator 把原生 plan 模式升级为可交互的工件式审查界面,让你在模型写任何实现代码前逐条批注并批准架构;CloudMeme 用压缩的语义长期记忆替代跨会话反复解释架构决策,只按当前模块检索相关历史。Shipyard 则在交付前跑专用安全审计子代理和跨任务重复检测,自动合并与既有工具函数重复的代码。另外两个走红技能针对过度工程:Karpati Coding Guidelines 要求先想后写、只做外科手术式改动、绝不动无关代码;Caveman 用七级简化阶梯把 Agent 逼到最懒但正确的最小路线,同时保留安全、输入校验与可访问性。据视频称,二者可削减 30% 到 40% 的生成输出 token。
把它们当作一套系统
单个技能解决单点问题,组合起来才是完整管线:用 Graphify 无 grep 地理解仓库,用 Addy Osmani 的 spec 与 planner 锁定设计,用 Superpowers 在隔离子代理中配 LSP 执行,最后用 WebPerf 与 Shipyard 在合并前验证。对于每天与 Agent 协作的工程师,这比继续往 CLAUDE.md 里堆两万行更划算,也更接近可审查、可复现的工程纪律。
相关推荐

农业革命另一面:疾病如何帮农民击败狩猎采集者
历史学者Kyle Harper解读农业社会如何击败狩猎采集者:不仅靠单位土地能量提取效率带来的人口增长优势,还依靠定居生活催生的病原体在扩张中造成额外死亡率,形成双重替代机制。

渐进式披露让Agent提速2.3倍:上下文工程新思路
Hacker News讨论提出用渐进式披露优化AI Agent上下文,实现2.3倍提速。本文解析上下文膨胀的三大性能损耗,介绍分层工具目录、按需检索、历史压缩等实践路径及落地注意事项。
Perplexity Computer 登陆 Mac:本地运行模型与智能体
Perplexity Computer 登陆 Mac:本地运行模型与智能体
Perplexity Computer 现可在 Mac 上完全本地运行,模型与智能体均在设备端执行,支持原生 Mac 应用和本地文件,敏感数据无需上传云端,已在 Perplexity Mac 应用上线。