并行思维新突破:DPT如何让大模型推理路径更多样

DPT通过惩罚并行路径前缀相似度,解决强化学习并行思维的模式崩溃问题。
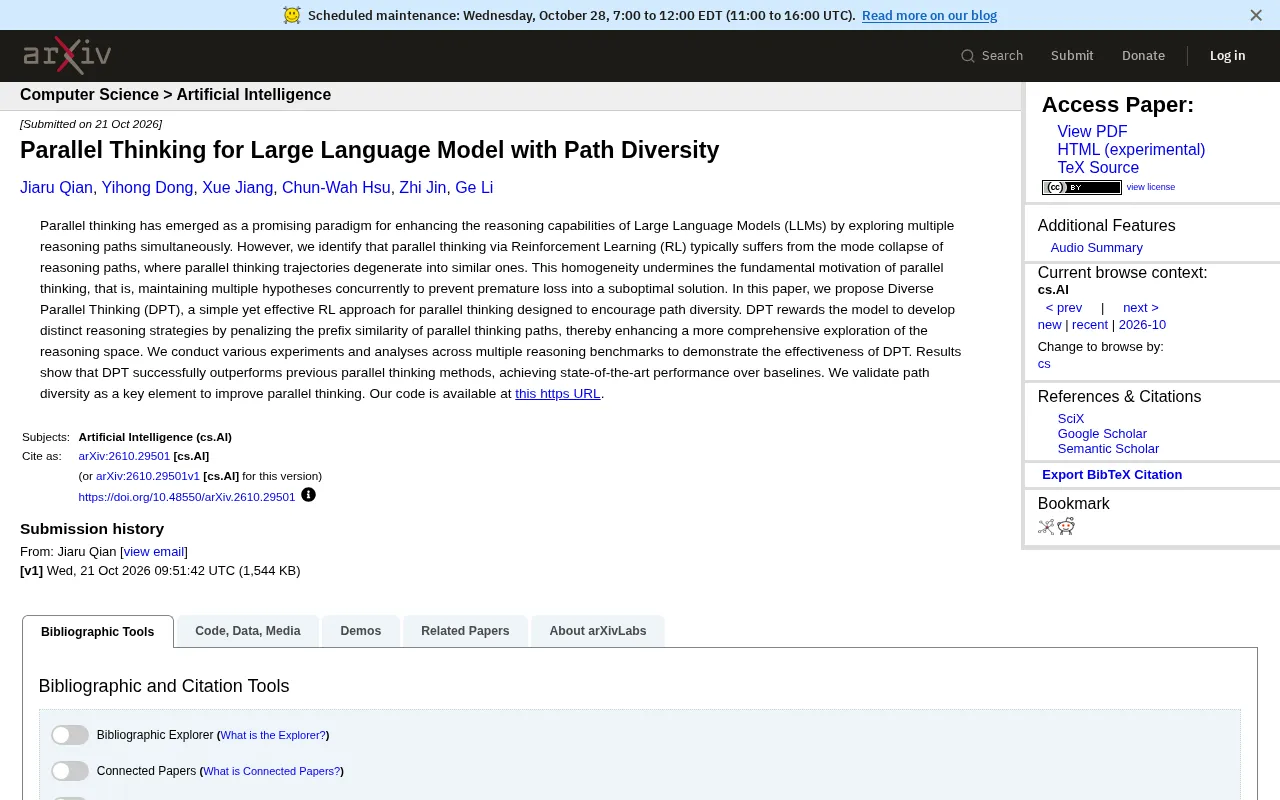
文章指出,用强化学习训练大模型进行并行思维时存在模式崩溃:多条推理路径退化为相似轨迹,失去同时维护多个假设的价值。为此,研究者提出Diverse Parallel Thinking(DPT),在奖励函数中对路径前缀相似度施加惩罚,引导模型发展真正不同的推理策略。实验表明,DPT在多个推理基准上超越已有并行思维方法,达到当前最优性能,验证了路径多样性是提升并行思维效果的关键要素。代码已开源。文章也讨论了惩罚强度设定、单路径质量权衡等开放问题。
并行思维为何需要「路径多样性」
让大模型同时探索多条推理路径,是提升其推理能力的有效思路。但一项新研究发现,主流做法——用强化学习训练模型进行并行思维——存在一个根本性缺陷:模式崩溃。模型输出的多条并行路径会退化成高度相似的轨迹,失去了并行思维本应具备的「同时维护多个假设」的价值,最终仍可能过早收敛到次优解。
针对这一问题,研究者提出 Diverse Parallel Thinking(DPT),一种简单却有效的强化学习方案,核心目标是鼓励模型产生真正多样化的推理策略。
模式崩溃(Mode Collapse)原是生成模型(如GAN)中的术语,指生成器倾向于只产出少数几种样本,而无法覆盖数据分布的全部模式。在强化学习语境下,模式崩溃表现为策略过早收敛到少数高奖励轨迹上,丧失探索能力。对并行思维而言,模型可能发现某类推理路径更容易获得奖励,于是反复生成相似轨迹,使得多条并行路径的「多样性」名存实亡。理解这一概念有助于认识DPT为何要从奖励函数层面进行干预,而非仅靠增加采样温度或路径数量。
DPT如何运作:用惩罚机制换取推理广度
DPT 的设计思路相当直接:在强化学习的奖励函数中,对并行思维路径之间的前缀相似度施加惩罚。当多条路径在开头阶段就高度重合时,模型会受到负面反馈,从而被引导去发展彼此不同的推理策略。
这一机制的价值在于,它把「路径多样性」从一种期望变成了可优化的目标。传统并行思维方法往往假设多条路径会自然分化,但实际情况是,强化学习容易将模型推向同一类高概率轨迹。DPT 通过惩罚前缀相似性,实质上是在扩大模型对推理空间的探索范围。
论文指出:路径多样性是改进并行思维的关键要素,而非可有可无的副产品。
前缀相似度衡量的是多条推理路径在起始阶段的重合程度。常用计算方式包括对路径前若干token的n-gram重合率、编辑距离或嵌入向量的余弦相似度。若两条路径开头高度一致,说明模型在推理早期就做出了相同决策,后续分化的空间被压缩。DPT在奖励函数中加入前缀相似度惩罚项,相当于对「过早锁定同一思路」的行为施加成本,从而激励模型在推理初期就探索不同方向。惩罚强度的系数需要权衡:过强会损害单条路径的连贯性,过弱则难以打破模式崩溃。
实验验证:超越已有并行思维方法
研究者在多个推理基准上开展了实验与分析,结果显示 DPT 成功超越了此前的并行思维方法,在基线对比中达到当前最优性能。
这一结果的意义不仅在于分数提升,更在于它验证了一个判断:并行思维的效果瓶颈,可能并不在于路径数量不够,而在于路径之间的差异不足。DPT 用较小的方法改动换来了显著的性能增益,说明路径多样性确实是值得单独优化的维度。
研究者已将代码开源于 GitHub(JiaruQian/DPT),便于社区复现与进一步探索。
推理基准(Reasoning Benchmark)是评估模型逻辑推理能力的标准化测试集,常见的有GSM8K(小学数学应用题)、MATH(竞赛级数学题)、StrategyQA(多跳常识推理)等。这些基准通常要求模型进行多步推导,且答案可自动验证,因此适合衡量并行思维方法是否真正提升了推理深度与广度。DPT在多个此类基准上取得最优,说明路径多样性带来的增益具有跨任务的可迁移性,而非仅对某一类问题有效。
对并行思维范式的启示
并行思维被寄予厚望,是因为它模拟了人类在复杂问题中同时权衡多个假设的过程。但如果多条路径最终殊途同归,这种「并行」就只剩下形式上的并行,计算开销换来的信息增量有限。
DPT 的贡献在于把问题定位到了训练信号层面:与其在推理阶段简单增加采样数量,不如在训练阶段就让模型学会「分头行动」。这一思路对后续的推理增强研究具有参考价值,也提示我们重新审视强化学习在并行思维任务中的奖励设计。
当然,前缀相似度惩罚的强度如何设定、是否会牺牲单条路径的质量、以及在不同规模模型上的泛化表现,仍需更多实验来回答。论文的开放代码为这些后续问题提供了起点。
相关推荐
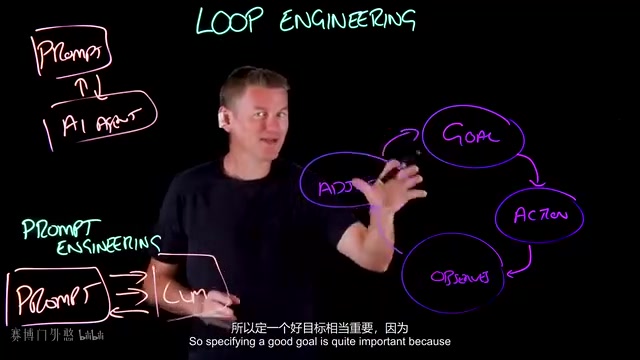
什么是循环工程?AI智能体自动化工作流全解析
循环工程是什么?本文详解AI智能体如何通过目标设定、行动观察闭环、上下文管理、MCP工具调用与子智能体验证构建自动化工作流,并剖析理解债务、意图债务、认知投降等人类参与陷阱。

人形机器人G1学会爬梯越野:单一策略控制九大身体部位
研究人员为Unitree G1开发单一控制策略,让机器人用双手、肘、膝、脚和骨盆支撑,完成爬梯、匍匐、翻越障碍等动作,模拟环境成功率92.5%,真实世界迁移仍是关键考验。
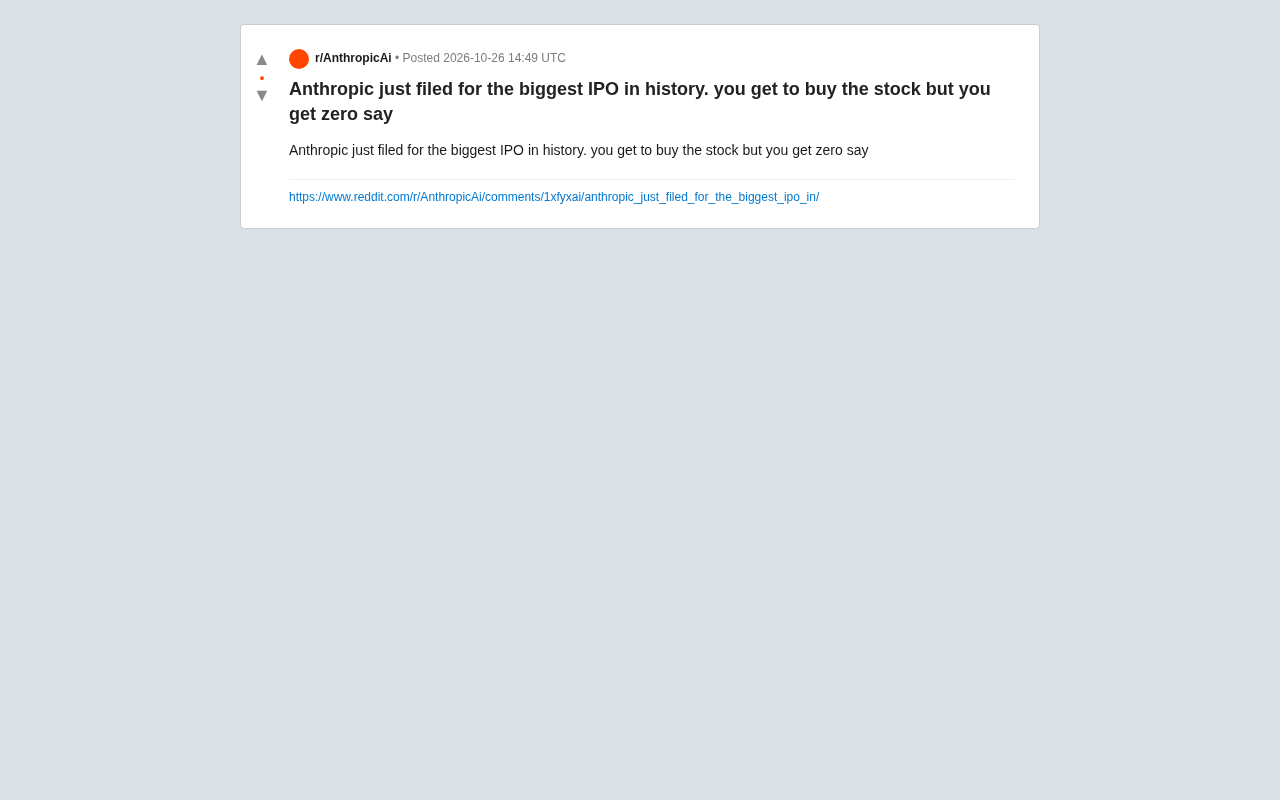
Anthropic被曝启动史上最大IPO 散户只能买股无权投票
Reddit爆料称Anthropic启动史上最大IPO,散户可买股票却无投票权。本文分析这一消息背后的AI资本热潮、无投票权股权结构的利弊,以及对AI投资格局的潜在影响,并提醒爆料尚未经官方证实。