Browser Use:事件驱动的浏览器 AI Agent 框架详解

让大模型完成一个真实网页任务——打开搜索引擎、输入关键词、点击结果、读取页面信息——问题就不只是模型会不会回答了。它还需要看见当前页面、理解哪些元素可以操作、决定下一步动作,然后真的把动作执行到浏览器里。开源框架 Browser Use 做的正是这件事。
Browser Use 是一个事件驱动的 AI Agent 框架,核心能力是让 LLM 根据自然语言任务描述自主驱动浏览器操作。用户只需描述目标,Agent 便会持续执行一个循环:观察页面、做出决策、采取行动。本文围绕三个问题展开:它提供哪些核心能力、为什么采用事件驱动分层解耦的架构、它如何把浏览器控制、工具注册、Skills、Sandbox 和 MCP 整合进同一个 Agent 循环。
一句话理解 Browser Use
Browser Use 不是一个写死流程的浏览器脚本,而是让 Agent 根据自然语言任务自主操作浏览器的框架。这里有三个关键词。
自然语言驱动。用户描述目标之后,Agent 进入多步循环:观察当前页面状态,将观察结果与历史上下文交给 LLM,由模型决定下一步是点击、输入、导航还是继续读取页面。
多 LLM 供应商支持。Browser Use 通过可插拔的 Provider 适配器接入不同大模型,包括 OpenAI、Anthropic、Google 等。框架层专注于浏览器 Agent 的执行机制,而不绑定在某一个模型上。
事件驱动解耦。事件驱动架构(EDA,Event-Driven Architecture)将系统组件之间的直接调用关系替换为事件发布/订阅机制,发布方不需要知道订阅方的存在。这种架构源于分布式系统和消息队列领域——在传统同步调用中,组件A调用组件B时必须了解B的存在并等待响应,造成强耦合;而在EDA中,A只负责发布事件到事件总线,B订阅感兴趣的事件类型,两者互不知晓。在 AI Agent 框架中,这种设计尤其适合处理遥测、日志、UI 更新等横切关注点(Cross-cutting Concerns)——若将这些逻辑直接写入主循环,代码会迅速膨胀且难以维护;通过EDA,新功能可以通过增加订阅者而非修改核心代码来实现,这正是开闭原则(Open/Closed Principle)的实践体现。Browser Use 基于 Bubus 事件系统实现这一模式,把核心流程与外围关注点分离,遥测、UI 更新等逻辑可以订阅事件,无需侵入 Agent 的核心循环。这也是现代 Agent 框架区别于传统 RPA 脚本的重要架构特征。Browser Use 不是点一下按钮的自动化工具,而是把 LLM 推理、浏览器自动化和工具执行放进同一个框架里。
浏览器 Agent 要解决的四类问题
一个浏览器 Agent 真正跑起来,至少要解决四类问题。
DOM 表示。LLM 无法直接理解浏览器内部复杂的 DOM 对象。Browser Use 需要把页面转成结构化、token 高效且适合模型消费的表示,让模型知道页面上有哪些内容、哪些元素可以点击、当前任务推进到了哪里。
动作注册表。Agent 做出决定后,必须有一层把点击、输入、导航、滚动等动作映射成真正可执行的浏览器操作。Browser Use 内置了常见浏览器操作,同时允许开发者扩展自定义动作。
循环检测与判定。浏览器任务往往不是一次性完成,Agent 有可能在页面里打转——反复点击同一个元素,或始终无法到达目标。Browser Use 内置 judge 机制,用来评估 Agent 是否陷入循环并尝试恢复。
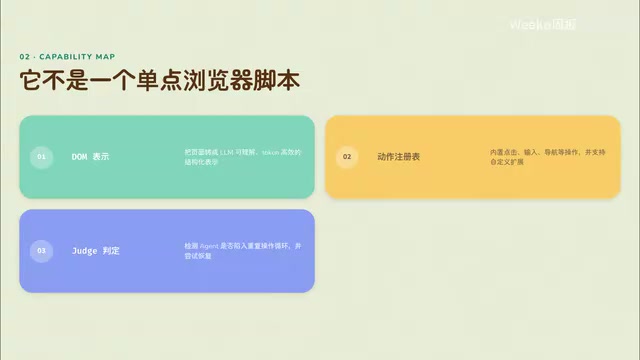
能力扩展。Skills、Sandbox 和 MCP 让 Browser Use 不只是本地浏览器自动化工具,还可以承载更具体的领域任务、远程执行环境以及 Model Context Protocol 集成场景。把这四类能力放在一起看,Browser Use 的定位就很清晰:核心不是某一个浏览器动作,而是让浏览器 Agent 能够持续感知、判断、执行和扩展。
事件驱动分层解耦的四层架构
Browser Use 采用事件驱动分层解耦的设计,所有子系统通过 Pydantic 模型和事件信号解耦,目的是提高可测试性与可扩展性。Pydantic 是 Python 生态中主流的数据验证库,通过类型注解在运行时强制校验数据结构。在 AI Agent 框架中,它的价值不仅在于数据校验本身,更在于构建了一道安全隔离层:LLM 的输出本质上是自然语言文本,即便经过格式化(如 JSON 模式),仍可能包含类型不匹配、字段缺失或值越界等问题。Pydantic 通过声明式模型定义将这些潜在错误拦截在执行层之外——当 LLM 返回的动作参数不符合预期 Schema 时,Pydantic 会在参数传入浏览器操作之前抛出 ValidationError,而非让错误的值静默流入底层执行。Browser Use 更进一步,利用 pydantic.create_model 在运行时动态生成参数 Schema,这种「代码即文档即验证」的模式是现代 Python AI 框架(包括 LangChain、FastAPI 等)的共同趋势。核心架构分为四层。
Agent 层是核心编排器,负责管理对话历史、构建系统提示、执行 judge 判定,以及在上下文变长时做消息压缩。Agent 层决定整个任务循环如何推进。
LLM 层通过 Provider 适配器调用大模型,职责是根据当前观察结果和上下文决定下一步动作。
Tools(Registry)层负责把 LLM 返回的动作解析成具体的操作名称和参数。它通过动态 Pydantic 模型生成动作参数 Schema,再把动作分发到对应的 RegisteredAction。Browser Use 利用 pydantic.create_model 在运行时动态构建这些 Schema,使 LLM 的输出能够被精确映射到对应的浏览器操作,这是目前 AI Agent 框架处理工具调用参数验证的主流模式。
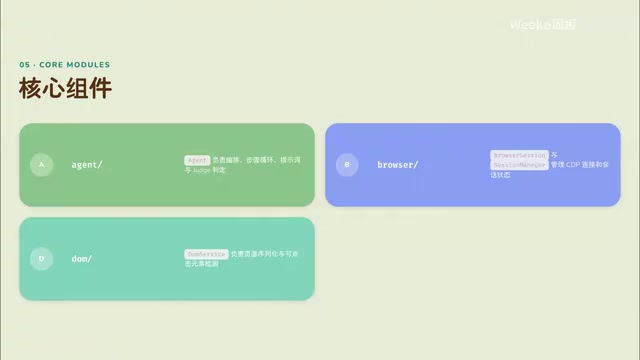
Browser 层通过 Chrome DevTools Protocol(CDP)与浏览器通信。CDP 最初是 Chrome 浏览器为其内置开发者工具(DevTools)设计的内部通信协议,大约在 2011 年随 Chrome DevTools 诞生,并于 2017 年作为官方 API 正式开放。CDP 基于 JSON-RPC 规范,通过 WebSocket 进行双向通信,将浏览器几乎所有内部能力暴露为可编程接口,涵盖页面导航(Page 域)、DOM 操作(DOM 域)、JavaScript 执行(Runtime 域)、网络拦截(Network 域)等数十个功能域。Playwright、Puppeteer 等主流自动化框架均基于 CDP 构建。相比更早的 Selenium WebDriver(基于 HTTP 的 W3C 标准协议),CDP 的 WebSocket 长连接具有更低的命令延迟,且支持浏览器主动推送事件(如页面加载完成、网络请求发出等),对需要实时感知页面状态变化的 AI Agent 尤为重要。Browser Session 负责浏览器会话,Session Manager 管理所有 Target 和 Session 的状态。
四层合起来对应一条完整数据流:Agent 组织上下文 → LLM 决定动作 → Registry 解析并分发动作 → Browser Session 发送 CDP 命令 → DOM Service 提取新页面状态 → 再回到 Agent 进入下一轮。这个循环就是 Browser Use 的骨架。
从模块划分看,项目将 Agent(编排)、Browser(会话与 CDP)、DOM(页面感知)、Tools(操作分发)拆成可独立测试的模块,另有 LLM、MCP、Skills、Sandbox、Telemetry 等子系统。这不是把所有逻辑塞进一个大循环,而是一张清晰的架构地图。
Agent 核心循环:观察、决策、行动
Browser Use 的核心方法是 step,它执行严格的三阶段循环,并重复直到任务完成或达到步数上限。
观察阶段:Agent 通过 DOM Service 获取当前页面的增强 DOM 树和截图。这里的观察不是简单读取 HTML 字符串,而是把页面状态整理成模型可消费的结构化信息。
决策阶段:Agent 将观察结果连同对话历史交给 LLM,模型根据当前页面、任务目标和已发生的动作,返回下一步要执行的操作。
行动阶段:Registry 解析 LLM 输出,匹配到对应的 RegisteredAction,然后执行浏览器操作,例如点击、输入、导航、滚动或自定义工具动作。
循环背后还有几个控制机制:judge 判定用于评估 Agent 是否在原地打转,检测到循环就尝试恢复;消息压缩用于处理上下文过长的问题;生命周期控制支持暂停、停止和切换到新任务。Agent 循环不只是问模型下一步做什么,还要处理长任务里的上下文管理、失败恢复、重复检测和控制权交接。
稳定驱动浏览器:CDP 与感知层
浏览器 Agent 能否可靠工作,很大程度上取决于它能否稳定驱动浏览器。Browser Use 直接基于 CDP(Chrome DevTools Protocol)与浏览器通信。CDP 中有两个核心概念:Target(可以是页面、iframe 或 Worker)和 Session(附加到某个 Target 上的通信通道)。
Browser Use 里的 Session Manager 是所有 Target 和 Session 状态的唯一事实来源,会话状态被集中管理而不是散落各处。这带来一个实用能力——并发观测:一个 Session 负责 DOM 提取,另一个 Session 同时负责截图。对 Agent 来说,这意味着它可以同时获得结构化页面信息和视觉状态。
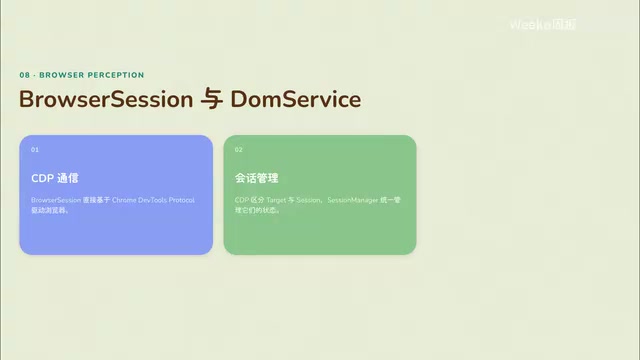
DOM Service 是感知层核心,它编排三个并行的 CDP 数据流——DOM 树、Accessibility 树和 DOM Snapshot,融合成统一的 Enhanced DOM Tree,最终序列化成 LLM 可消费的格式。这里值得特别说明的是 Accessibility 树(无障碍树,AX 树)的作用:它是浏览器为屏幕阅读器(如 NVDA、VoiceOver)设计的页面语义表示,以结构化方式描述页面中的交互元素、角色和状态。AX 树中的每个节点都有 role(如 button、link、textbox)、name(人类可读的元素标签)、state(如 checked、disabled、focused)等语义属性,而不是 CSS 类名或像素坐标。对 AI Agent 来说,AX 树相比原始 HTML DOM 具有显著优势:一个现代 Web 应用的完整 HTML 可能包含数万行标签,其中大量是样式 div、布局容器和装饰性元素,直接输入 LLM 会消耗大量 token 且引入噪声;而 AX 树自动过滤了纯视觉结构,只保留语义上有意义的交互元素——一个登录表单在 AX 树中可能只有「用户名输入框」、「密码输入框」和「登录按钮」三个节点,与任务相关的信息密度远高于原始 DOM。Browser Use 将 AX 树与 DOM 树和 DOM Snapshot 三路融合,既获得了语义精准性,又保留了坐标定位能力。重点在于:浏览器页面不是直接丢给模型,而是经过专门的感知层压缩、结构化和增强,这样 Agent 才能更稳定地判断下一步动作。
可靠执行层:Tools 与动态 Pydantic 模型
LLM 做出决策后,需要一个可靠的执行层。Browser Use 里的 Tools(也叫 Controller)是操作分发层,内置了点击、输入、导航、滚动等核心操作。核心数据模型是 RegisteredAction,每个动作注册时都携带函数签名、描述和参数模型。
关键特性是动态 Pydantic 模型生成:Browser Use 用 pydantic.create_model 在运行时根据函数签名构建动作参数 Schema,LLM 返回的动作参数因此可以被结构化、有效地解析,而不是作为随意字符串直接执行。这种方式确保了每次工具调用都经过类型校验,从根本上规避了将未经验证的模型输出直接传入浏览器操作的安全风险。这种「代码即文档即验证」的模式让框架在开发者注册自定义动作时能自动从函数签名推断参数约束,无需手动编写 Schema 定义。
若默认动作不够用,开发者可通过装饰器注册自定义动作。框架还支持动作排除——某些内置动作在特定任务里不希望开放,可以在初始化或运行时排除,从而收窄 Agent 的可用动作集合。这一层的价值是把模型的自然语言式决策,转成可验证、可分发、可控制的工具调用。
三类扩展能力:Skills、Sandbox、MCP
除了核心循环,Browser Use 还提供三类扩展能力,分别代表三个方向。
Skills 是声明式、基于 Markdown 的能力包,定义 Agent 在特定领域中的操作方式。某个领域任务有固定步骤、注意事项或操作流程,就可以通过 Skill 复用这些知识。Skills 可通过 CLI 安装到不同编码助手的目录中,包括 Claude、Cursor、Codex 和 Copilot 等。
Sandbox 是远程执行的桥梁。通过装饰器,本地函数可以被序列化后发送到远程服务器执行,执行时还可以注入浏览器会话,并通过 SSE 将结果流式传输回来。Skills 和 Sandbox 共用 Browser Use API Key 作为认证凭据。
MCP 集成:Browser Use 支持 Model Context Protocol(MCP)。MCP 由 Anthropic 于 2024 年 11 月发布并开源,是一项旨在标准化 LLM 与外部工具、数据源之间通信方式的开放协议。在 MCP 出现之前,每个 AI 应用都需要为每个外部工具单独实现集成逻辑,导致工具生态严重碎片化。MCP 借鉴了 Language Server Protocol(LSP)的设计思路——LSP 统一了 IDE 与语言服务器之间的通信,使任意编辑器无需为每种语言单独开发支持;MCP 同样为 AI 应用提供了统一的工具调用接口,使不同的 LLM 客户端(如 Claude Desktop、Cursor、Windsurf)能够通过同一协议接入各类服务器端工具。2025 年初,OpenAI、Google 等主要 AI 厂商相继宣布支持 MCP,使其迅速成为 AI 工具互操作性的事实标准。Browser Use 以 MCP 服务器模式运行后,任何兼容 MCP 的 AI 客户端都可以直接调用 Browser Use 的浏览器控制能力,大幅降低了浏览器自动化能力的接入成本。
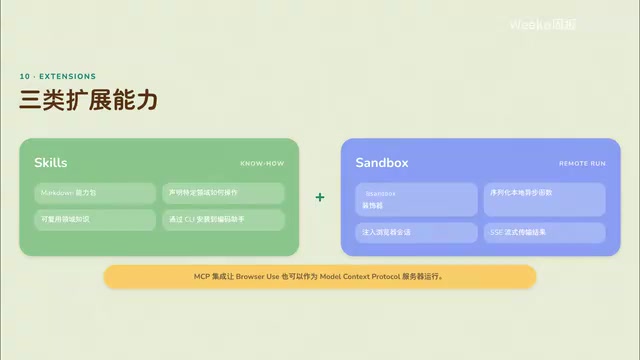
这三类能力让 Browser Use 的扩展点不是临时补丁,而是被纳入了框架边界:Skills 提供可复用的领域操作指示,Sandbox 提供远程执行能力,MCP 负责接入更广的生态。
快速上手与总结
安装方面,可以使用 uv add browser-use 或 pip install browser-use,也可以运行 browser-use init 快速创建项目。最小示例:从 Browser Use 导入 Agent,从 LangChain OpenAI 导入 ChatOpenAI,创建一个 Agent 并传入自然语言任务(如「去 Google 搜索 Browser Use」)和一个 LLM 实例(如 GPT-4o),最后调用 await agent.run()。
这几行代码背后启动的不是一次简单请求,而是完整的浏览器 Agent 循环:观察页面、调用模型、解析动作、执行浏览器操作、继续下一轮。这也是 Browser Use 想提供的开发体验——入门只需极少代码,但底层已经把浏览器会话、DOM 感知、工具分发和循环控制都组织好了。
总结来看,Browser Use 本质上是一个事件驱动的 AI Agent 编排框架,把 LLM 推理、浏览器自动化和工具执行统一到同一个循环里:Agent 层负责编排,LLM 层负责决策,Tools 层负责执行,Browser 层负责通信,DOM Service 负责把真实页面转成 Enhanced DOM Tree。这套分层设计带来三件事:易上手——几行代码即可运行一个浏览器 Agent;可测试——子系统通过 Pydantic 模型和事件信号解耦;可扩展——自定义工具、Skills、Sandbox 和 MCP 均可接入。如果你正在关注浏览器自动化、网页任务 Agent,或想深入理解一个浏览器 Agent 框架如何组织感知、决策和行动,Browser Use 是一个很值得拆解的项目。
核心要点
核心要点
相关推荐
 科技前沿
Caro揭秘:LBJ如何用伪装骗过种族隔离派
罗伯特·卡罗在LBJ传记中记录前参议员塔尔梅奇的采访:约翰逊初入参议院时刻意迎合南方保守派,塔尔梅奇称未察觉其民权倾向。掌权后约翰逊推动1964年民权法案与1965年投票权法案,揭示政治伪装与改革时机的关系。

Commodore 64经典赛车游戏迎来Driver AI
探索Commodore 64经典赛车游戏《Stunt Car Racer》中的Driver AI实验,了解在资源受限的8位平台上实现自动驾驶AI的技术挑战与启示。

黄仁勋若被替换,开源AI会否生变?Reddit激辩
Reddit网友激辩:如果黄仁勋被替换,英伟达会反对开源AI吗?讨论指出英伟达支持开源AI源于商业利益,需拓宽GPU客户群,而非一人决策。