不用向量数据库:fastembed + numpy 手写余弦相似度

个人简历RAG无需向量数据库,JSON加一次矩阵乘法即可,关键是TOP_K要小到保持得分差距。
文章以JobCopilot为例,展示了一套约60行代码的小规模RAG流水线:用正则按标题切分简历,fastembed的BAAI/bge-small-en-v1.5模型生成384维向量并在构建时归一化存入JSON,运行时通过一次矩阵乘法完成全扫描检索。作者重点记录了从教程复制的TOP_K=12如何让排序退化为批量加载,使噪声块被塞进提示词,并总结出TOP_K应小到保持最高分与其余分数可见差距的规则。提示词拼接则按字符预算在块边界截断,避免超长块和半截内容。文章的核心结论是:在小语料下,向量存储可以就是一个JSON文件加一次矩阵乘法,复制来的默认值需要按自己的得分分布重新校准。
很多RAG教程一上来就让你上向量数据库、分块框架和嵌入API。但对于个人简历这种小语料,这些并非架构必需,而是额外的维护负担。本文作者在构建JobCopilot时,用fastembed生成嵌入、numpy做检索,整个流程约60行代码,并记录了一个从教程复制来的TOP_K=12默认值如何悄悄破坏检索质量。
一、构建索引:分块与嵌入一次完成
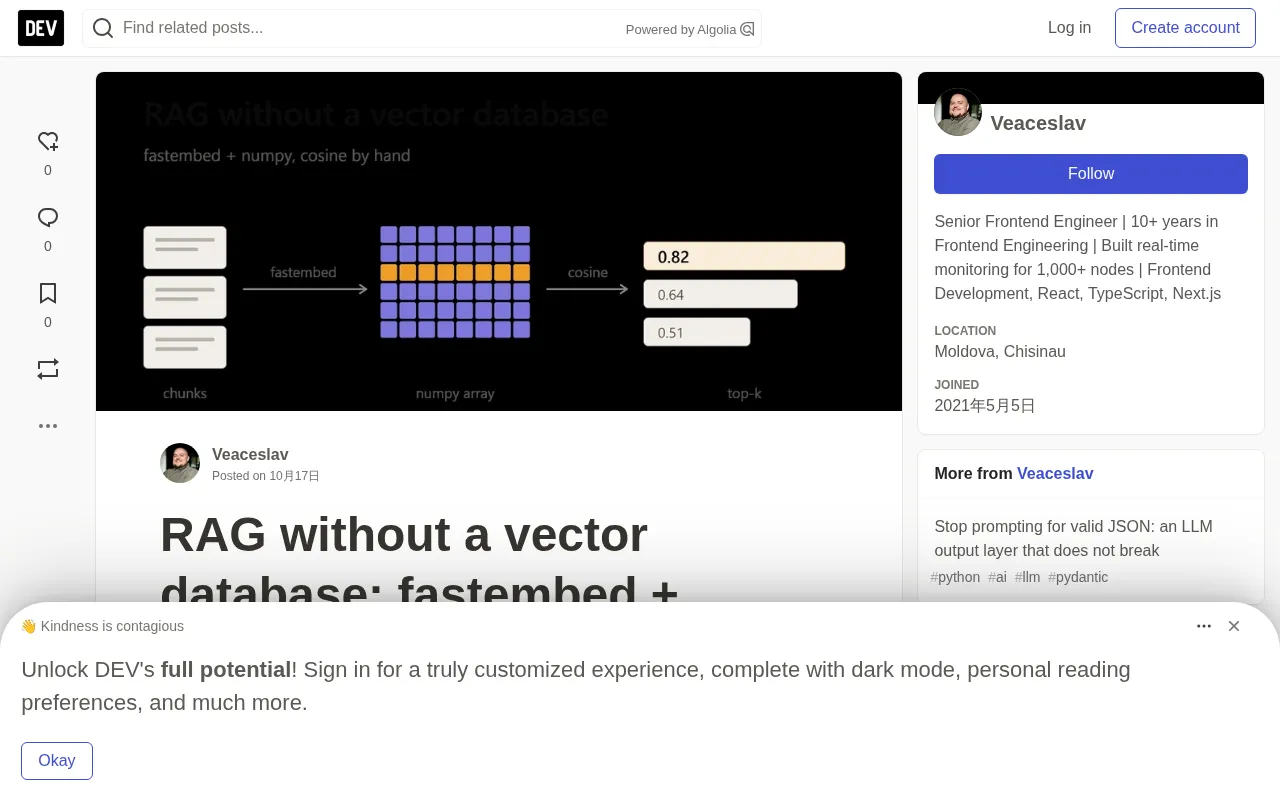
索引侧的工作量小得惊人。作者写了一个一次性脚本:用正则按##标题切分简历,每个章节作为一个块;用BAAI/bge-small-en-v1.5模型生成384维向量(磁盘占用约33MB,纯CPU运行,无需API密钥);在构建时立即对向量做归一化,存入JSON文件。
re.split(r"\n(?=## )", md)一行正则完成分块,标题保留在正文中,空标题被丢弃。- 模型采用懒加载,只在首次使用时载入,避免导入时产生开销。
- 归一化放在构建时而不是查询时,是为了让运行时的余弦相似度退化为一次点积。
作者的关键认知转变是:“如果一条命令就能重新生成索引,那它就不是基础设施,而是构建产物。”这消解了RAG的神秘感。
二、运行时检索:10行代码,一次矩阵乘法
查询端是整个检索引擎的核心,代码极简:加载JSON存储,对查询文本做嵌入并归一化,然后执行scores = emb @ q,再用argsort取前K个。emb形状为(n_chunks, 384),q为(384,),一次矩阵乘法就把查询广播到所有块上。
不引入向量数据库的理由很直白:在块数为个位数时,整个“索引”就是一个矩阵,全扫描只需一次矩阵乘法,耗时在微秒级。近似最近邻索引在数十万向量时才体现速度优势,代价是召回误差和额外服务。在个人简历的规模下,这种权衡是反向的——复杂度换来了你不需要的速度。
作者用查询“Kubernetes, Terraform, SRE on-call”对一个6块的演示简历做了测试,得分呈现清晰的分离:相关块0.784,其余在0.573到0.487之间。这种“相关块从噪声带中脱颖而出”的形状,正是检索有用的前提。
三、教程给的坑:TOP_K 过大让排序退化为批量加载
作者坦言,第一版检索用了TOP_K = 12,因为教程里是这么写的。这看起来“更稳健”——多抓一些,让LLM自己判断相关性。但实际效果相反。
失败是无声的:没有崩溃,没有警告。argsort()[::-1][:12]只是返回十二个块:一个真正匹配职位描述的,加上十一个匹配“简历和职位描述这类文体”的通用内容——Python关键词、泛泛的简历套话。这些尾部噪声被塞进提示词,而LLM会自信地把它们写进缺失技能清单。垃圾进,自信的垃圾出。
得分线揭示了问题:在真实存储上,顶部得分0.635,尾部只有0.450,0.185的差距中只有第一行值得关注,0.55以下全是噪声带。检索已经不再排序,而是用更多步骤做批量加载。
修复只需一行:TOP_K = 8。调整后,顶部得分0.635,第二行0.592,列表末尾的语言/教育块得分低于0.45,顶部重新出现可见的分离。
作者总结出一条规则:TOP_K必须小到让最高分与其余分数之间保持可见的差距。一旦差距消失,检索就成了装饰,提示词就成了消防水管。 教程不会告诉你这些——完全正确的代码仍然可能是错的,因为你复制的常量是为别人的规模调优的。
四、从排序块到提示词:字符预算与整块截断
检索返回带分数的排序块,提示词需要单个字符串。朴素拼接有两个失败模式:某个超长章节吃掉提示词的注意力预算;以及[:2400]切片把某个块拦腰截断,半条项目符号漂浮在提示词里。
build_context函数用两个细节解决:
- 达到
max_chars即停止,即使这导致用不满TOP_K个块。这是提示词质量旋钮,不是存储配额:2400个精选字符胜过6000个什么都有的字符。 - 在块边界截断。放不下的块整个跳过,不产生半截内容。
作者还测试了bge模型文档中提到的查询前缀“Represent this sentence for searching relevant passages:”。结果最高分提升0.014,但与第二名的差距反而缩小——对排序是白费功夫。因此这条流水线没有查询前缀工程,归一化是唯一值得保留的技巧。
五、小规模检索的启示
整条流水线——按标题分块、用33MB模型嵌入一次、构建时归一化、运行时emb @ q、取前8、按字符预算拼接——约60行代码,而且每一行作者都理解,这比一个他还不需要的向量数据库更有价值。
三个可迁移的经验:
- 对小语料,“向量存储”就是一个JSON文件加一次矩阵乘法。教程不会告诉你何时该用更重的东西——你自己的得分差距会告诉你。
- 复制来的默认值带着原作者的规模。
TOP_K = 12在教程的语料里没问题,在作者的简历里却悄悄有害。 - 最诚实的指标不是最高分,而是最高分与次高分之间的差距。差距没了,下游一切都不重要。
对于正在构建小型RAG应用的开发者,这套方案提供了一个可运行的基线:先用手写余弦相似度跑通,等到得分差距和规模真正需要时,再考虑引入向量数据库。
相关推荐

房产经纪人用AI提效的5个实操方法(2026版)
房产经纪人如何用AI提效?结合YouTube实操演示,拆解ChatGPT写房源描述、Canva做营销物料、表单管理开放日线索、Zapier自动跟进、卖家面谈准备5个方法,并提示公平住房法规、照片真实性与定价核实等风险边界。

Grok Bot vs ChatGPT Agent:两大AI代理谁更强?
Grok Bot 与 ChatGPT Agent 有何区别?本文对比两者的工作方式:Grok Bot 拥有云端计算机、可常驻工具内自动执行多步任务;ChatGPT Agent 在浏览器中操作网页,通用任务更成熟。附选型建议。
Walmart Agent Gateway:AI帮你自动购物,亚马逊为何反其道而行?
沃尔玛推出Agent Gateway,允许ChatGPT、Gemini等AI助手直接接入商品库替用户搜索比价加购,并设消费限额与逐笔审批三道安全阀。亚马逊则封堵外部AI代理,两大零售巨头走向相反路线。功能目前仅限美国,印度市场或随后跟进。